Module 2 · Reflection 反思模式
原始对话 · 2026-10-29 归档这里保留当时的提问和 ChatGPT 的回答,回答未逐条核实;学习页是另行核对后的解释。
主观任务怎样评估
分析这张图
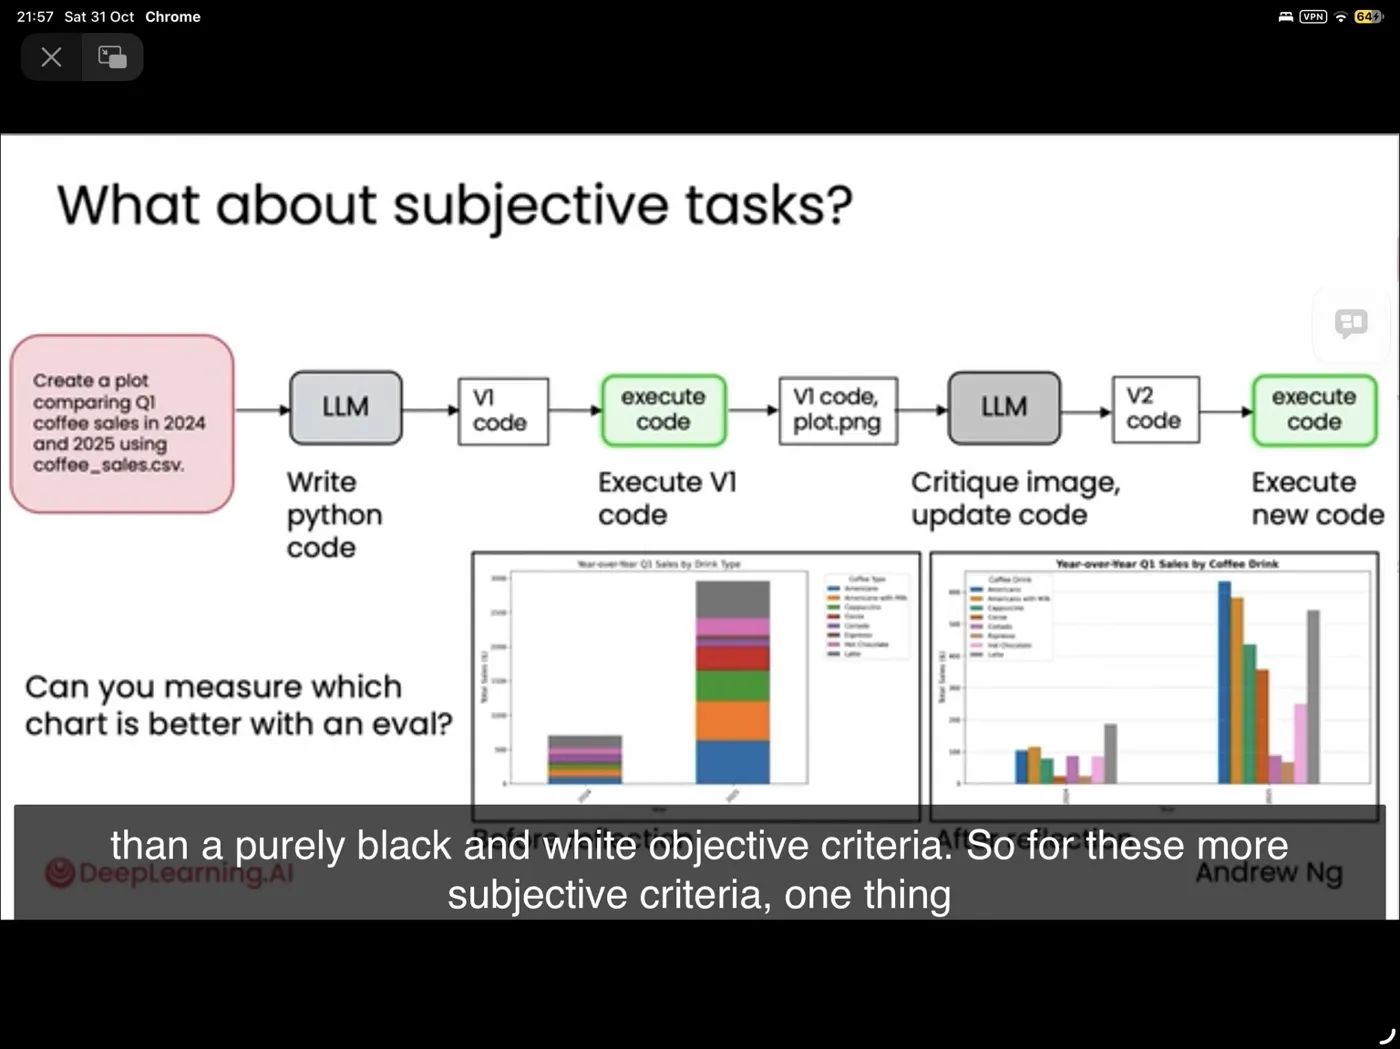
这张图来自吴恩达的 Agentic AI — Evaluating Agentic AI(Evals) 课程。
它讨论了一个很重要的问题:
当 AI 完成的任务没有唯一正确答案时,我们应该如何评估它的表现?
这与你熟悉的产品设计评审很接近,因为很多设计问题并不是简单的对或错。
一、What:这张图在讲什么?
图中展示了一个 AI Agent 自动生成数据可视化,并对自己的结果进行改进的过程。
这个流程体现了你在前面学习过的 Reflection(反思与迭代) 模式。
AI 不只是生成一次结果,而是可以检查结果,再进行改进。
二、Why:为什么这里要讨论 Subjective Tasks?
截图里展示了两个图表:
两张图可能都能正确展示数据,但哪张更好?
这取决于评估目标。
- 如果要比较两个年份的总销量,V1 可能更直观。
- 如果要比较不同咖啡品类的年度变化,V2 可能更合适。
所以,图表的正确性可以相对客观地验证,但图表的可读性、适用性和视觉质量具有一定主观性。
这就是截图中的核心问题:
Can you measure which chart is better with an eval?
能不能用一个评估机制,判断哪张图更好?
三、How:如何评估这种主观任务?
这里需要区分两类 Evals。
| 评估类型 | 判断什么 | 例子 |
|---|---|---|
| Objective Evals(客观评估) | 是否满足明确、可验证的条件 | 代码能否运行?数据是否正确?文件是否生成? |
| Subjective Evals(主观评估) | 结果在多大程度上满足质量标准 | 图表是否清晰?是否易于比较?视觉层级是否合理? |
主观任务不意味着无法评估。
我们可以把相对模糊的“好不好”,拆成更具体的评价维度。
例如,下面是我根据这个图表任务设计的一个示例评估表,并非视频给出的评分标准。
四、这与 AI Agent 有什么关系?
这是本节课最值得你理解的部分。
在普通软件中,我们经常能用确定的条件测试功能是否成功。
例如:点击按钮 → 下载文件 → 检查文件是否存在。
但 Agentic AI 可能要执行更加开放的任务,例如:
“研究市场并生成一份高质量报告。”
报告生成了,不代表报告质量就好。
因此,Agentic Workflow 不仅需要:
Generate → Execute
还可能需要:
Generate → Execute → Evaluate → Improve
不过,Eval 不一定必须由另一个 LLM 完成。它可以是自动化测试、规则检查、LLM 评审、人类专家评价,或者这些方法的组合。
尤其要注意:AI 自己认为第二版更好,不等于第二版客观上一定更好。 评估标准本身也需要验证。
五、联系你的产品设计经验
你以前在做产品界面时,可能也经历过类似过程:
设计 V1 → 检查信息层级 → 发现可读性问题 → 修改为 V2。
现在 AI Agent 也可以执行一部分这样的迭代流程。
但你作为设计师,需要决定什么才算“更好”,例如:
- 是否减少认知负担?
- 是否提升任务完成效率?
- 是否符合产品的设计系统?
- 是否保持信息准确性?
这些标准可以成为 Agent 的评价依据,而不只是让它凭模糊的“美观程度”进行修改。
最后,用一道题检查理解
你在 Module 1 的 Evals 部分,最应该记住的一句话:
Evals are not just about whether an AI agent completes a task, but how well it completes it.
评估 Agent,不仅要看它有没有完成任务,还要看它完成得怎么样。
用 Rubric 评分
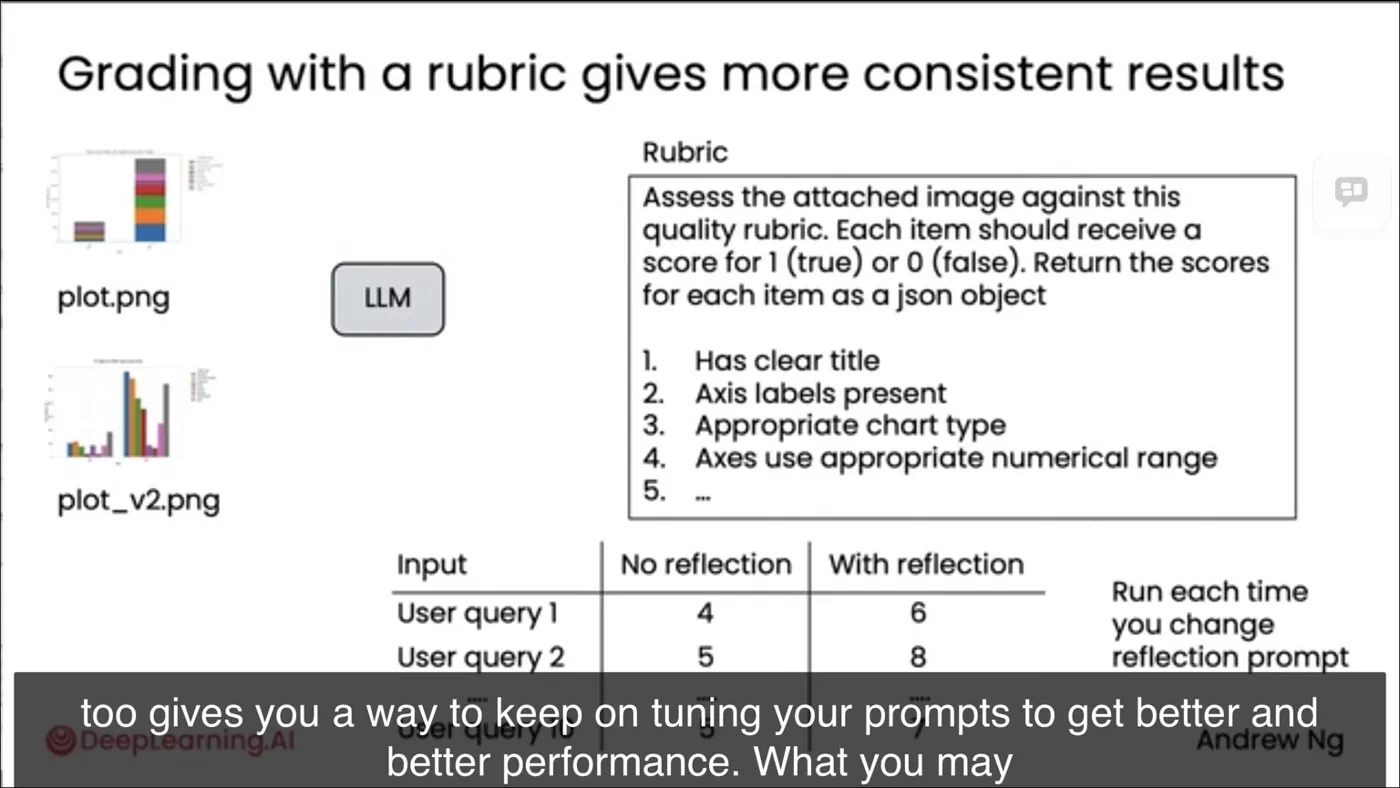
这张图其实是在回答你上一张截图留下的问题:
如果 AI 要评价一张图表好不好,怎样才能让它每次评价都有相对一致的标准?
吴恩达这里引入了一个重要概念:Rubric(评分量规 / 评价标准表)。
一、What:什么是 Rubric?
Rubric 是一套事先定义好的、可重复使用的评价标准。
比如,直接让 LLM 评价:
Is this chart good?(这张图表好吗?)
这个问题太模糊。LLM 可能第一次关注美观,第二次关注数据准确性,第三次又关注图表类型。
而截图中,吴恩达给 LLM 提供了明确的评价标准:
| Rubric 评价标准 | 含义 | 得分 |
|---|---|---|
| Has clear title | 图表有清晰的标题吗? | 0 或 1 |
| Axis labels present | X、Y 轴有标签吗? | 0 或 1 |
| Appropriate chart type | 图表类型适合任务吗? | 0 或 1 |
| Axes use appropriate numerical range | 坐标轴的数值范围合理吗? | 0 或 1 |
| ... | 其他评价标准 | 0 或 1 |
其中,1 代表满足标准,0 代表不满足。
这样,LLM 不再只是笼统地说“图表不错”,而是逐项检查。
二、How:Rubric 如何参与 AI Agent 的评估?
{
  "clear_title": 1,
  "axis_labels": 1,
  "appropriate_chart_type": 0,
  "appropriate_axis_range": 1
}这里还有一个值得理解的术语:LLM-as-a-Judge。
意思是让大语言模型充当评价者,而不只是内容生成者。
Rubric 是评价标准,LLM-as-a-Judge 是执行评价的一种方式。两者并不是同一个概念。
三、Why:为什么吴恩达强调 Consistency(一致性)?
因为 Agent 的评估应该尽量具有可重复性。
截图底部有一个比较表:
| 输入 | No Reflection | With Reflection |
|---|---|---|
| User Query 1 | 4 | 6 |
| User Query 2 | 5 | 8 |
这说明在展示的测试案例中,加入 Reflection 后,评分有所提高。
但这里有两个重要区别:
- Reflection 是 Agent 改进结果的机制。
- Rubric-based Eval 是衡量改进是否有效的机制。
因此,你可以修改 Reflection Prompt,再用同一套 Rubric 重新评估不同任务的结果。
这就是截图右下角所说的:
Run each time you change reflection prompt.
每次修改 Reflection Prompt,都重新运行评估。
不过,Rubric 只能帮助提高评价一致性,并不能保证 LLM 每次评分完全相同,也不能自动保证评分正确。
四、与你的设计工作有什么联系?
你可以把 Rubric 理解成一种可执行的设计评审标准。
例如,你用 Claude Code 开发 AI Learning Atlas 的学习页面,可以制定这样的 Rubric:
这样,你可以要求 Claude Code 每次修改页面后,不只是告诉你“已经完成”,还要依据这些标准进行检查。
当然,设计评价中还有一些难以完全量化的部分,比如整体视觉感受、产品语境与用户体验。它们仍然需要人工判断或更细致的评估方式。
五、你在这节课真正需要掌握什么?
我认为只需要记住三个关系:
Reflection = 改进机制
让 AI 检查、反思并修改自己的输出。
Rubric = 评价标准
定义什么样的输出才算好。
Eval = 评估过程
使用 Rubric 等标准和方法,衡量 Agent 的表现。
三者结合,就形成一个可以持续优化的 Agentic Workflow。
最后留给你一个理解题:
如果一个 Agent 的 Rubric 得分从 6 提高到了 9,是否就能证明这个 Agent 真的变得更好了?
答案是:不一定。 还需要判断 Rubric 是否合理、评分是否可靠,以及这些指标是否真正反映用户的目标。
这也是从“会使用 AI”走向“会设计和评估 AI 系统”非常关键的一步。
用工具帮助反思
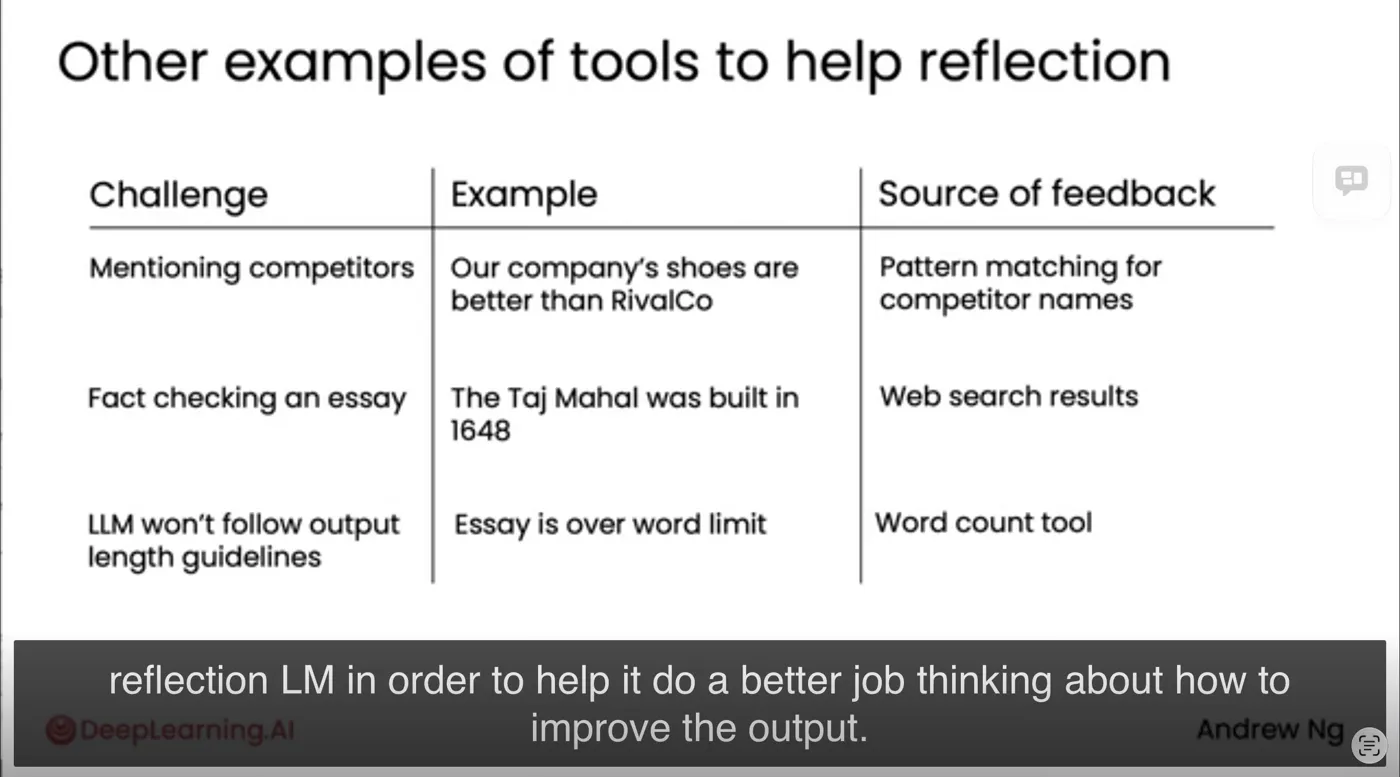
这张图是吴恩达在 Reflection(反思机制) 这一节的进一步延伸。
前面他讲的是:让 LLM 根据 Rubric(评分标准)评价自己的输出。
而这张图想表达的是:
Reflection 不一定只依赖 LLM 自己的判断,还可以借助外部工具提供更可靠的反馈(Feedback)。
一、What:这张图讲了什么?
截图展示了三种问题,以及可以帮助 AI 发现问题的工具。
| Challenge(问题) | Example(例子) | Source of Feedback(反馈来源) |
|---|---|---|
| 提到了竞争对手 | 我们公司的鞋子比 RivalCo 好 | 名称模式匹配 |
| 文章中的事实可能不准确 | 泰姬陵建于 1648 年 | 网页搜索结果 |
| LLM 不遵守字数限制 | 文章超过字数上限 | 字数统计工具 |
注意:第二行的 1648 年是一个需要核查的陈述,截图并没有证明这个年份正确。
二、How:工具如何帮助 Reflection?
以第三个例子为例,假设用户要求 AI 写一篇不超过 200 词的文章。
- LLM 生成文章
- Feedback
- Reflection & Revision
这里的 245 词是我为了说明流程举的例子。
最重要的区别是:
- 没有工具: LLM 自己判断文章是否超字数,可能不准确。
- 有工具: 字数统计工具提供明确的数字,LLM 再根据结果修改文章。
三、Why:为什么不能只让 LLM 自己 Reflection?
因为 LLM 并不擅长所有类型的检查。
例如,LLM 可以评价文章是否通顺,但如果要判断某个历史年份是否准确,就可能需要查询外部资料。
同样,LLM 可以判断图表是否容易理解,但如果要检查代码能不能运行,实际执行代码并读取错误信息通常更可靠。
因此:
LLM 负责理解反馈、决定如何修改;工具负责提供可验证的反馈信号。
不过工具本身也有局限。例如,网页搜索结果仍然需要核查来源的可信度,名称匹配也可能漏掉没有直接出现的竞争对手名称。
四、与上一张 Rubric 的关系
你可以这样建立知识框架:
| 概念 | 核心作用 |
|---|---|
| Reflection | 让 Agent 检查并改进自己的输出 |
| Rubric | 定义评价标准 |
| Eval | 衡量输出是否符合要求 |
| Tool Feedback | 通过外部工具提供检查依据 |
它们不是四个互相独立的步骤,而是可以组合起来使用。
例如,在你用 Claude Code 开发网站时,代码执行错误、TypeScript 检查、自动化测试结果都可以成为 Reflection 的反馈来源。AI 可以依据这些反馈修复代码,而不只是反复猜测问题。
五、检查一下你是否真正理解
这张图的核心知识点可以总结成一句话:
Reflection improves the output, while external tools provide evidence for what needs to be improved.
反思负责改进输出,外部工具则提供判断哪里需要改进的依据。