JSON、Schema 与工具参数
原始对话 · 2026-10-29 归档这里保留当时的提问和 ChatGPT 的回答,回答未逐条核实;学习页是另行核对后的解释。
JSON、Schema 与工具调用
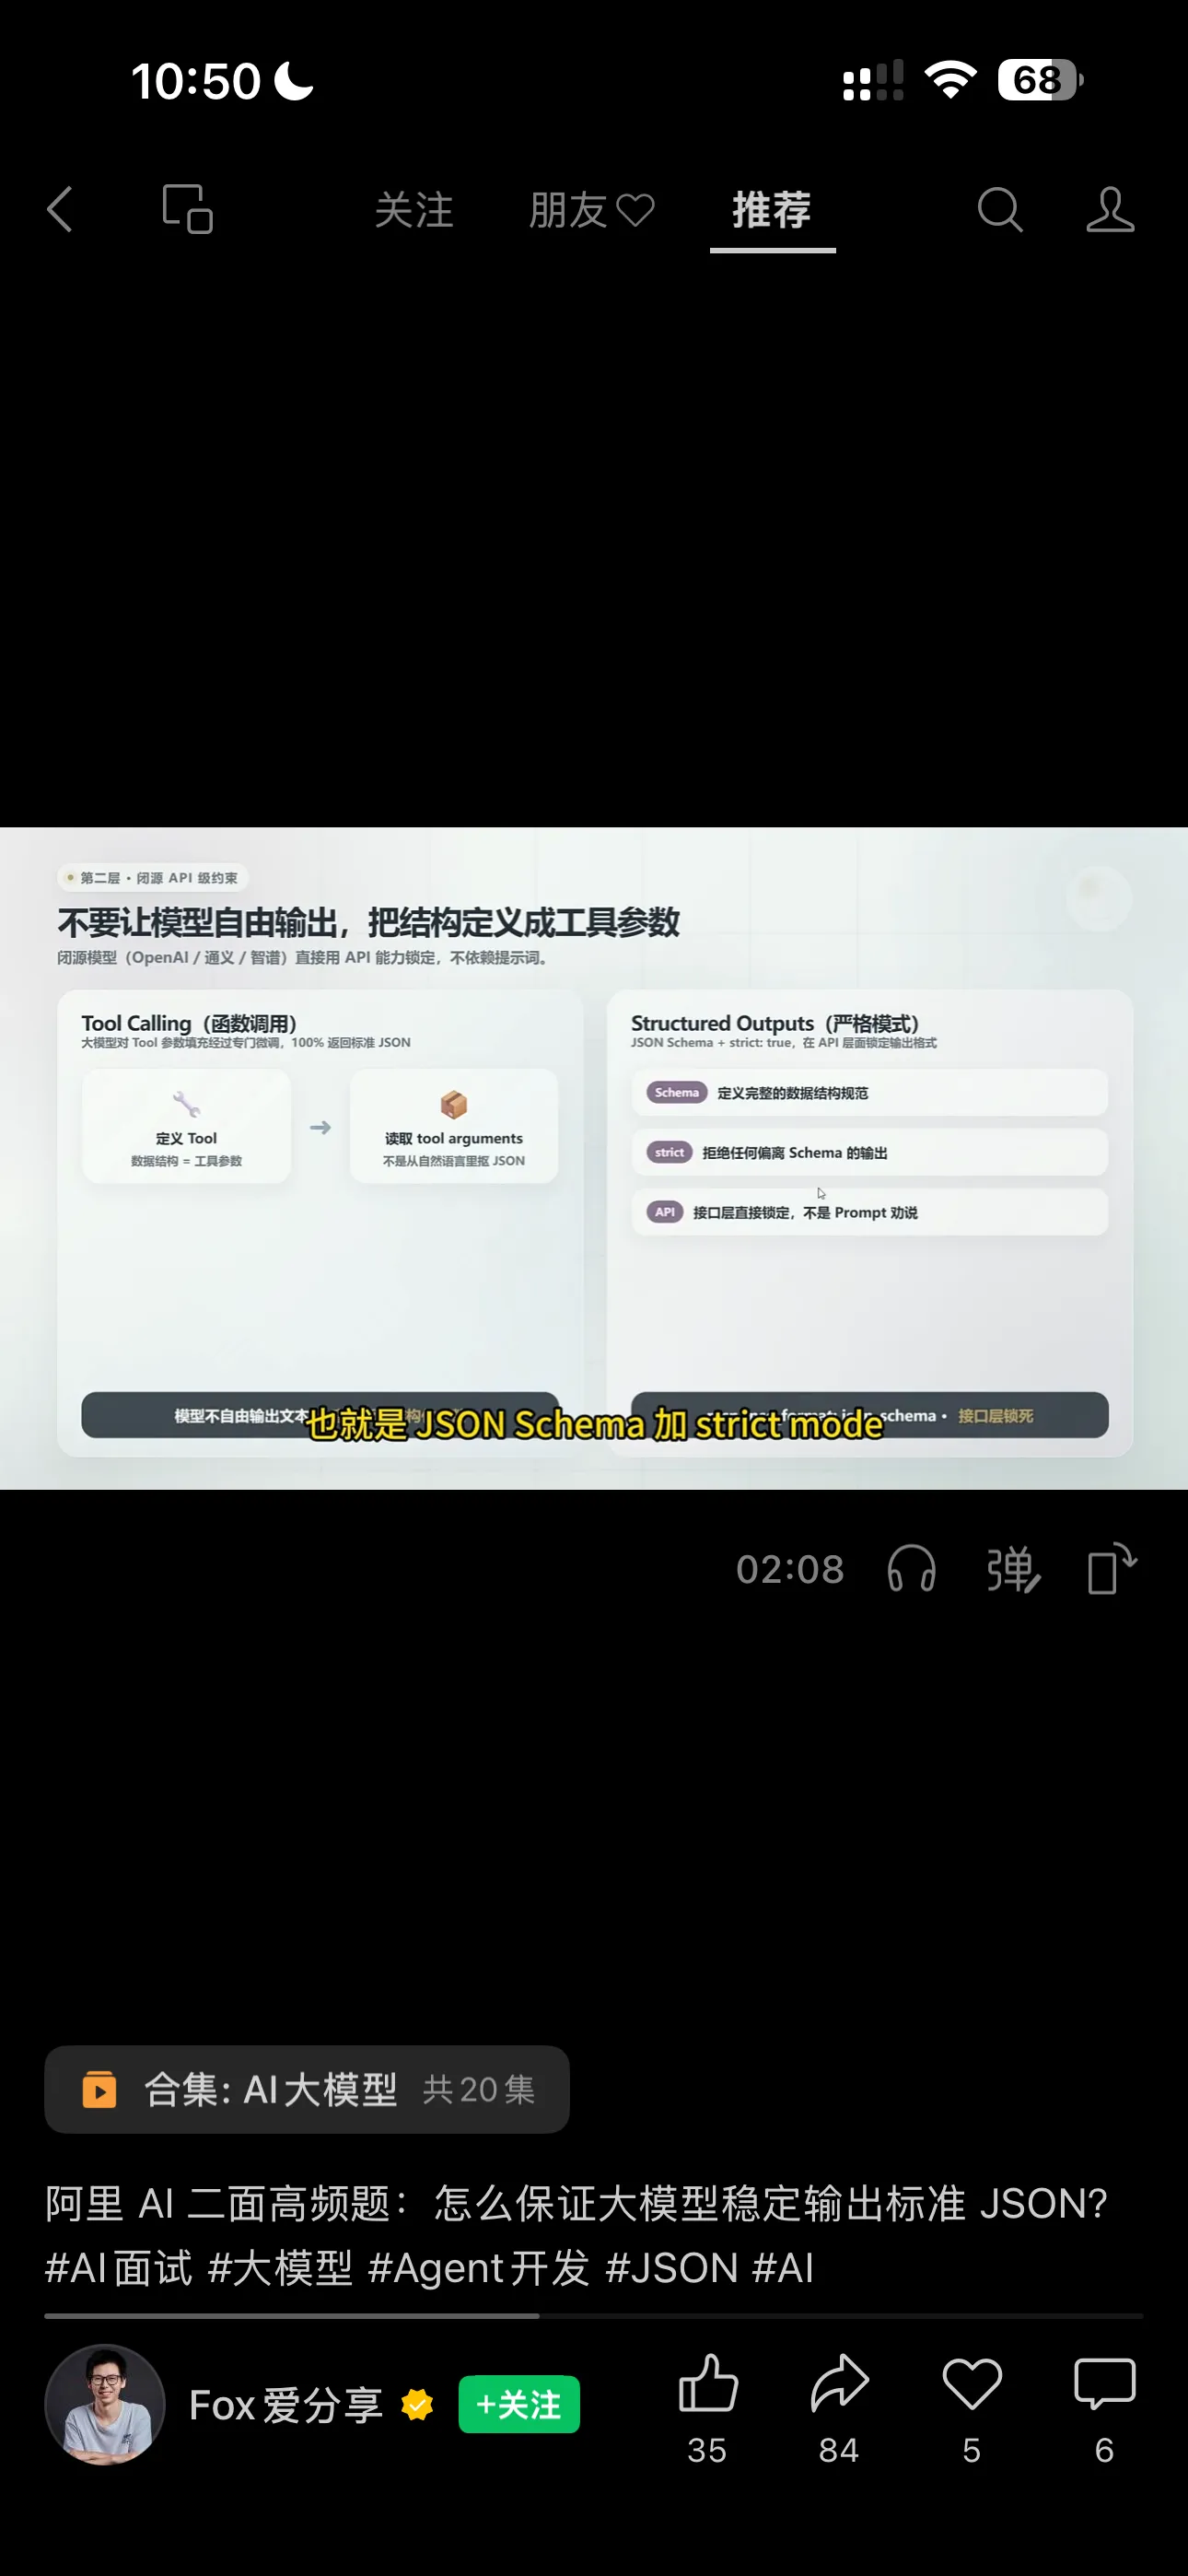
帮我解释一下这里面的技术问题,尤其是类似J.son这种,我在vibe coding经常上看到的格式
可以。你截图里讲的其实是一个很典型的 “AI 从自然语言世界进入软件工程世界时,如何保证数据可靠” 的问题。
你在 Vibe Coding 里经常看到 JSON、Schema、API、Tool Calling、Pydantic,这几个东西其实属于同一条链路。把这条链路弄明白,比单独背“JSON 是什么”有用得多。
先从 JSON 开始:它其实非常简单
JSON 全称是 JavaScript Object Notation。
你可以先把它理解成:
一种让不同程序都能看懂的、结构化的信息格式。
例如你对 Claude/Codex 说:
帮我创建一个项目,名字叫 GC Dashboard,状态是开发中。
人类很容易理解。
但程序更喜欢收到:
{
  "project": "GC Dashboard",
  "status": "in_progress"
}
这就是 JSON。
你在 Vibe Coding 中可能还经常看到:
{
  "title": "AI Xiaozhao",
  "type": "case-study",
  "year": 2026,
  "featured": true,
  "tags": ["AI", "UX", "Enterprise"]
}
它其实就是:
| JSON | 意思 |
|---|---|
"title" | 字段名 |
"AI Xiaozhao" | 字符串 String |
2026 | 数字 Number |
true | 布尔值 Boolean |
["AI", "UX"] | 数组 Array |
{ ... } | 对象 Object |
所以以后看到 .json,不要把它想成“程序代码”。
它更接近一个标准化的数据表/信息包。
为什么 AI Agent 特别需要 JSON?
这里就进入你截图真正讨论的问题了。
假设你让 AI:
找到我的项目,然后把项目名称、年份、类型返回给程序。
LLM 本质上是一个语言模型。
所以它很可能回答:
好的!我找到了这个项目。
项目名称是 AI Xiaozhao,大约是在 2025 年完成的,它属于 AI UX 项目。
人类觉得完全没问题。
程序却可能直接崩。
因为程序期待的是:
{
  "name": "AI Xiaozhao",
  "year": 2025,
  "type": "AI UX"
}
结果 AI 给了一段散文。
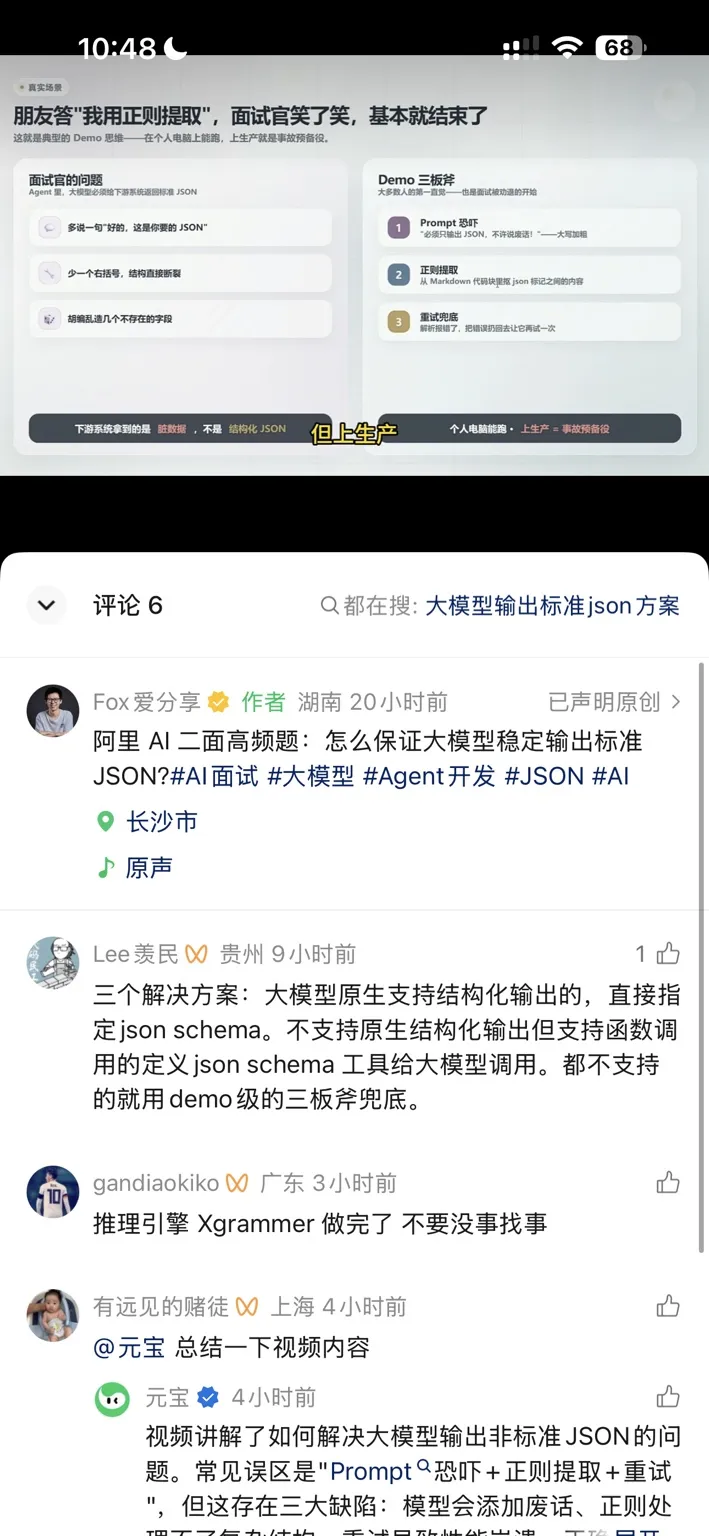
这就是截图里说的:
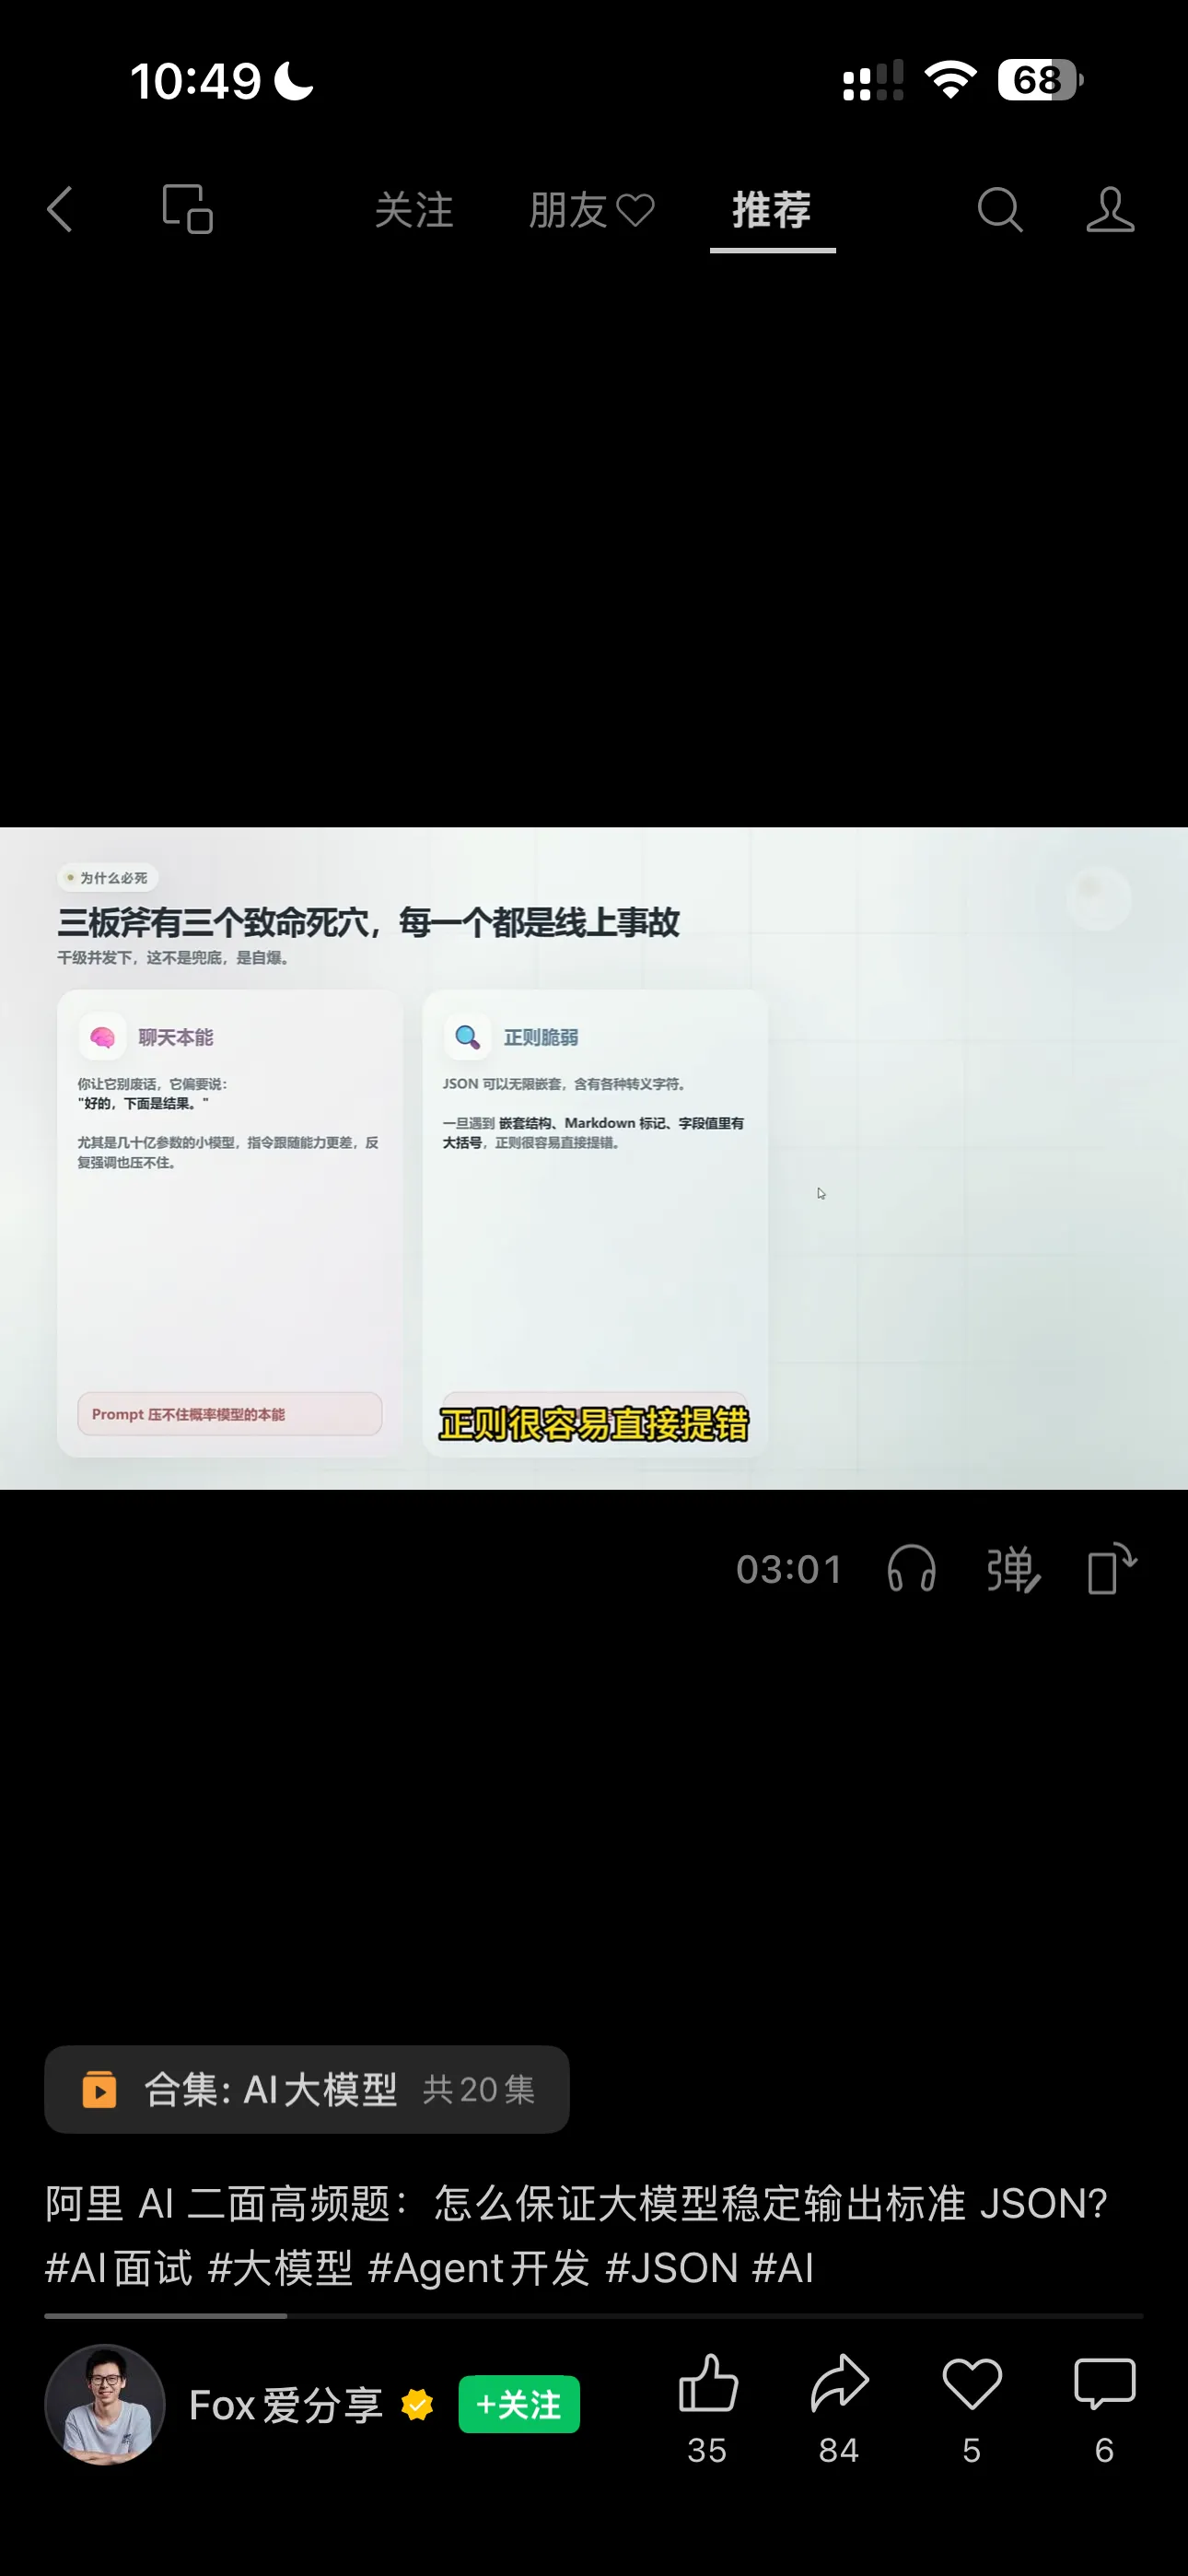
“聊天本能”
LLM 天生擅长生成语言,而软件系统需要的是确定的数据结构。
那 Prompt 要它“只输出 JSON”不就行了吗?
这正是截图里批评的第一种方案。
你可以写:
Only output valid JSON.
Do not include explanations.
大多数时候确实有效。
但问题是:“大多数时候”对于生产系统不够。
AI 可能突然:
Sure! Here is the JSON:

{
  "name": "AI Xiaozhao"
}
那个:
Sure! Here is the JSON:
就可能导致解析失败。
或者它输出:
{
  "year": "twenty twenty five"
}
语法可能没问题,但你的程序要求:
{
  "year": 2025
}
也就是:
Prompt 是“告诉模型应该怎么做”;不是程序层面的强约束。
这就是视频为什么说:
Prompt + 正则提取 + 重试
属于比较脆弱的 Demo 方案。
Schema 又是什么?
这个概念对你很重要。
Schema = 数据结构的规则/合同。
如果 JSON 是:
“这是一个包裹。”
Schema 就是:
“这个包裹里面必须有什么、每样东西是什么类型。”
例如:
{
  "name": "AI Xiaozhao",
  "year": 2025
}
对应规则可能是:
name → 必须是 string
year → 必须是 integer
所以:
{
  "name": 123,
  "year": "last year"
}
就不符合 Schema。
你可以把它理解成设计系统里的 component spec:
Button 可以变化,但必须遵守规定好的结构。
Schema 干的是类似的事,只不过约束的是数据。
JSON Schema = 给 JSON 写设计规范
这就是截图里出现的:
JSON Schema + strict mode
例如你告诉模型:
必须返回:

name: string
year: integer
status: "draft" | "published"
于是合法结果只能类似:
{
  "name": "GC Dashboard",
  "year": 2026,
  "status": "draft"
}
而:
{
  "name": "GC Dashboard",
  "year": "今年",
  "status": "almost finished"
}
就不符合定义。
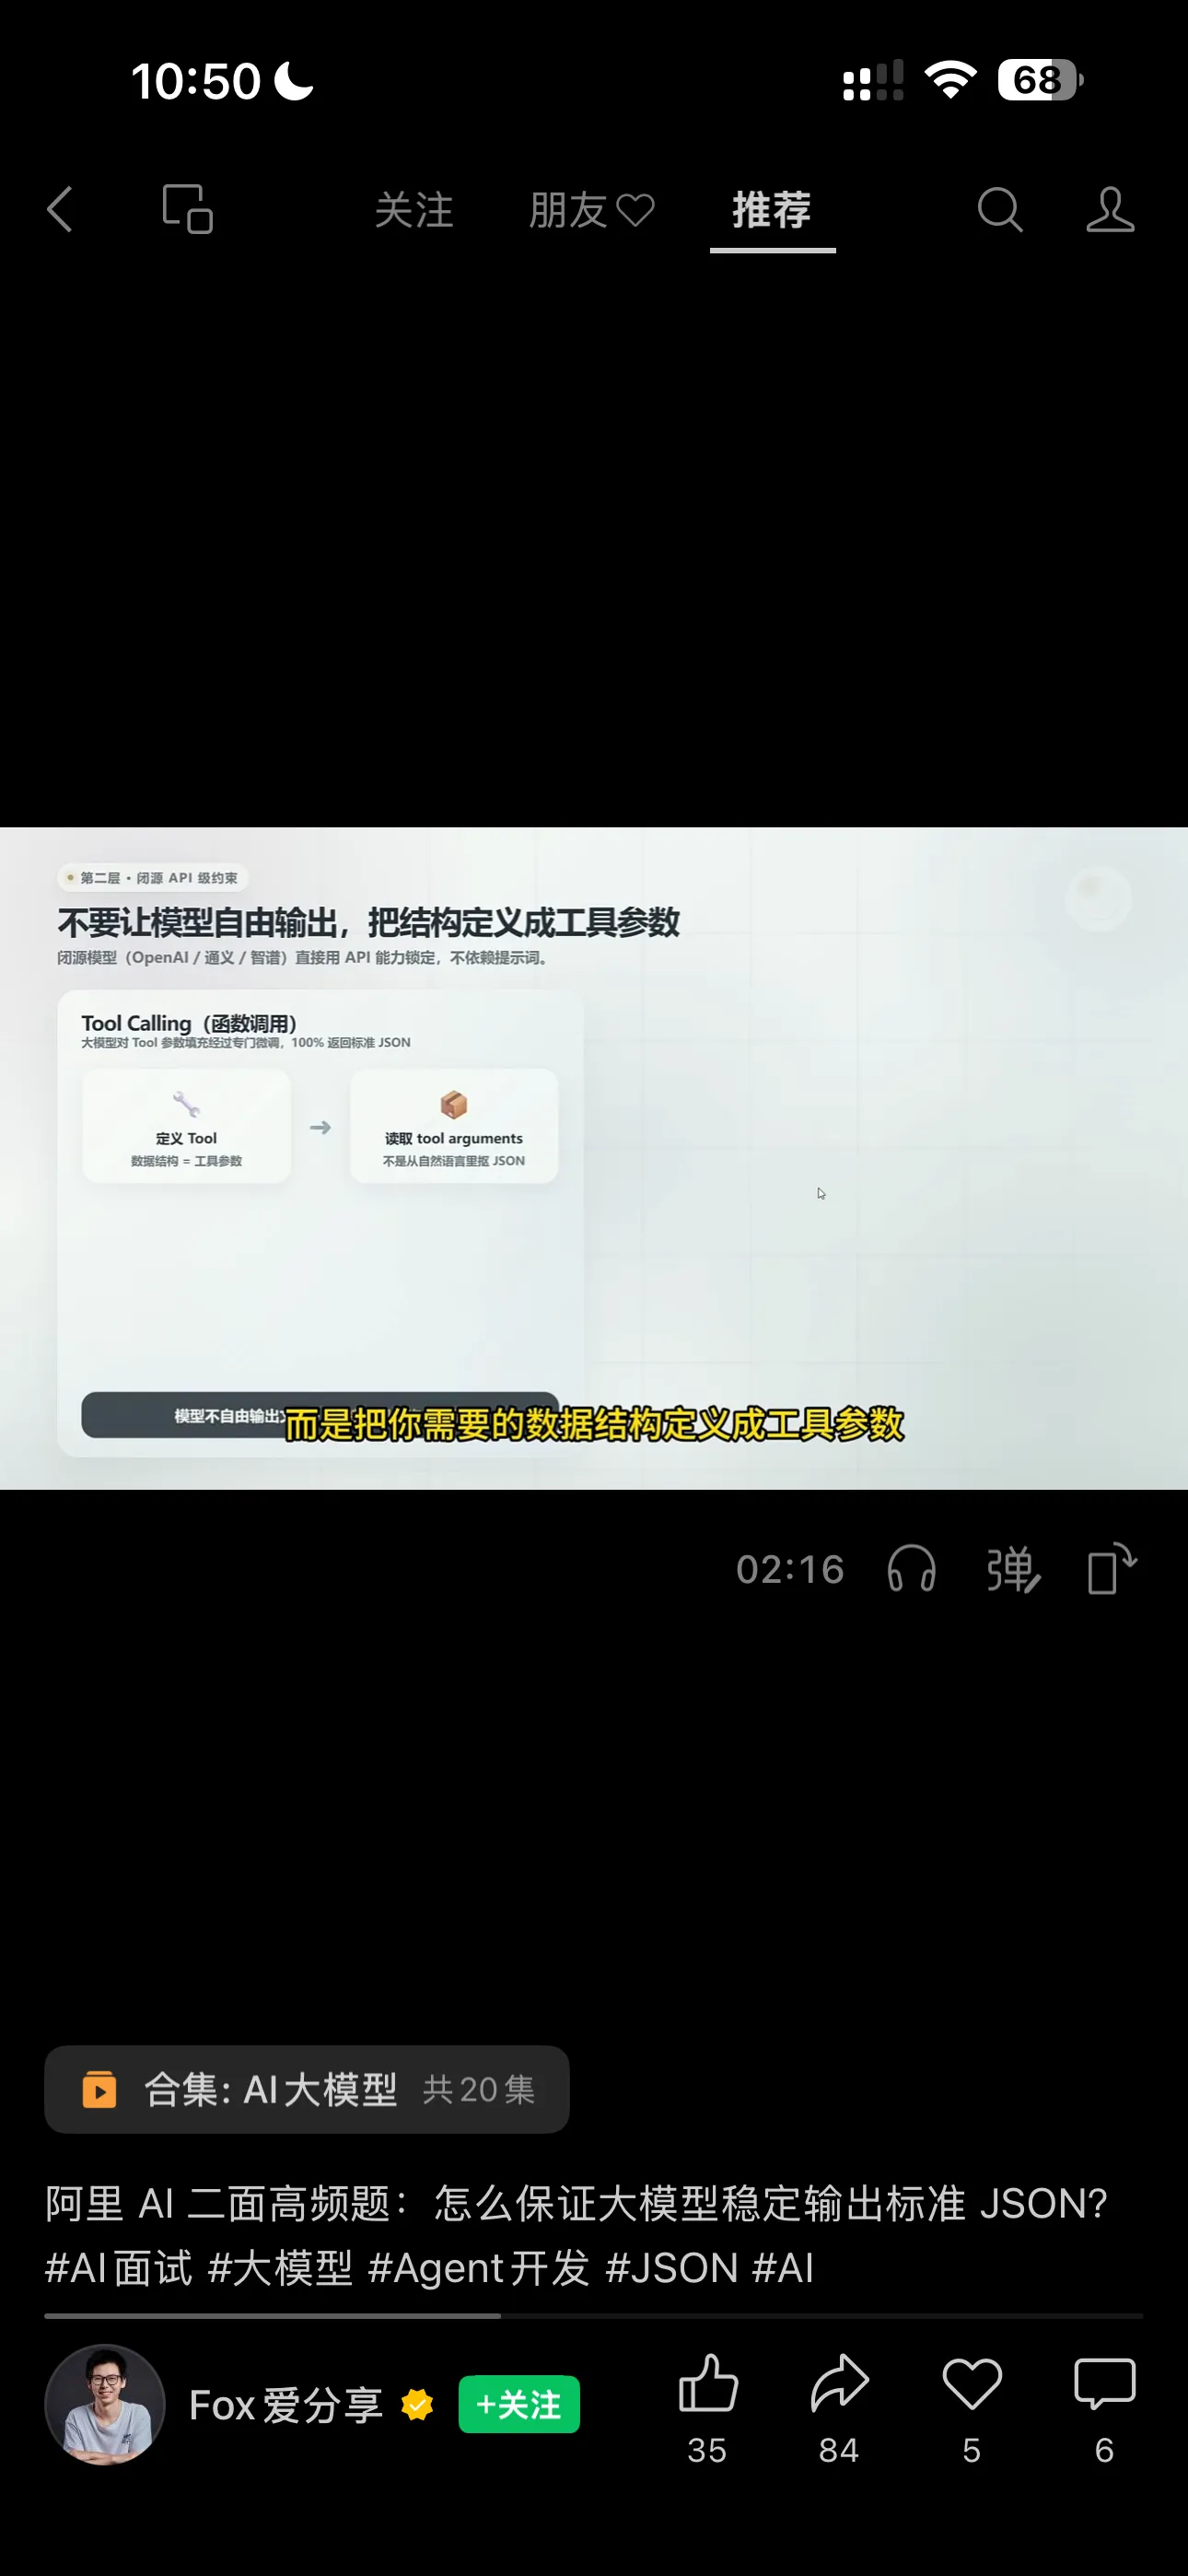
所以视频里那句话:
“不要让模型自由输出,把结构定义成工具参数。”
核心思想非常重要:
把 AI 从“请你听话”变成“你只能通过规定好的接口交东西”。
Tool Calling 又是什么?
这和你现在用 Claude Code / Codex / Agent 特别相关。
假设 Agent 有一个工具:
create_file
这个工具规定:
{
  "path": "string",
  "content": "string"
}
当 AI 决定创建文件时,它不是说:
“好的,我准备创建一个叫 page.tsx 的文件……”
而是产生类似:
{
  "path": "src/app/page.tsx",
  "content": "..."
}
程序拿到这些参数,然后真正执行创建文件的操作。
所以:
LLM 决定做什么 → Tool Calling 把决定结构化 → Tool 真正执行。
这也是 Agent 和普通 Chatbot 的一个关键区别。
你可以把整个 Vibe Coding Agent 想成这一条链
这是最值得你建立的认知:
你
↓
Natural Language
“把 Hero 标题改小一点”
↓
LLM
理解你的意图
↓
Structured Data / JSON
{
  "file": "Hero.tsx",
  "action": "edit",
  "target": "heading"
}
↓
Tool / API
读取文件、修改代码
↓
程序执行
↓
Result
↓
LLM
“修改完成”
当然真实的 Codex / Claude Code 实现比这个复杂得多,但作为你的认知模型,这已经非常好用了。
那 API 又是什么?
这个词你也会不断遇到。
API 可以简单理解成:软件与软件之间规定好的沟通入口。
例如你的网站想获取天气:
你的网页
   ↓
Weather API
   ↓
天气公司的服务器
服务器可能返回:
{
  "city": "London",
  "temperature": 19,
  "condition": "cloudy"
}
注意到了吗?
又是 JSON。
所以你会感觉自己做 Vibe Coding 时 JSON 无处不在。
因为现代软件大量存在:
Frontend
↕
API
↕
Backend
↕
Database
↕
AI Model
↕
Tools
这些不同系统之间都需要交换信息。
JSON 恰好成为非常普遍的“共同语言”。
Pydantic 又是什么?
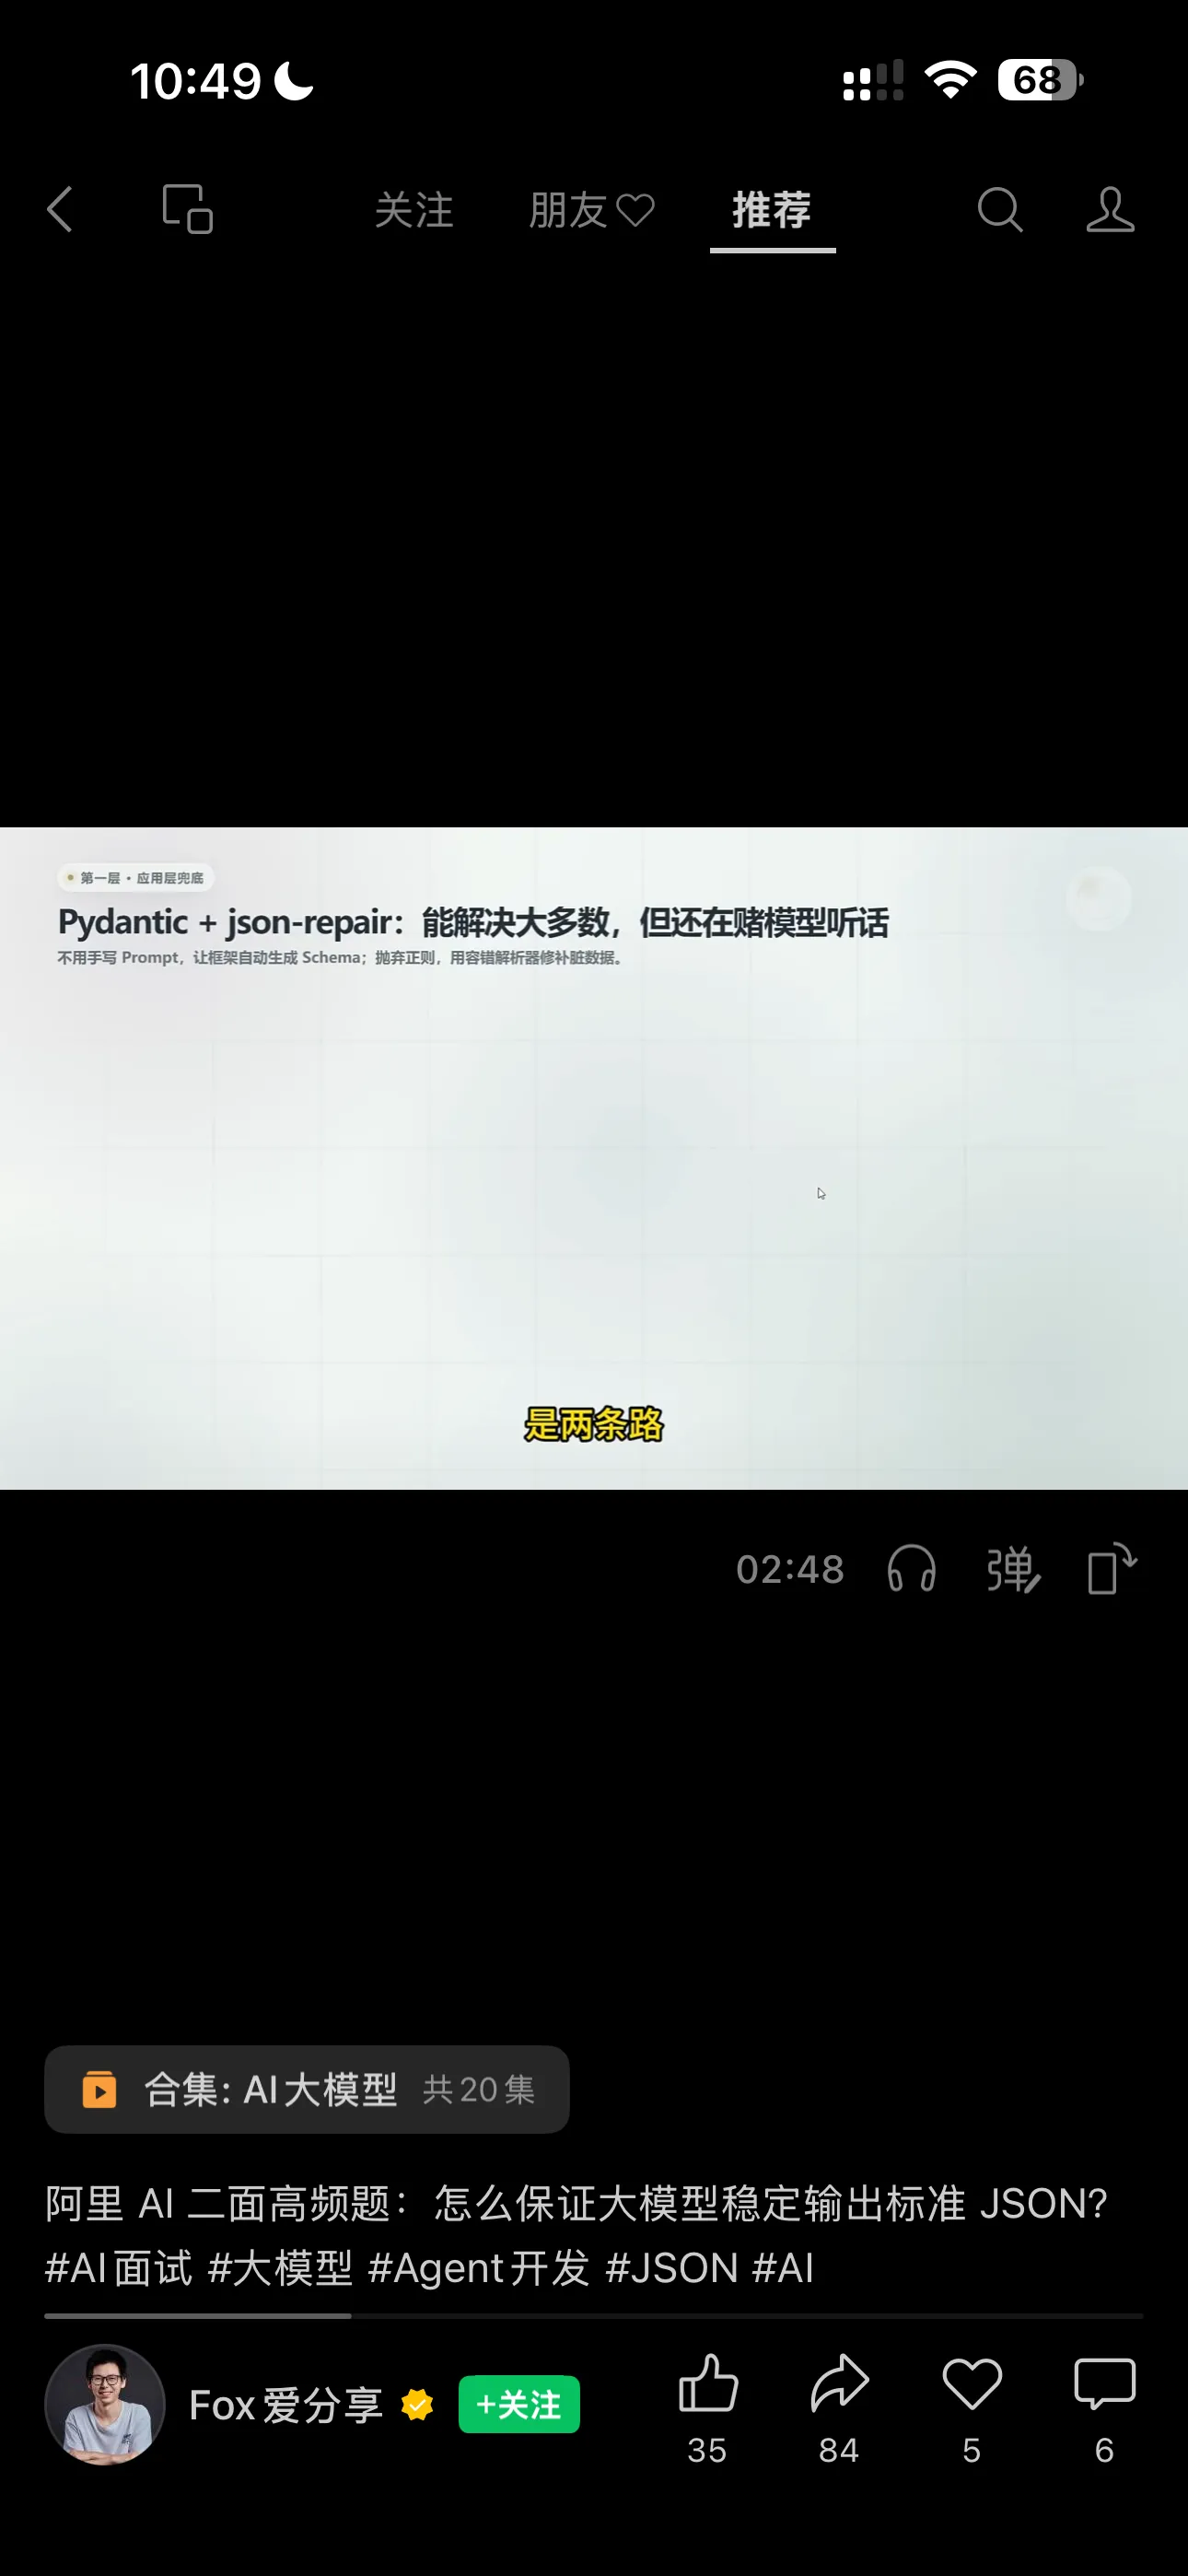
截图还提到了:
Pydantic + json-repair
你现在不用深入学 Pydantic 源码。
只要知道:
Pydantic 是 Python 世界里非常流行的数据验证工具。
例如开发者定义:
class Project:
    name: str
    year: int
AI 给:
{
  "name": "GC Dashboard",
  "year": 2026
}
Pydantic 检查:
name → string ✓
year → integer ✓
通过。
如果 AI 给:
{
  "name": "GC Dashboard",
  "year": "不知道"
}
就会发现:
year 应该是 integer
❌ validation error
所以它相当于一个数据质检员。
json-repair 又是什么?
名字已经很直白:
修 JSON。
AI 有时候输出:
{
  "name": "GC Dashboard",
  "year": 2026,
}
严格来说可能存在格式问题。
json-repair 之类的工具会尝试:
“我知道你大概想表达什么,我帮你修成合法 JSON。”
于是变成:
{
  "name": "GC Dashboard",
  "year": 2026
}
但这仍然属于事后修复。
所以截图视频才会认为:
Prompt
↓
AI 自由生成
↓
发现格式错
↓
repair
↓
validate
↓
失败再 retry
没有直接:
Schema
↓
模型按结构生成
↓
得到合法数据
那么稳。
把截图中的“三板斧”翻译成你能理解的语言
截图讲:
Prompt + 正则提取 + 重试
可以理解成:
① 求 AI:“拜托按这个格式回答。”
② AI 没完全听话 → 用代码从回答里把 JSON 挖出来。
③ 挖不出来 → 再叫 AI 回答一次。
所以作者认为:
Demo 可以,生产环境风险比较大。
更现代的思路是:
Structured Outputs
JSON Schema
Tool Calling
strict mode
也就是:
不再依赖“AI 自觉遵守格式”,而是在系统层面定义它能交付什么结构。
对你而言,真正应该掌握到什么程度?
你不是要转后端工程师,所以我不建议你现在跑去系统学 JSON Schema specification。
你作为 Design → AI / Design Engineer / Vibe Coding 方向,更重要的是建立这一层认知:
| 概念 | 你应该形成的直觉 |
|---|---|
| JSON | 软件之间传递结构化数据的常见格式 |
Object {} | 一组有名字的数据 |
Array [] | 一组数据 |
| key / value | 字段名 / 字段值 |
| Schema | 数据必须长什么样的规则 |
| JSON Schema | 用标准方式描述 JSON 的规则 |
| Validation | 检查数据是否符合规则 |
| API | 软件和软件沟通的接口 |
| Tool Calling | LLM 用结构化参数调用工具 |
| Structured Output | 强制/约束模型按照结构返回数据 |
| strict | 更严格遵守指定 Schema |
| Pydantic | Python 常见的数据定义/验证工具 |
| parser | 把返回的数据解析成程序能使用的形式 |
| retry | 失败后重新请求 |
| Agent | LLM + Tools + 执行循环等组成的系统 |
其中 JSON → Schema → API → Tool Calling → Agent 这条关系,你最好真正理解。
因为你以后看 Claude Code、Codex、MCP、Skills、Agent、API 文档,会反复碰到它们。
还有一个对你尤其重要的连接
你之前问过 MCP、Skills、Agent 是什么。现在其实可以把它们连接起来了:
                    你
                    ↓
                  Agent
                    ↓
          ┌─────────┴─────────┐
          ↓                   ↓
       Prompt              Context
          ↓
                  LLM
                   ↓
            Tool Calling
                   ↓
          Structured JSON
                   ↓
        ┌──────────┼──────────┐
        ↓          ↓          ↓
      Files       API        MCP
        ↓          ↓          ↓
      GitHub    Database    外部工具
这就是为什么当你从“让 Claude 帮我写一个页面”逐渐走向真正的 AI-native product / Agent system 时,JSON、Schema、API、Tool Calling 会越来越重要。
你已经不只是在学习“怎么 Prompt AI 写代码”,而是在开始碰到AI 如何被嵌进一个可靠的软件系统这个层面了。