梯度下降与反向传播
原始对话 · 2026-10-29 归档这里保留当时的提问和 ChatGPT 的回答,回答未逐条核实;学习页是另行核对后的解释。
反向传播
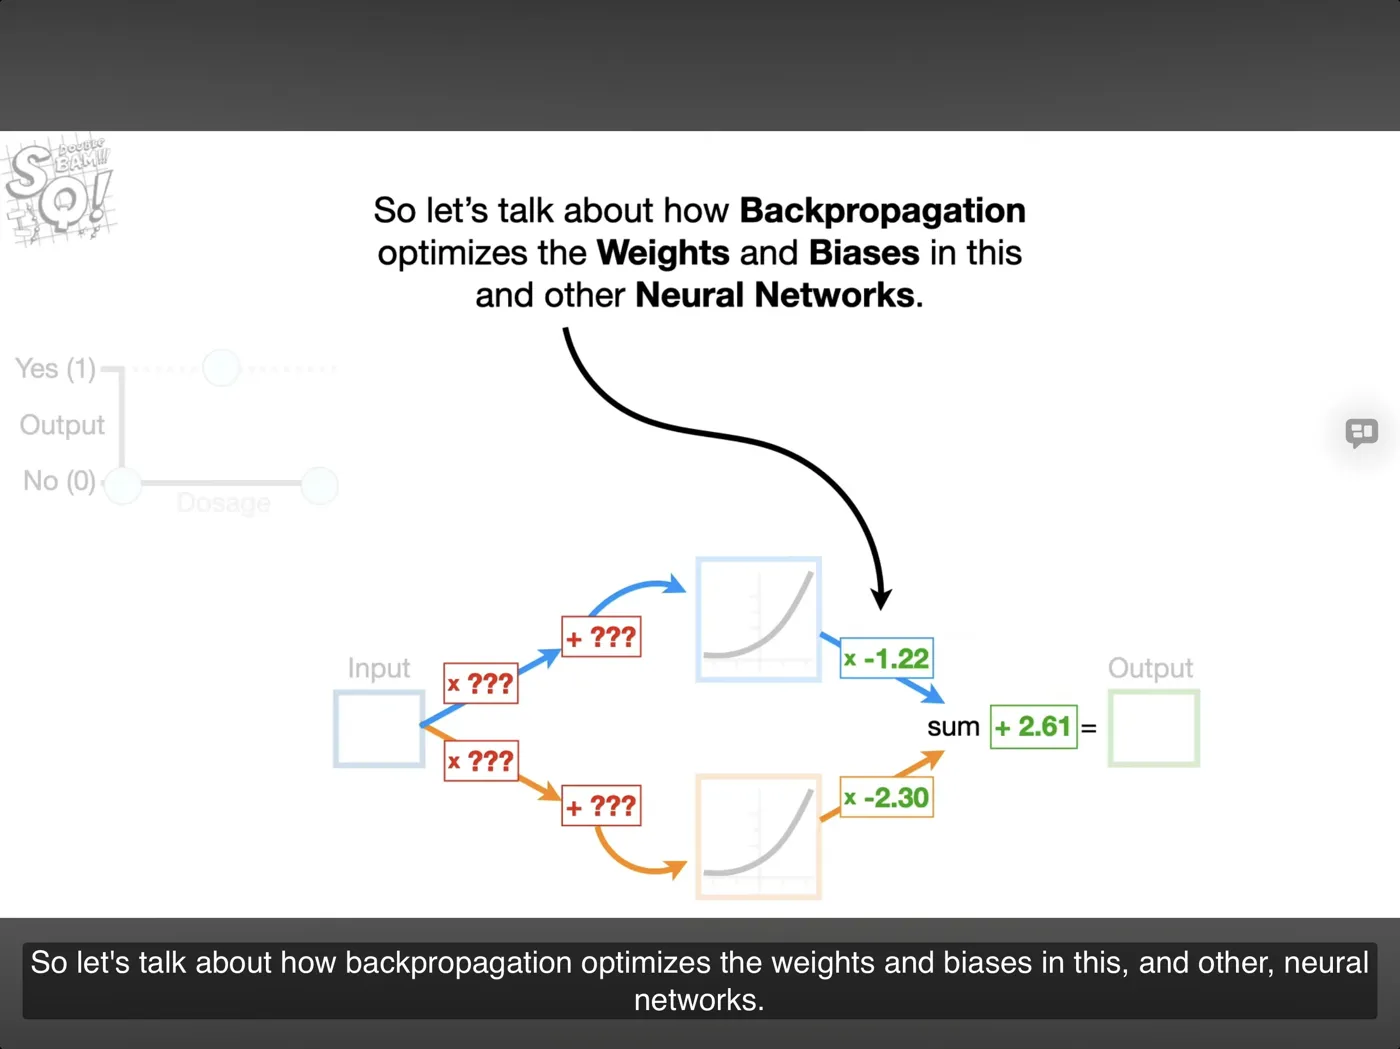
尤其是backpropagation解释
这张图开始讲神经网络最重要的机制之一:Backpropagation(反向传播)。
你之前已经看过 Activation Function(激活函数)、Weights(权重)和 Biases(偏置)。现在视频开始回答一个新问题:
神经网络最初并不知道正确的权重和偏置,那它是怎么把这些数字调整到合适的值的?
答案就是通过反向传播计算如何调整参数,再由优化算法更新它们。
1. 一句话理解 Backpropagation
反向传播就是:神经网络先做出预测,再根据预测的错误,从输出端往回计算每个参数应该如何调整。
你可以把它想象成一个不断纠错的过程。
2. 结合你的截图理解
你的截图中,神经网络有两条计算路径。
两条路径的结果经过各自的输出权重,再相加并加上最终偏置,得到预测值。
你截图里出现了:
× ???:需要学习的权重(Weights)。+ ???:需要学习的偏置(Biases)。× -1.22、× -2.30:另外两个权重。+ 2.61:输出端的偏置。
这些数值都属于神经网络可以通过训练调整的参数。红色问号代表视频准备重新寻找更合适的参数。
3. 为什么需要反向传播?
假设神经网络正在预测一种药物是否有效。
真实答案是:
但神经网络预测:
那么它就需要学习。
可是问题来了:这个预测值是经过许多权重、偏置和激活函数计算出来的。
究竟应该修改哪个数字?修改多少?
这就是反向传播的作用。
它通过数学中的 Chain Rule(链式法则),计算损失函数对各个参数的梯度,告诉优化算法:
- 哪些参数对当前误差有影响?
- 朝哪个方向调整,可能降低误差?
- 调整的幅度应该如何确定?
随后,Gradient Descent(梯度下降)等优化算法根据这些梯度更新参数。
4. 你可以自己体验一次神经网络如何学习
下面用一个极简模型展示。假设输入固定为 1,真实目标是 1,模型的预测就是权重 。我们暂时不使用激活函数和偏置,只观察训练过程。
严格来说,这个例子只有一个参数,所以不需要复杂的反向传播过程。但它展示了反向传播最终要帮助完成的事情:让参数朝着降低误差的方向更新。
5. 你目前需要理解到什么程度?
从 AI 产品设计和 Vibe Coding 的学习目标来看,我建议你先掌握三个层次:
| 概念 | 需要理解的核心 |
|---|---|
| Forward Propagation 前向传播 | 输入数据,经过计算得到预测 |
| Loss Function 损失函数 | 衡量预测与目标之间的差距 |
| Backpropagation 反向传播 | 反向计算各参数的梯度,帮助模型改进 |
暂时不需要手动推导链式法则或偏导数。
最后,记住一句英文:
"Backpropagation calculates how each parameter contributes to the loss, so the model can update its weights and biases."
意思是:反向传播计算各个参数对损失的影响,从而帮助模型更新权重和偏置。
这也是你正在看的视频从“神经网络如何做预测”进入“神经网络如何学习”的关键转折。
导数与链式法则
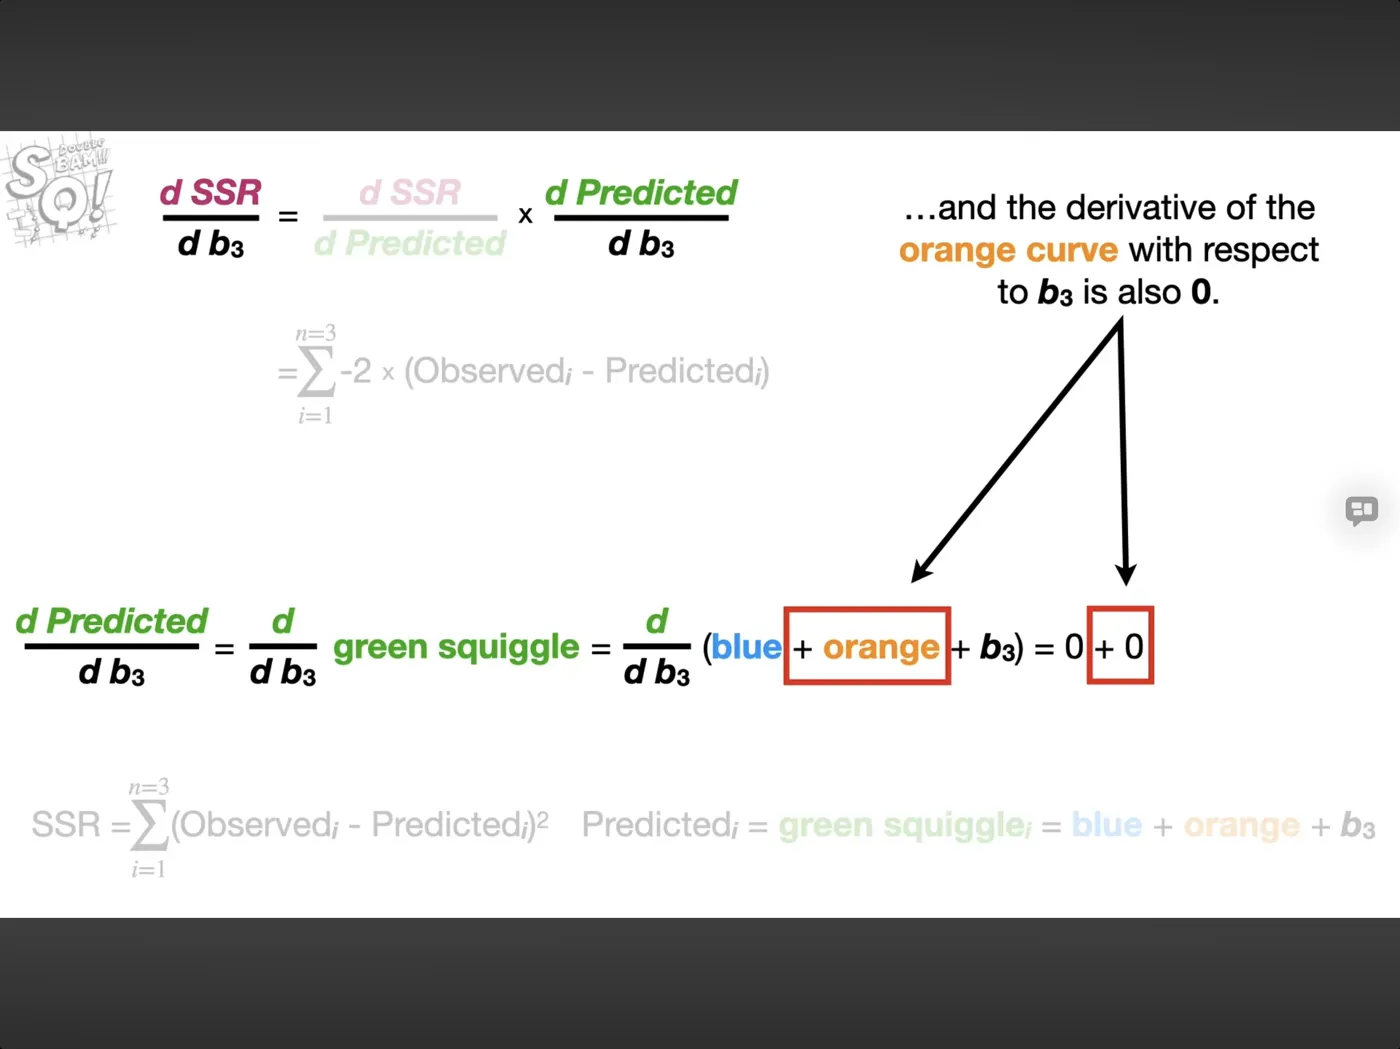
不懂
这张图确实比前面复杂,因为视频已经进入 Backpropagation(反向传播)背后的数学原理:Derivative(导数)和 Chain Rule(链式法则)。
但这里有一个特别重要的地方:你不需要先理解整条公式,只需要理解它想回答什么问题。
1. 这张图究竟想解决什么?
回忆之前的神经网络:
模型的预测公式是:
这里的 是最终的 Bias(偏置)。
现在视频想知道:
如果我们稍微改变 ,最终的预测误差 SSR 会改变多少?
这正是截图最上方公式的意思:
读作:The derivative of SSR with respect to b three.
意思是:SSR 对 的导数。
2. 为什么截图里 Blue 和 Orange 的导数都是 0?
这是你这张截图最值得理解的部分。
视频写的是:
为什么?
因为这里计算的是 只改变 ,其他参数保持不变 的情况。
| 部分 | 改变 时会怎样? | 导数 |
|---|---|---|
| Blue | 不变 | 0 |
| Orange | 不变 | 0 |
| 增加 1 就增加 1 | 1 |
所以:
注意:Blue 和 Orange 的导数为 0,不代表它们的输出是 0,也不代表它们对预测没有贡献。
只是说,当我们单独调整 时,这两部分不会跟着变化。
3. 那为什么上面还有一个乘法公式?
截图上方是:
这就是 Chain Rule(链式法则)。
可以把它拆成两个问题:
- 预测值变化,会让误差 SSR 变化多少?
- 变化,会让预测值变化多少?
把这两个变化率相乘,就能得到:
改变 ,会让 SSR 变化多少。
这就是神经网络训练时需要的信息。
4. 用一个数字例子试试
你会发现,Blue 和 Orange 一直不变,但改变 就能改变最终预测,也会影响误差。
这就是视频正在用导数分析的关系。
5. 你现在需要记住什么?
你之前已经理解了神经网络的前向计算,现在可以把这节内容连接起来:
- Forward Propagation: 通过权重、偏置和激活函数计算预测值。
- Loss(SSR): 衡量预测值与真实值的差距。
- Derivative: 衡量一个参数发生微小变化时,误差如何变化。
- Backpropagation: 使用链式法则计算各参数的梯度,帮助优化算法调整权重和偏置。
还有一点:截图里出现的 只是中间计算,完整结果应该是 ,因为 对自身的导数是 1。
我建议你暂时不用背这些数学公式。 对你目前建立 AI Literacy 的目标,更重要的是理解:神经网络不是随机地修改参数,而是利用梯度,有方向地降低预测误差。
你可以继续看视频,遇到下一步计算权重(Weights)的导数时,我们再把它和这里的偏置(Bias)比较,你会发现其实是同一套逻辑。
山谷与梯度下降
你说的这个让我想起了吴恩达在deep learning平台讲的课,用那种xyz轴山峰和谷底演示计算一步步优化接近准确值
对!你想起来的正是吴恩达课程里经典的 Gradient Descent(梯度下降) 演示。
而且它和你现在学习的 Backpropagation(反向传播) 是直接关联的。你其实已经接触过同一套训练机制,只是两门课从不同角度解释。
两个概念是怎样连接的?
可以把神经网络训练想象成:在一座山上寻找最低的谷底。
- 山的高度:Loss(损失),代表模型预测有多不准确。
- 山上的位置:Weights 和 Biases(权重与偏置)的当前取值。
- 山的坡度:Gradient(梯度),告诉我们往哪个方向调整参数,损失下降得最快。
- 谷底:损失较小的位置,是优化希望到达的地方。
但这里有两个不同的工作:
| 概念 | 负责什么 | 山谷比喻 |
|---|---|---|
| Backpropagation 反向传播 | 计算每个参数对应的梯度 | 测量当前位置的坡度 |
| Gradient Descent 梯度下降 | 根据梯度更新参数 | 沿着下坡方向走一步 |
试着走向谷底
下面用一个简化的一维损失函数演示。你可以调整学习率(Learning Rate),观察每次更新的步长。
再联系你刚刚看到的公式
截图中:
就是在计算:如果改变偏置 ,山的高度(SSR)会怎样变化?
反向传播算出这个梯度之后,梯度下降就可以利用它更新 。
所以你可以把整个过程记成:
这四步反复执行,就是神经网络训练的基本循环。
还有一个你可能会感兴趣的联系:你之前学习的 Cross-validation(交叉验证) 不负责让模型下山,而是帮助评估模型在未见数据上的表现,以及选择合适的超参数。
这样,你最近学到的神经网络、Bias、Derivative、Backpropagation、Gradient Descent 和 Cross-validation,其实已经开始形成一个完整的机器学习知识框架了。
权重的偏导数
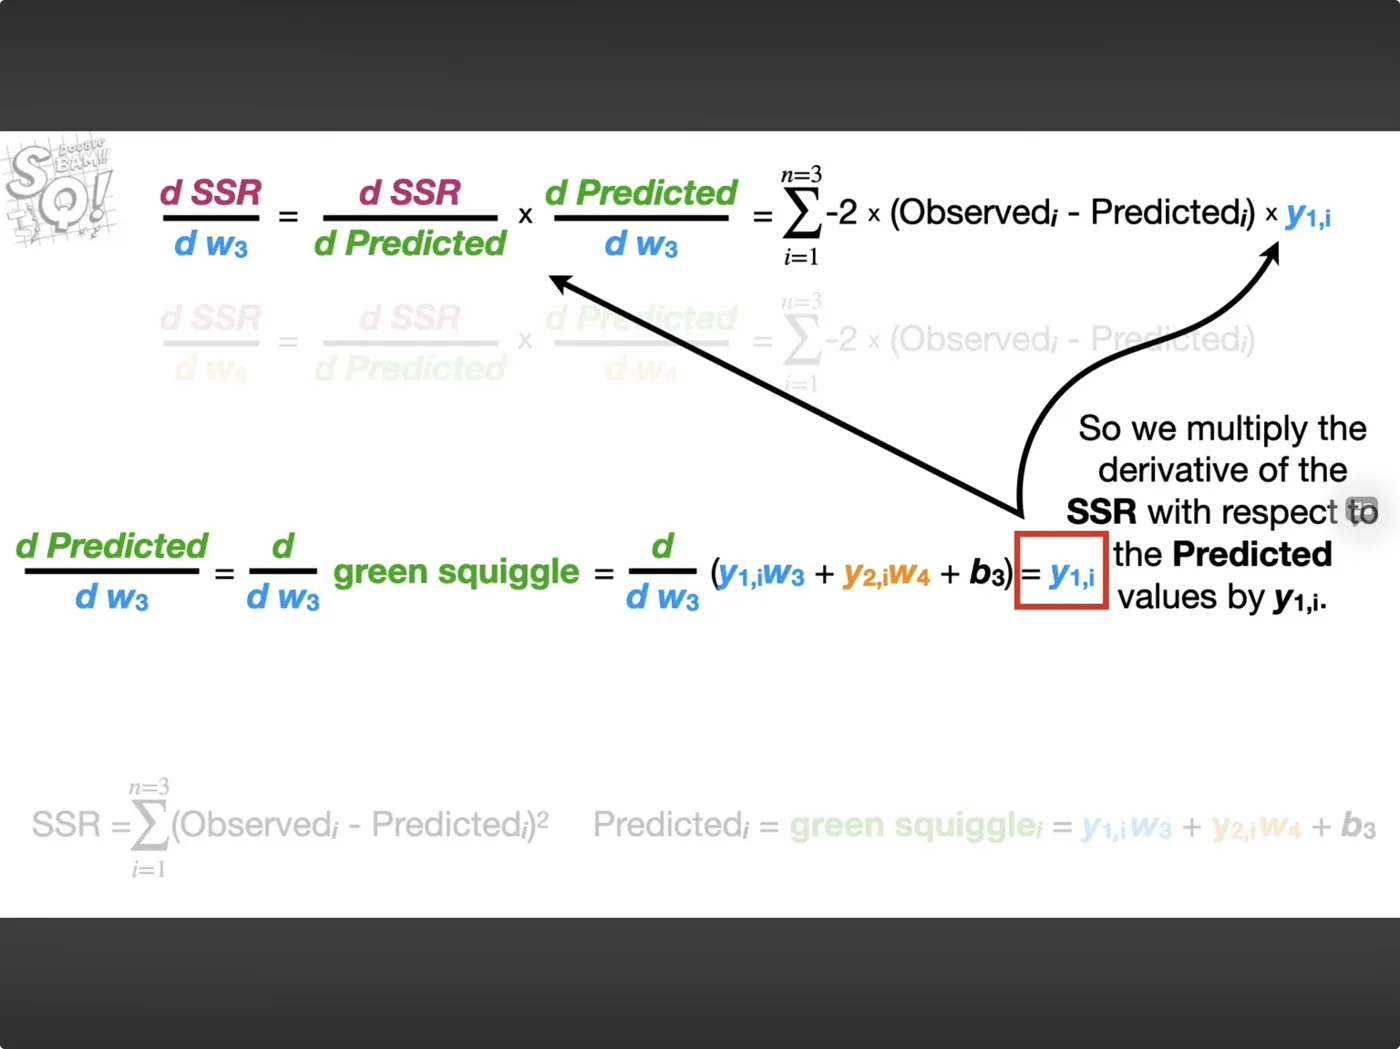
一点都看不懂
这张图确实突然变得很数学化了。但你先不用试图读懂所有符号。
整张图其实只在回答一个问题:神经网络应该怎样调整一个叫 的权重,才能让预测更准确?
这就是你刚刚提到的吴恩达课程里“沿着山坡寻找谷底”的一部分。
1. 先不看公式,理解它在干什么
假设我们有一个预测药物疗效的神经网络。
- 实际结果(Observed):1,代表药物有效。
- 模型预测(Predicted):0.6。
- 预测误差:0.4。
现在我们想让预测从 0.6 更接近 1。
但神经网络里有很多可以调整的参数,例如 、、。
问题是:调整 会让预测变好还是变坏?影响有多大?
这张图就是在计算这个。
2. 把截图中的公式拆成三部分
然后,把第二部分和第三部分相乘,就得到第一部分。
这叫 Chain Rule(链式法则)。
3. 为什么要相乘?
用一个更简单的例子:
假设:
- 增加 1 个单位,会让预测值增加 0.5。
- 预测值增加 1 个单位,在当前位置会让误差减少 0.8。
那么:
结果为负,表示在当前位置,稍微增加 ,误差会下降。
这就是导数告诉我们的信息。
注意,这些数字只是为了帮助理解,不是截图中的实际计算结果。
4. 为什么截图最后出现了一个求和符号?
你看到的:
意思就是:把三个训练样本分别算出来的结果加在一起。
因为视频里使用三个样本训练,所以需要考虑 对全部三个样本总误差的影响,而不只是一个样本。
因此截图最终得到:
你目前不需要记住这个公式,只要知道它计算的是一个权重对总误差的影响。
5. 和你之前看到的山谷有什么关系?
我对你当前学习阶段的建议
你现在看的 StatQuest 视频已经进入神经网络的数学推导部分,涉及偏导数、链式法则和求和符号。
如果你的目标是建立 AI Literacy,理解神经网络怎样学习、怎样训练,以及这些技术如何影响 AI 产品设计,目前不必掌握手工计算这些导数的能力。
但我想确认一个关键理解:
假设我们发现,增加 会让预测误差变大。
那么,为了降低误差,梯度下降通常应该怎么调整 ?
如果你能理解这道题,其实你就已经掌握了这段视频最重要的概念,而不需要先把所有数学符号都弄懂。
损失曲面
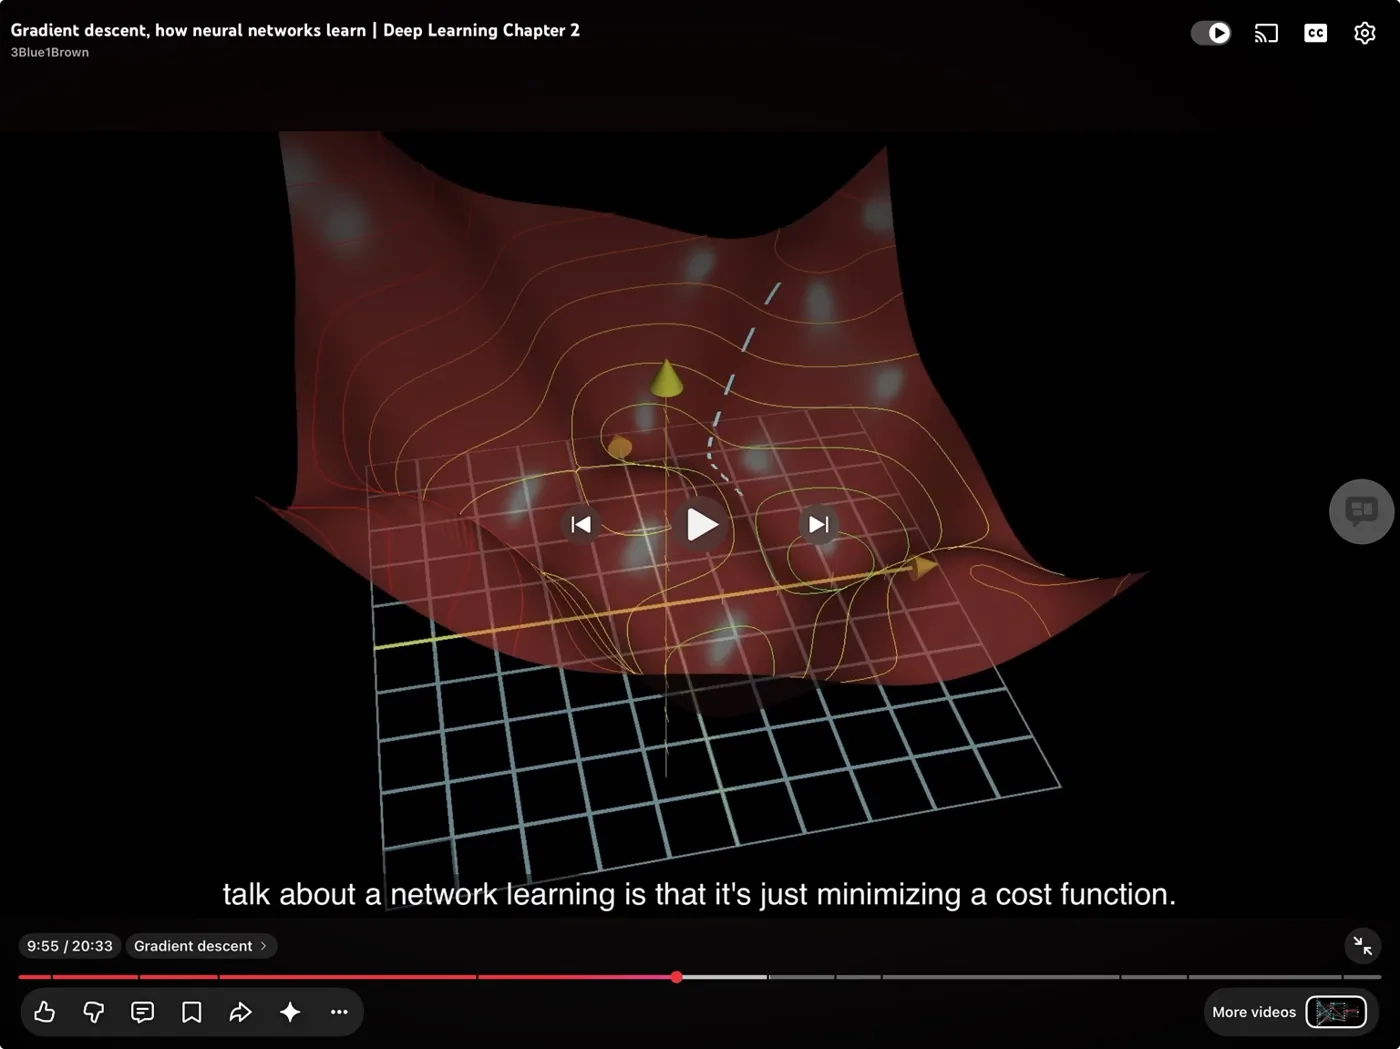
这张图其实把你之前在 StatQuest 学到的 Weight、Bias、Backpropagation 和 Gradient Descent(梯度下降) 联系起来了。
你现在看到的是 3Blue1Brown 第二章里一个很重要的概念:
神经网络的学习过程,可以理解为不断调整参数,让预测错误越来越小。
1. What — 这张三维曲面是什么?
它叫做 Cost Surface(损失曲面),也可以理解为一张“错误程度的地形图”。
想象你站在山坡上:
- 山顶:Cost 很高,模型预测不准确。
- 山谷:Cost 较低,模型预测更准确。
- 你的任务:找到尽可能低的位置。
2. How — 神经网络怎样走到谷底?
它使用 Gradient Descent(梯度下降)。
每一步其实只需要理解三个动作:
- 计算坡度:当前位置往哪个方向走,Cost 会下降?这需要 Gradient(梯度)。
- 调整参数:改变 Weight 和 Bias。
- 重新计算 Cost:看看预测是否改善,然后重复。
3. Why — 为什么要这样做?
因为神经网络刚开始通常不知道什么样的 Weight 和 Bias 能够正确识别图像。
例如识别手写数字 3:
最初模型可能错误地预测为 8。训练时,它会比较预测结果和正确答案,计算 Cost,然后根据梯度调整参数。
重复许多次后,模型通常就能更准确地识别数字。
这里还有一个你之前不太理解的区别:
| 概念 | 负责什么 |
|---|---|
| Forward Propagation | 根据当前参数计算预测结果 |
| Cost Function | 衡量预测有多错误 |
| Backpropagation | 高效计算 Cost 对各个参数的梯度 |
| Gradient Descent | 利用梯度更新参数,尝试降低 Cost |
Backpropagation 负责告诉模型参数应该如何调整,Gradient Descent 负责实际执行调整。
这也是为什么你之前看到的复杂偏导数公式,与这张直观的山谷图其实是在讲同一套训练过程。
你现在不必掌握那些偏导数的计算。对于建立 AI Literacy,现阶段最重要的是理解:
神经网络不是直接被告知每个 Weight 应该是多少,而是通过预测、计算误差、求梯度和更新参数,逐步学习合适的参数。
另外,这张图中的谷底不一定只有一个;实际神经网络的高维损失曲面非常复杂,梯度下降也不保证找到全局最低点。
负梯度向量
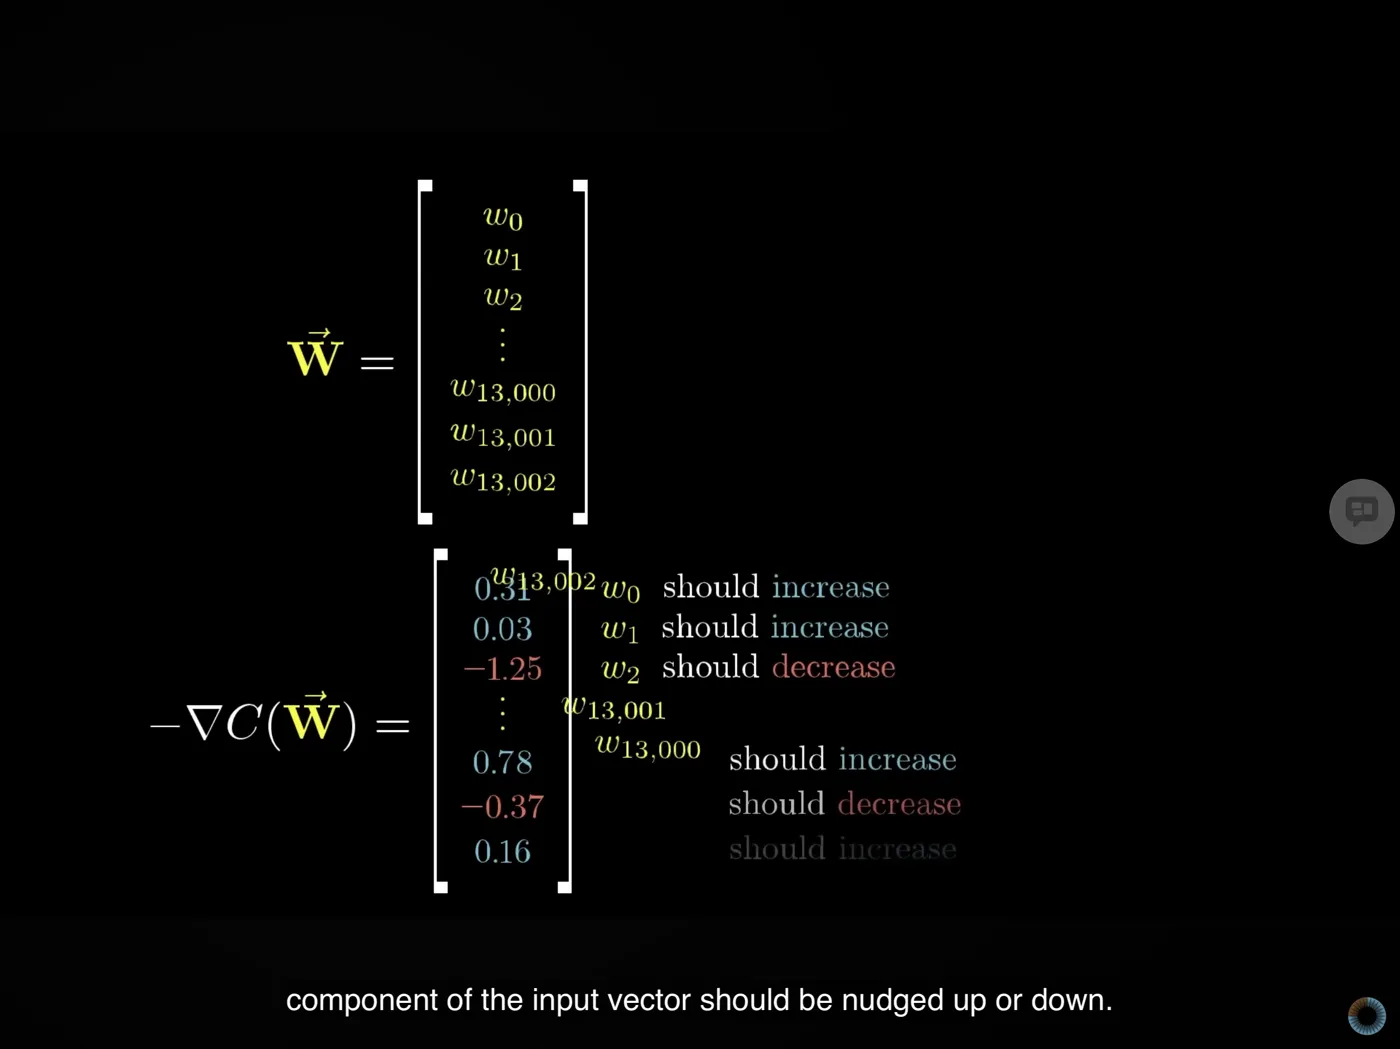
啥意思
这张图其实是在解释你之前看到的 Gradient Descent(梯度下降)到底如何调整神经网络中的 Weight(权重)。
之前你看到的是一座三维山谷,现在视频把山谷上的“下坡方向”变成了一长串数字。
我们按照 What → How → Why 来理解。
1. What — 图中的两组数字是什么?
- 上面那组 :神经网络中当前的权重参数。
- 下面那组 :负梯度(Negative Gradient),告诉我们怎样调整各个权重,才能在局部降低 Cost。
你看到的 13,002,表示这个示例中有大量需要调整的权重,而不是只有两三个。
2. How — 这些数字怎样改变 Weight?
我们用图中三个数值演示。
权重 | 负梯度 | 更新后 |
w₀ | +0.31 | 1.031 |
w₁ | +0.03 | 1.003 |
w₂ | -1.25 | 0.875 |
例如:
- +0.31:第一个权重应该增加。
- +0.03:第二个权重也应该增加,但方向上的调整幅度较小。
- −1.25:第三个权重应该减小。
注意,截图中的 +0.31 并不是说 Weight 必须直接增加 0.31,还要乘上 Learning Rate。
3. Why — 为什么需要一长串数字?
还记得之前的山谷图吗?
如果只有两个 Weight,我们可以画出一张三维曲面,直观地看到往哪里走。
但是如果有 13,002 个 Weight,就相当于在 13,002 维的参数空间中寻找降低 Cost 的方向。
人类无法直接画出这样的空间,但数学可以计算。
所以这组负梯度向量,本质上就是:
一份包含 13,002 个调整方向和相对幅度的清单。
4. 它和 Backpropagation 的关系
这里是最重要的连接:
这也解释了你前面一直不理解的偏导数公式:它们是在计算这些梯度分量,而不是直接计算神经元的 Activation。
一句话总结:之前的山谷图告诉你神经网络为什么要往下走;这张图告诉你,当神经网络有成千上万个参数时,怎样用一组数字确定往哪个方向走。
你现在不需要记住 ∇ 的数学运算,只要知道它叫 Gradient(梯度),表示 Cost 对各个参数变化的敏感程度,就足够继续看这一章了。