Module 1 · Agentic Workflows 入门
原始对话 · 2026-10-29 归档这里保留当时的提问和 ChatGPT 的回答,回答未逐条核实;学习页是另行核对后的解释。
JSON、Schema 与工具调用
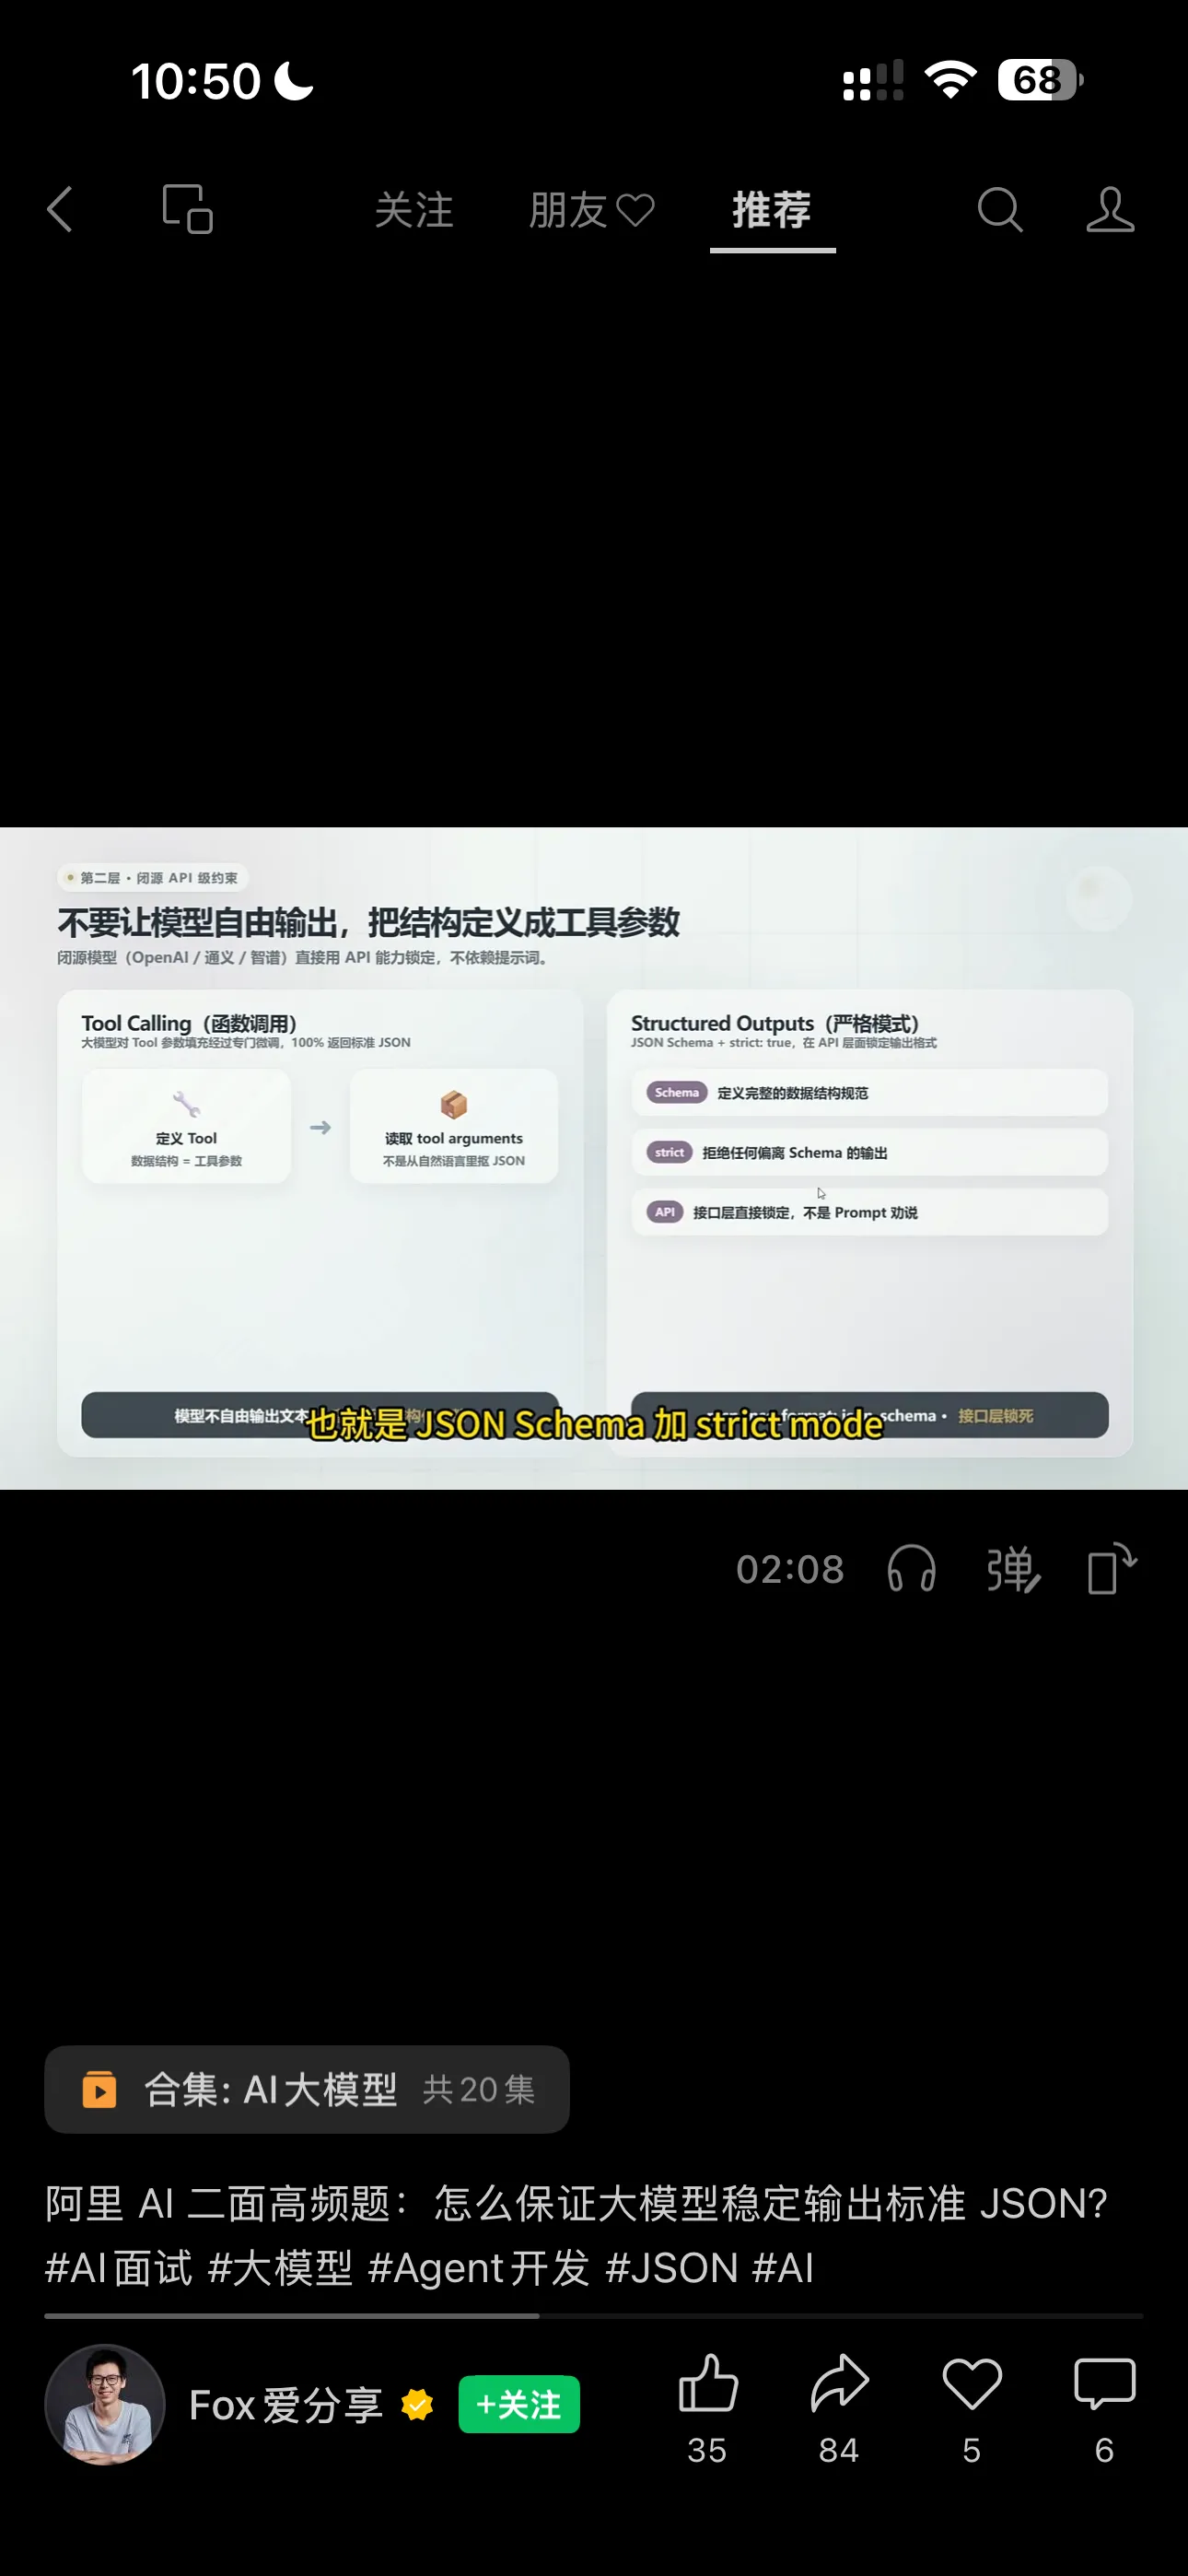
帮我解释一下这里面的技术问题,尤其是类似J.son这种,我在vibe coding经常上看到的格式
可以。你截图里讲的其实是一个很典型的 “AI 从自然语言世界进入软件工程世界时,如何保证数据可靠” 的问题。
你在 Vibe Coding 里经常看到 JSON、Schema、API、Tool Calling、Pydantic,这几个东西其实属于同一条链路。把这条链路弄明白,比单独背“JSON 是什么”有用得多。
先从 JSON 开始:它其实非常简单
JSON 全称是 JavaScript Object Notation。
你可以先把它理解成:
一种让不同程序都能看懂的、结构化的信息格式。
例如你对 Claude/Codex 说:
帮我创建一个项目,名字叫 GC Dashboard,状态是开发中。
人类很容易理解。
但程序更喜欢收到:
{
  "project": "GC Dashboard",
  "status": "in_progress"
}
这就是 JSON。
你在 Vibe Coding 中可能还经常看到:
{
  "title": "AI Xiaozhao",
  "type": "case-study",
  "year": 2026,
  "featured": true,
  "tags": ["AI", "UX", "Enterprise"]
}
它其实就是:
| JSON | 意思 |
|---|---|
"title" | 字段名 |
"AI Xiaozhao" | 字符串 String |
2026 | 数字 Number |
true | 布尔值 Boolean |
["AI", "UX"] | 数组 Array |
{ ... } | 对象 Object |
所以以后看到 .json,不要把它想成“程序代码”。
它更接近一个标准化的数据表/信息包。
为什么 AI Agent 特别需要 JSON?
这里就进入你截图真正讨论的问题了。
假设你让 AI:
找到我的项目,然后把项目名称、年份、类型返回给程序。
LLM 本质上是一个语言模型。
所以它很可能回答:
好的!我找到了这个项目。
项目名称是 AI Xiaozhao,大约是在 2025 年完成的,它属于 AI UX 项目。
人类觉得完全没问题。
程序却可能直接崩。
因为程序期待的是:
{
  "name": "AI Xiaozhao",
  "year": 2025,
  "type": "AI UX"
}
结果 AI 给了一段散文。
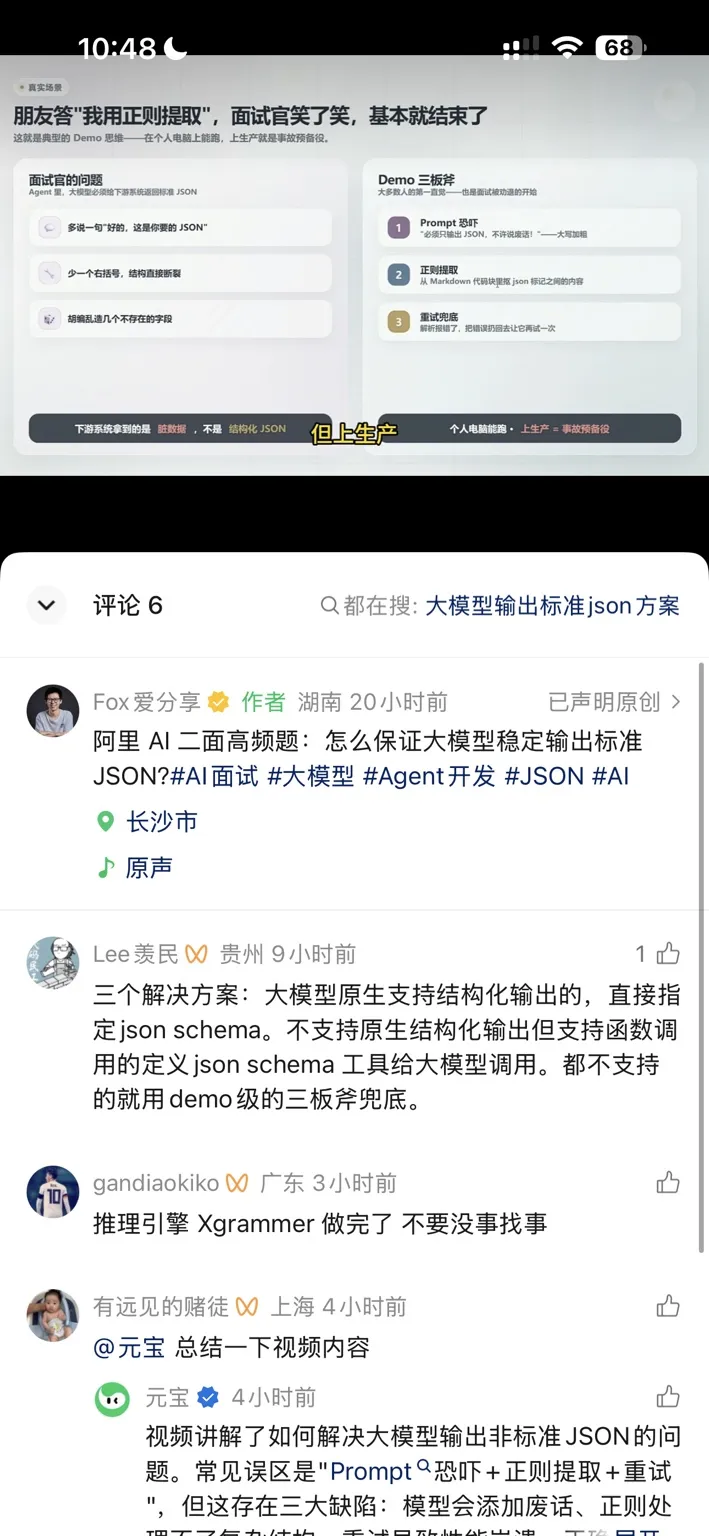
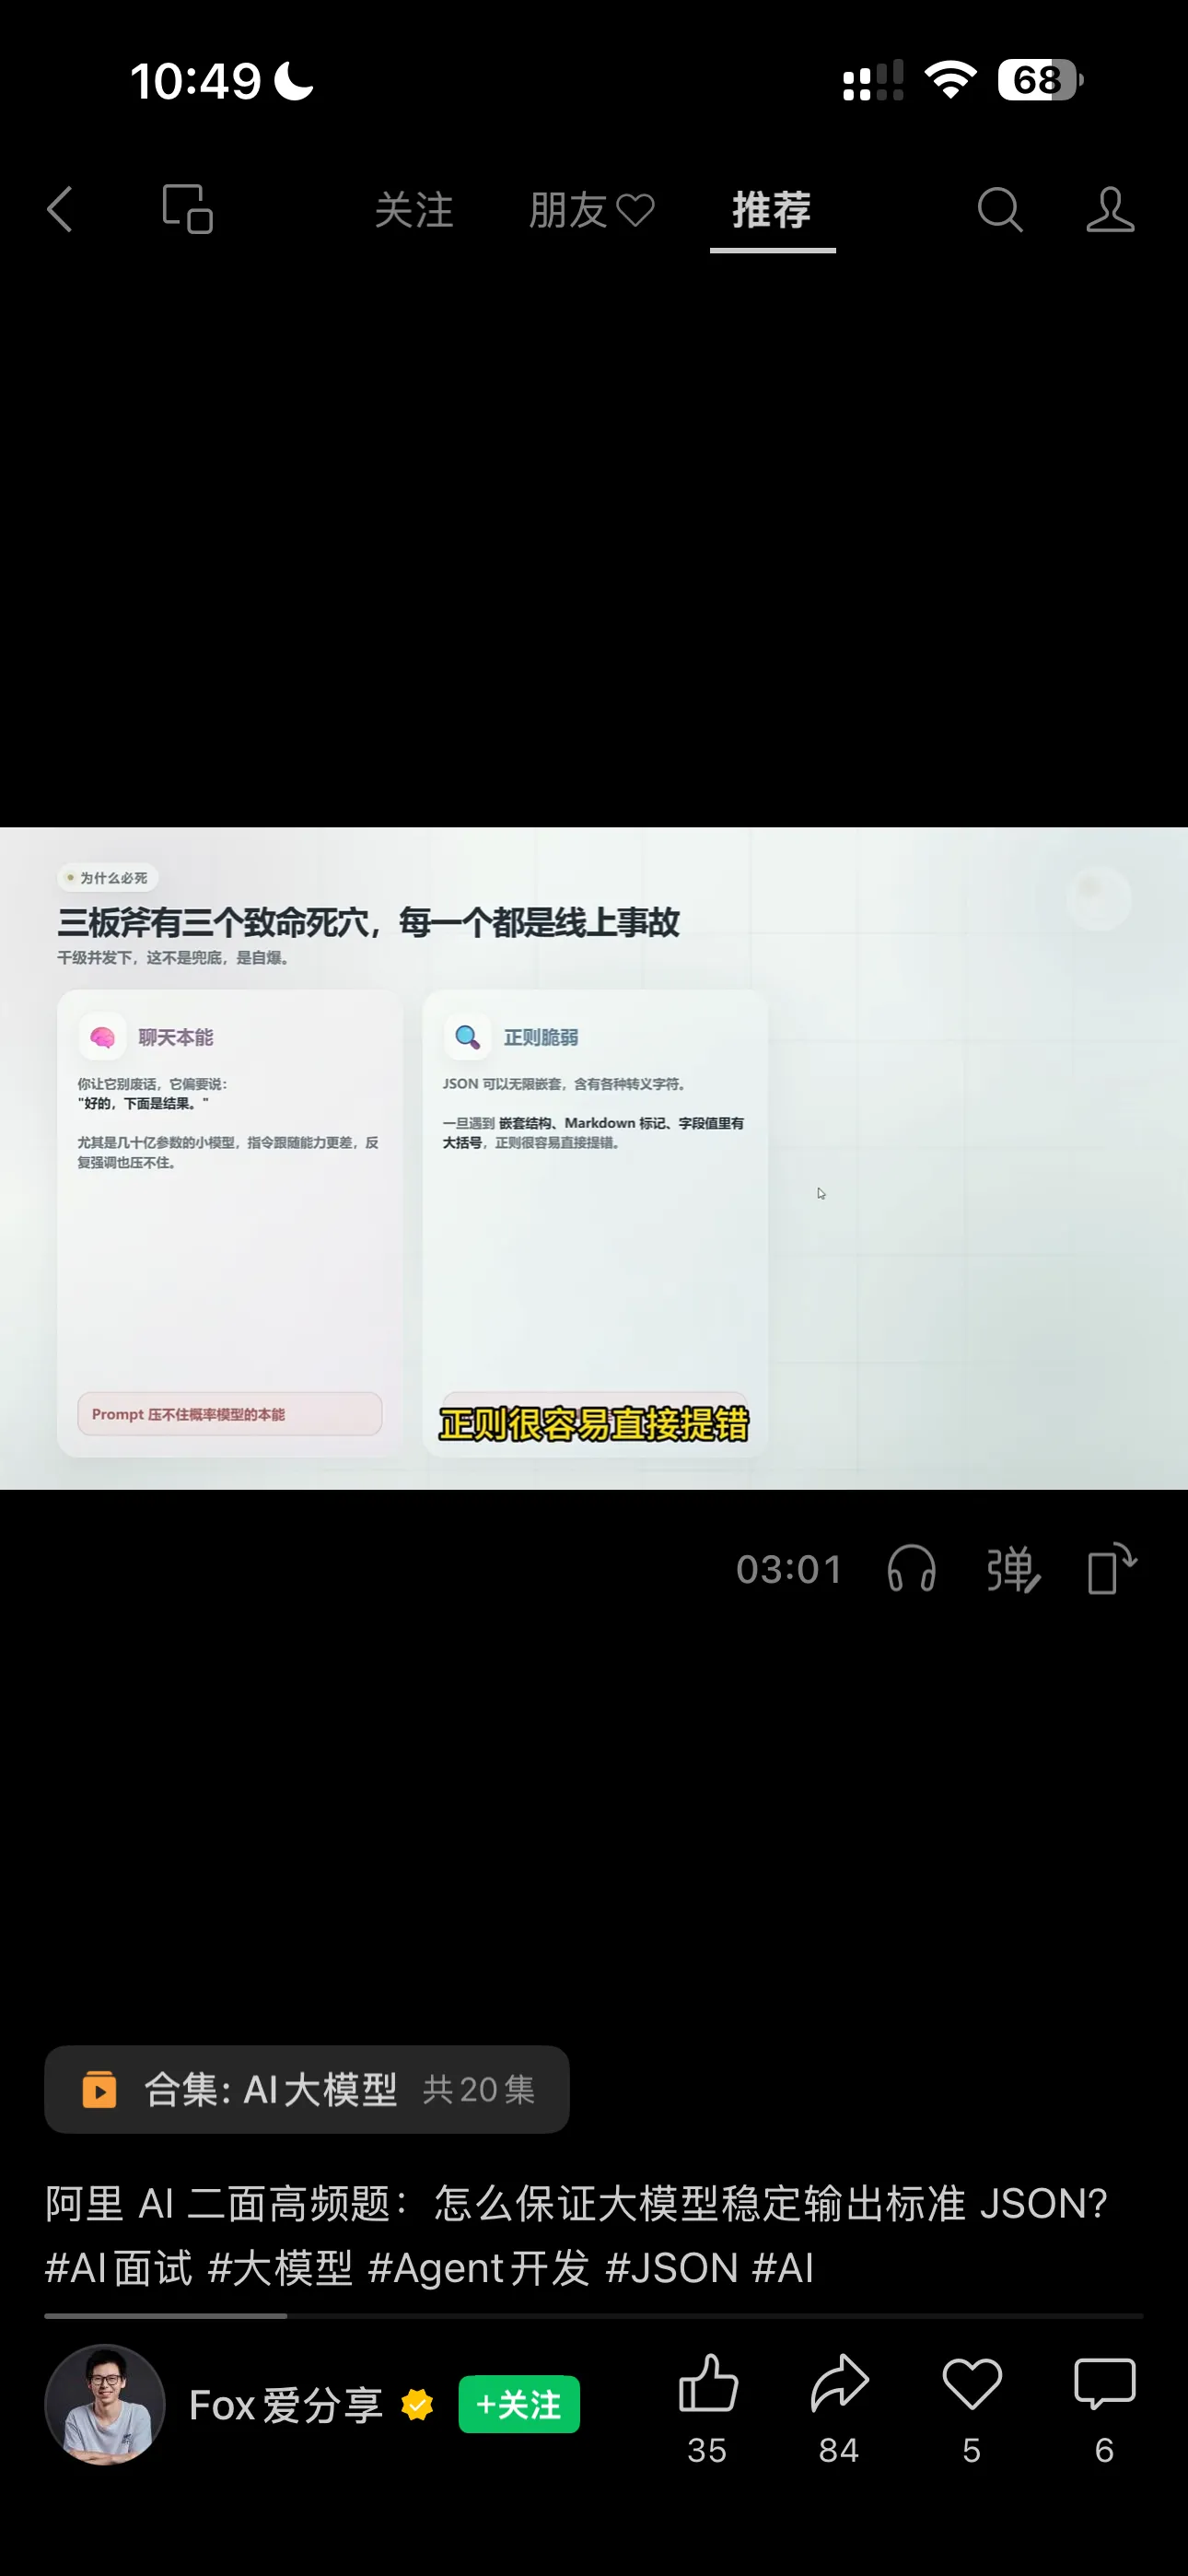
这就是截图里说的:
“聊天本能”
LLM 天生擅长生成语言,而软件系统需要的是确定的数据结构。
那 Prompt 要它“只输出 JSON”不就行了吗?
这正是截图里批评的第一种方案。
你可以写:
Only output valid JSON.
Do not include explanations.
大多数时候确实有效。
但问题是:“大多数时候”对于生产系统不够。
AI 可能突然:
Sure! Here is the JSON:

{
  "name": "AI Xiaozhao"
}
那个:
Sure! Here is the JSON:
就可能导致解析失败。
或者它输出:
{
  "year": "twenty twenty five"
}
语法可能没问题,但你的程序要求:
{
  "year": 2025
}
也就是:
Prompt 是“告诉模型应该怎么做”;不是程序层面的强约束。
这就是视频为什么说:
Prompt + 正则提取 + 重试
属于比较脆弱的 Demo 方案。
Schema 又是什么?
这个概念对你很重要。
Schema = 数据结构的规则/合同。
如果 JSON 是:
“这是一个包裹。”
Schema 就是:
“这个包裹里面必须有什么、每样东西是什么类型。”
例如:
{
  "name": "AI Xiaozhao",
  "year": 2025
}
对应规则可能是:
name → 必须是 string
year → 必须是 integer
所以:
{
  "name": 123,
  "year": "last year"
}
就不符合 Schema。
你可以把它理解成设计系统里的 component spec:
Button 可以变化,但必须遵守规定好的结构。
Schema 干的是类似的事,只不过约束的是数据。
JSON Schema = 给 JSON 写设计规范
这就是截图里出现的:
JSON Schema + strict mode
例如你告诉模型:
必须返回:

name: string
year: integer
status: "draft" | "published"
于是合法结果只能类似:
{
  "name": "GC Dashboard",
  "year": 2026,
  "status": "draft"
}
而:
{
  "name": "GC Dashboard",
  "year": "今年",
  "status": "almost finished"
}
就不符合定义。
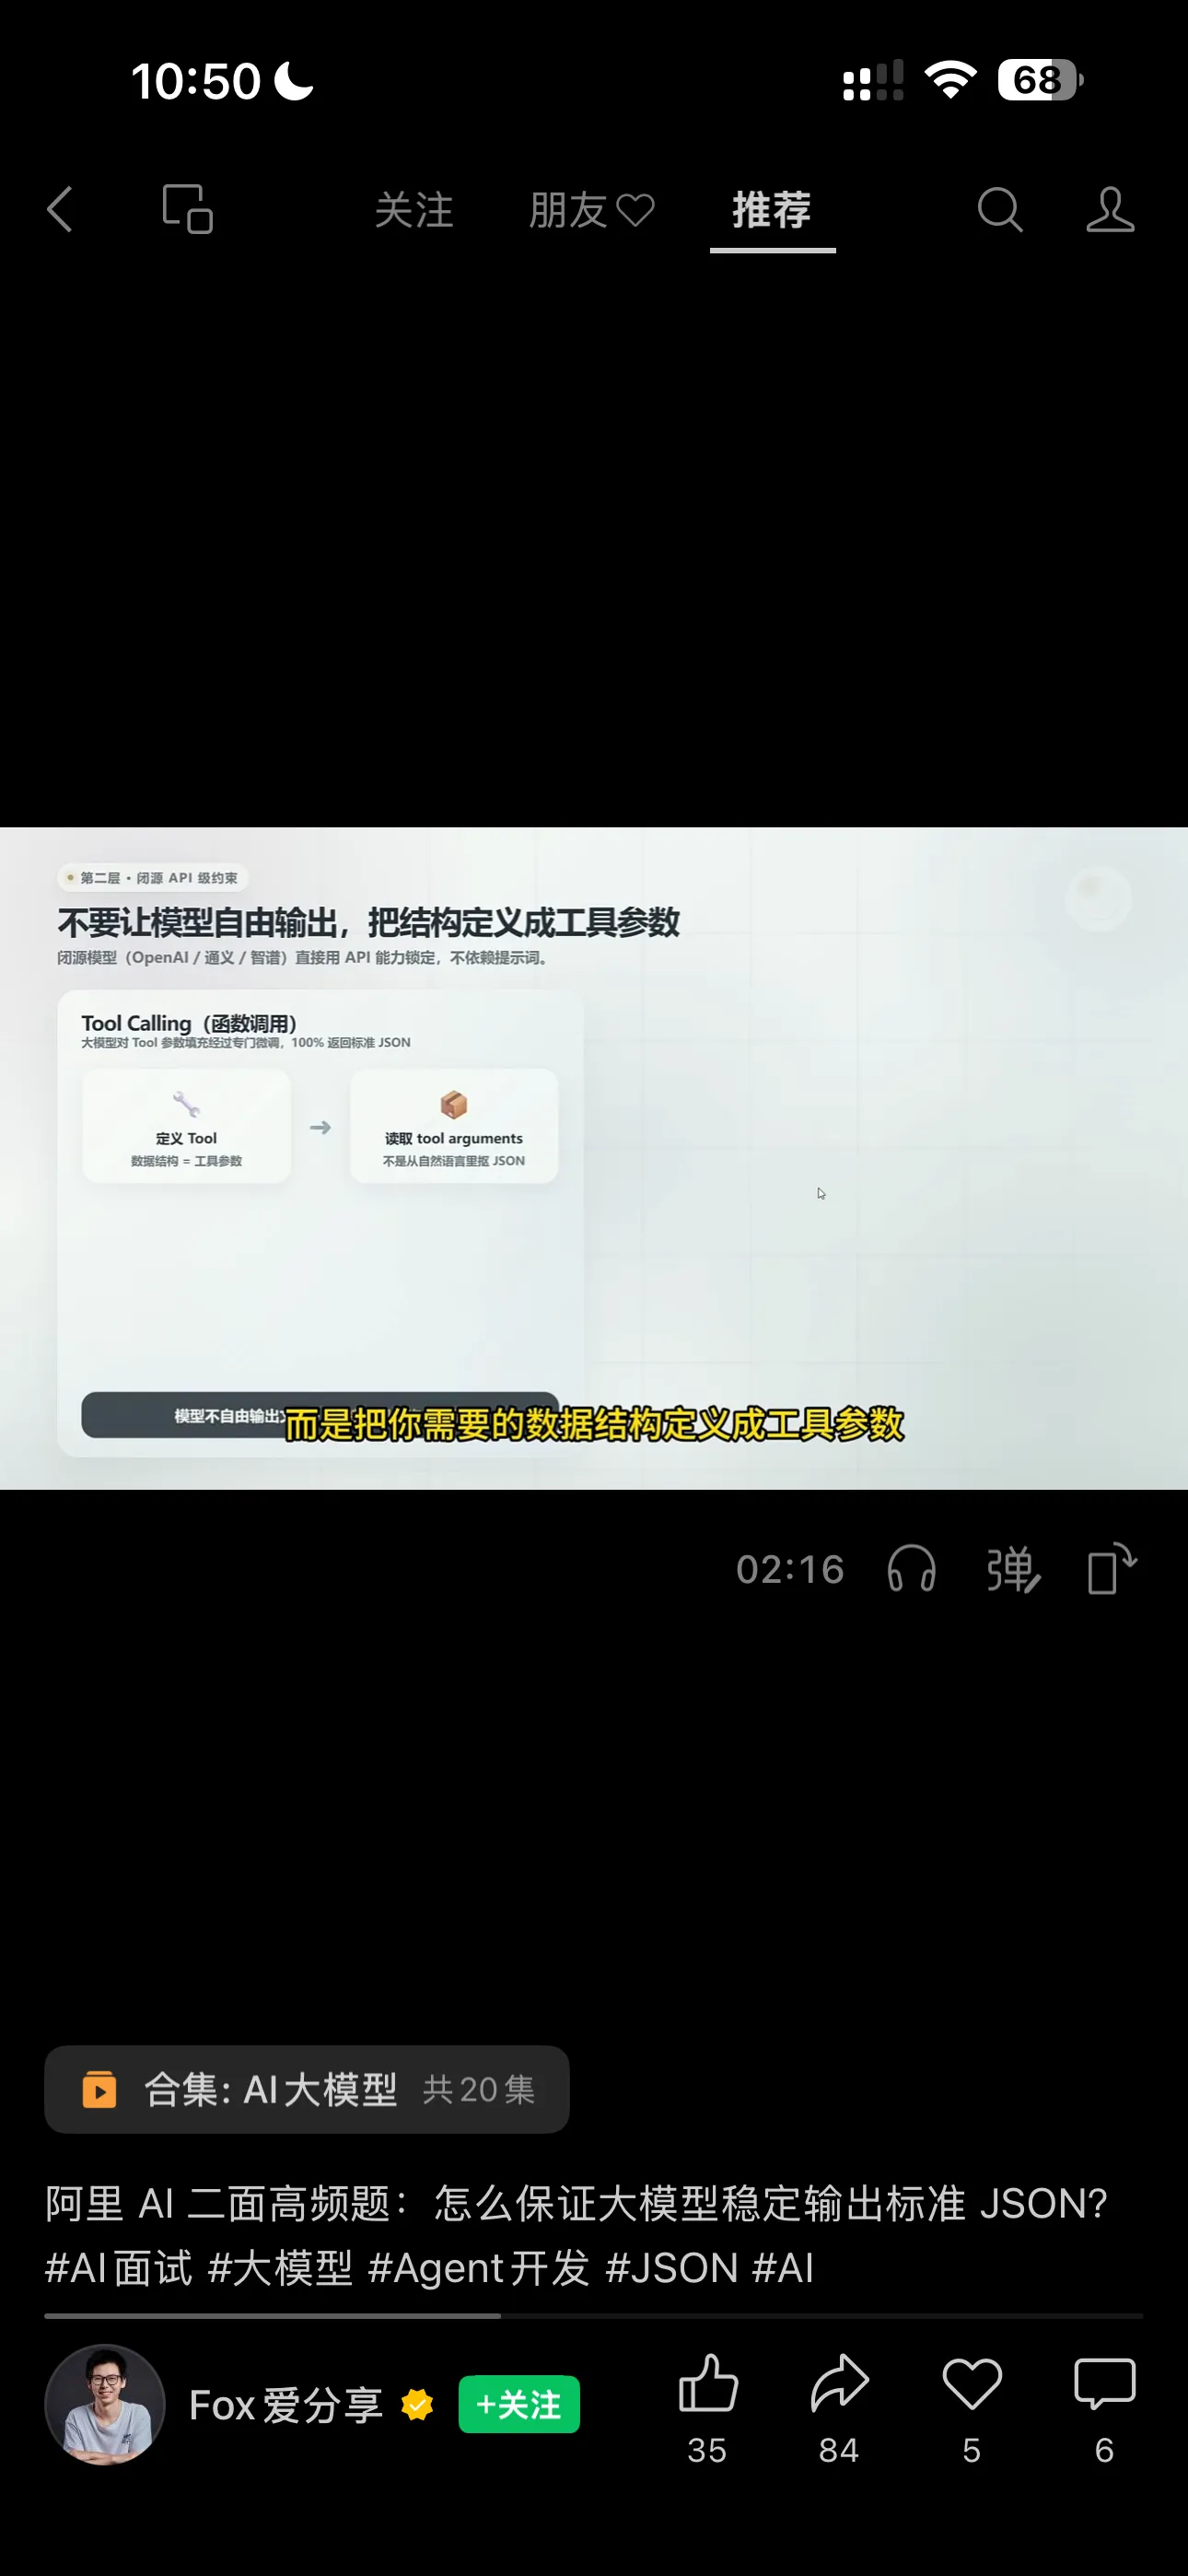
所以视频里那句话:
“不要让模型自由输出,把结构定义成工具参数。”
核心思想非常重要:
把 AI 从“请你听话”变成“你只能通过规定好的接口交东西”。
Tool Calling 又是什么?
这和你现在用 Claude Code / Codex / Agent 特别相关。
假设 Agent 有一个工具:
create_file
这个工具规定:
{
  "path": "string",
  "content": "string"
}
当 AI 决定创建文件时,它不是说:
“好的,我准备创建一个叫 page.tsx 的文件……”
而是产生类似:
{
  "path": "src/app/page.tsx",
  "content": "..."
}
程序拿到这些参数,然后真正执行创建文件的操作。
所以:
LLM 决定做什么 → Tool Calling 把决定结构化 → Tool 真正执行。
这也是 Agent 和普通 Chatbot 的一个关键区别。
你可以把整个 Vibe Coding Agent 想成这一条链
这是最值得你建立的认知:
你
↓
Natural Language
“把 Hero 标题改小一点”
↓
LLM
理解你的意图
↓
Structured Data / JSON
{
  "file": "Hero.tsx",
  "action": "edit",
  "target": "heading"
}
↓
Tool / API
读取文件、修改代码
↓
程序执行
↓
Result
↓
LLM
“修改完成”
当然真实的 Codex / Claude Code 实现比这个复杂得多,但作为你的认知模型,这已经非常好用了。
那 API 又是什么?
这个词你也会不断遇到。
API 可以简单理解成:软件与软件之间规定好的沟通入口。
例如你的网站想获取天气:
你的网页
   ↓
Weather API
   ↓
天气公司的服务器
服务器可能返回:
{
  "city": "London",
  "temperature": 19,
  "condition": "cloudy"
}
注意到了吗?
又是 JSON。
所以你会感觉自己做 Vibe Coding 时 JSON 无处不在。
因为现代软件大量存在:
Frontend
↕
API
↕
Backend
↕
Database
↕
AI Model
↕
Tools
这些不同系统之间都需要交换信息。
JSON 恰好成为非常普遍的“共同语言”。
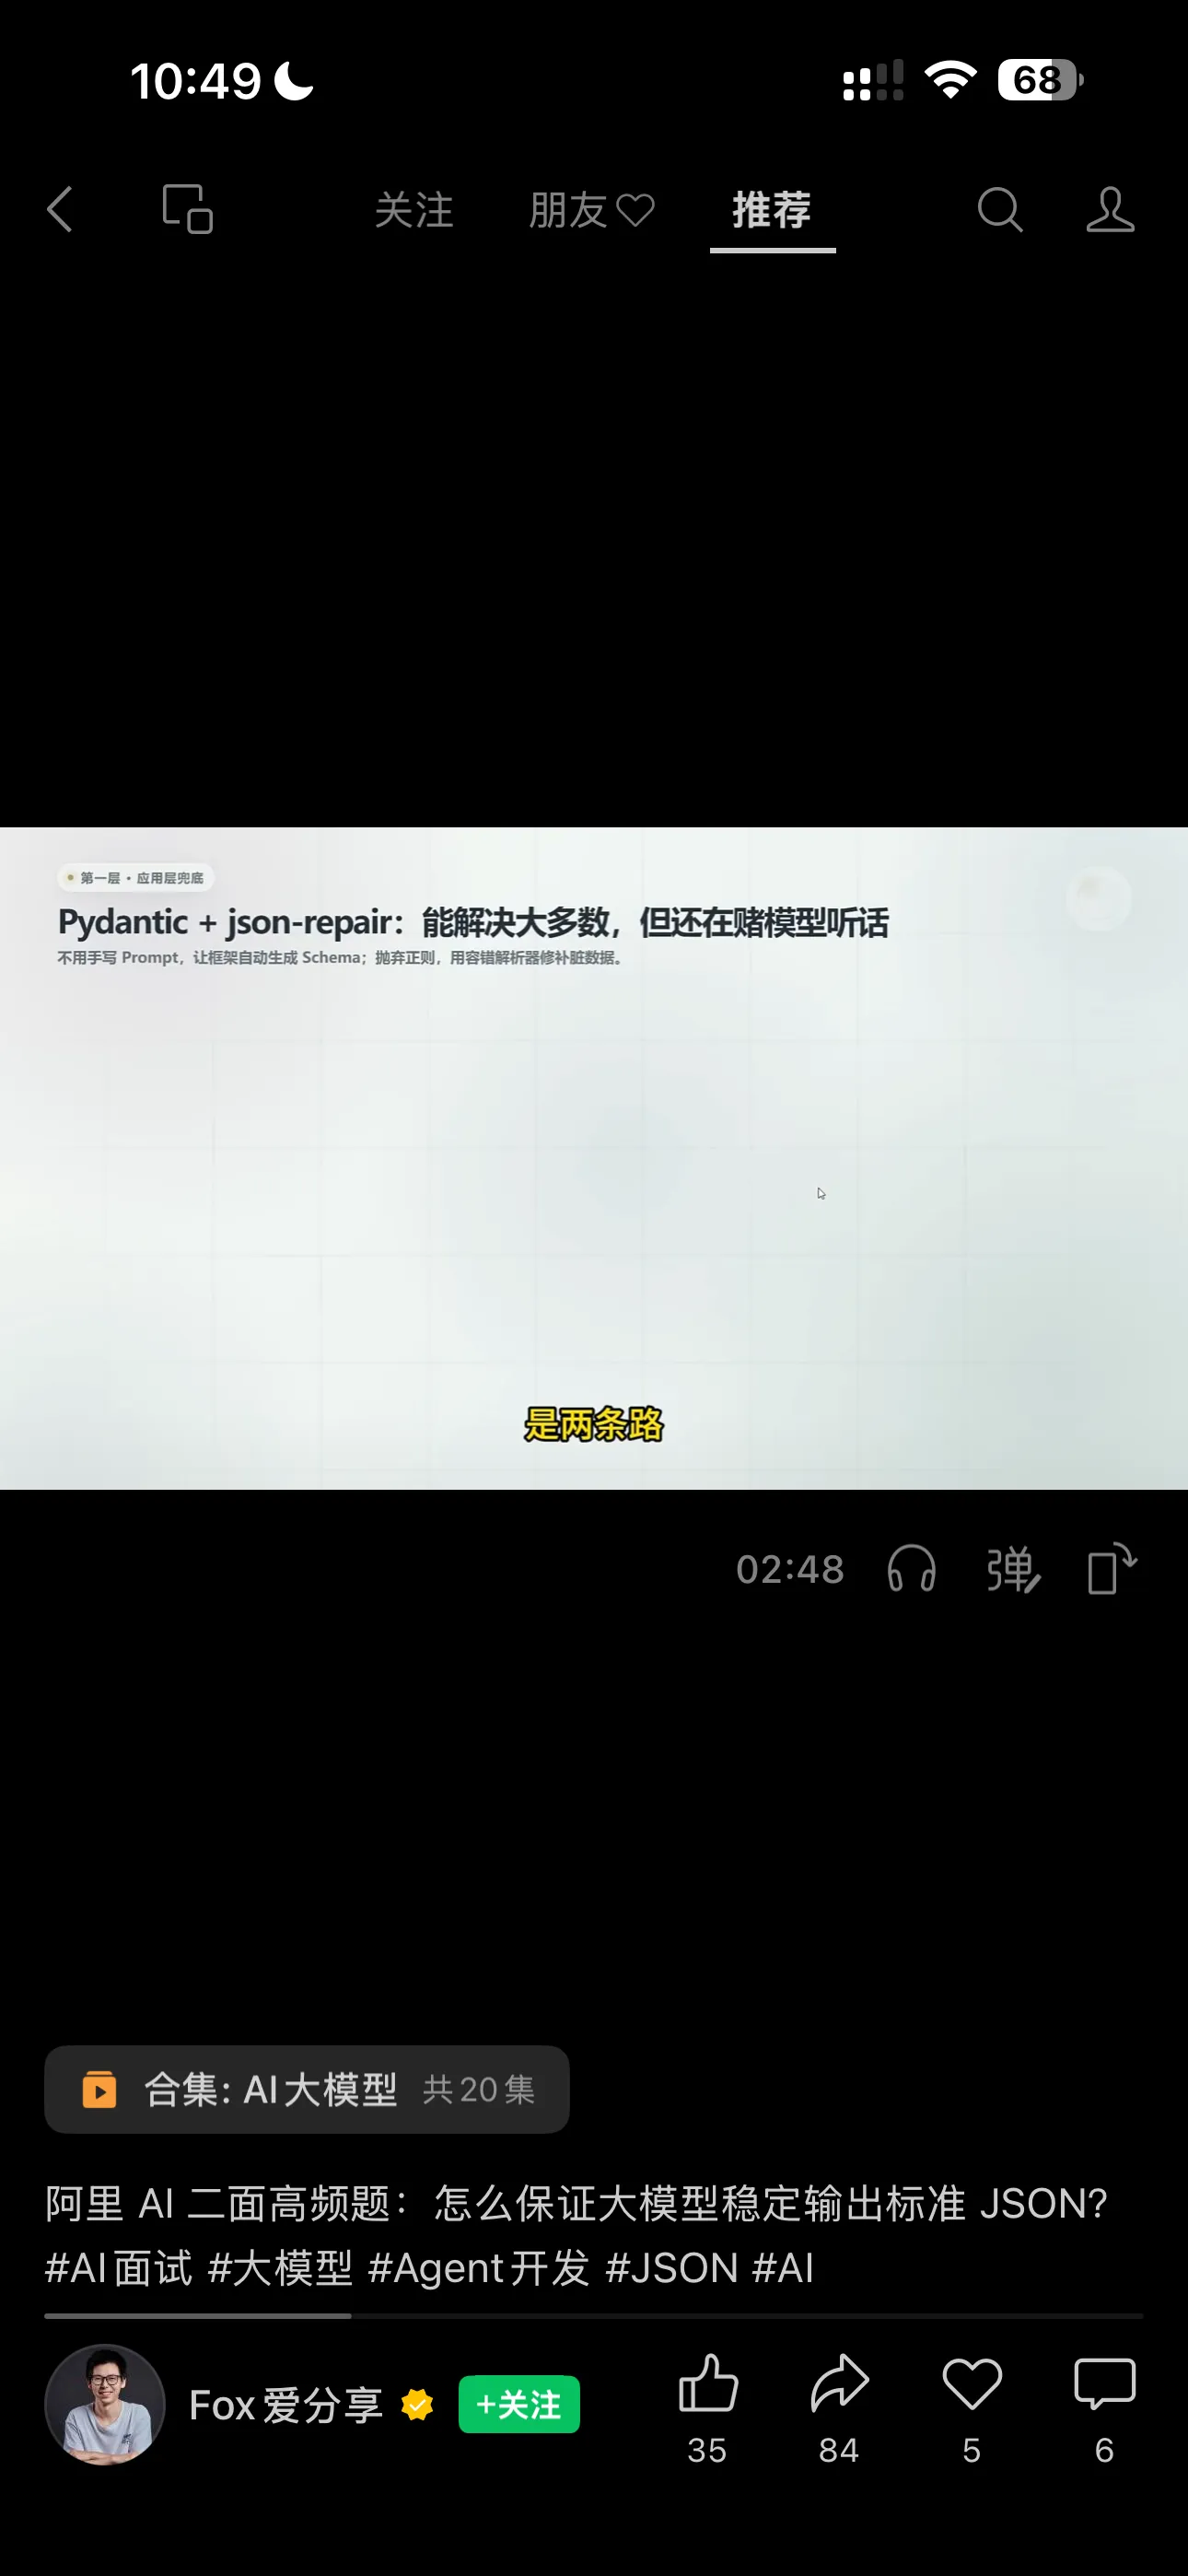
Pydantic 又是什么?
截图还提到了:
Pydantic + json-repair
你现在不用深入学 Pydantic 源码。
只要知道:
Pydantic 是 Python 世界里非常流行的数据验证工具。
例如开发者定义:
class Project:
    name: str
    year: int
AI 给:
{
  "name": "GC Dashboard",
  "year": 2026
}
Pydantic 检查:
name → string ✓
year → integer ✓
通过。
如果 AI 给:
{
  "name": "GC Dashboard",
  "year": "不知道"
}
就会发现:
year 应该是 integer
❌ validation error
所以它相当于一个数据质检员。
json-repair 又是什么?
名字已经很直白:
修 JSON。
AI 有时候输出:
{
  "name": "GC Dashboard",
  "year": 2026,
}
严格来说可能存在格式问题。
json-repair 之类的工具会尝试:
“我知道你大概想表达什么,我帮你修成合法 JSON。”
于是变成:
{
  "name": "GC Dashboard",
  "year": 2026
}
但这仍然属于事后修复。
所以截图视频才会认为:
Prompt
↓
AI 自由生成
↓
发现格式错
↓
repair
↓
validate
↓
失败再 retry
没有直接:
Schema
↓
模型按结构生成
↓
得到合法数据
那么稳。
把截图中的“三板斧”翻译成你能理解的语言
截图讲:
Prompt + 正则提取 + 重试
可以理解成:
① 求 AI:“拜托按这个格式回答。”
② AI 没完全听话 → 用代码从回答里把 JSON 挖出来。
③ 挖不出来 → 再叫 AI 回答一次。
所以作者认为:
Demo 可以,生产环境风险比较大。
更现代的思路是:
Structured Outputs
JSON Schema
Tool Calling
strict mode
也就是:
不再依赖“AI 自觉遵守格式”,而是在系统层面定义它能交付什么结构。
对你而言,真正应该掌握到什么程度?
你不是要转后端工程师,所以我不建议你现在跑去系统学 JSON Schema specification。
你作为 Design → AI / Design Engineer / Vibe Coding 方向,更重要的是建立这一层认知:
| 概念 | 你应该形成的直觉 |
|---|---|
| JSON | 软件之间传递结构化数据的常见格式 |
Object {} | 一组有名字的数据 |
Array [] | 一组数据 |
| key / value | 字段名 / 字段值 |
| Schema | 数据必须长什么样的规则 |
| JSON Schema | 用标准方式描述 JSON 的规则 |
| Validation | 检查数据是否符合规则 |
| API | 软件和软件沟通的接口 |
| Tool Calling | LLM 用结构化参数调用工具 |
| Structured Output | 强制/约束模型按照结构返回数据 |
| strict | 更严格遵守指定 Schema |
| Pydantic | Python 常见的数据定义/验证工具 |
| parser | 把返回的数据解析成程序能使用的形式 |
| retry | 失败后重新请求 |
| Agent | LLM + Tools + 执行循环等组成的系统 |
其中 JSON → Schema → API → Tool Calling → Agent 这条关系,你最好真正理解。
因为你以后看 Claude Code、Codex、MCP、Skills、Agent、API 文档,会反复碰到它们。
还有一个对你尤其重要的连接
你之前问过 MCP、Skills、Agent 是什么。现在其实可以把它们连接起来了:
                    你
                    ↓
                  Agent
                    ↓
          ┌─────────┴─────────┐
          ↓                   ↓
       Prompt              Context
          ↓
                  LLM
                   ↓
            Tool Calling
                   ↓
          Structured JSON
                   ↓
        ┌──────────┼──────────┐
        ↓          ↓          ↓
      Files       API        MCP
        ↓          ↓          ↓
      GitHub    Database    外部工具
这就是为什么当你从“让 Claude 帮我写一个页面”逐渐走向真正的 AI-native product / Agent system 时,JSON、Schema、API、Tool Calling 会越来越重要。
你已经不只是在学习“怎么 Prompt AI 写代码”,而是在开始碰到AI 如何被嵌进一个可靠的软件系统这个层面了。
交叉验证
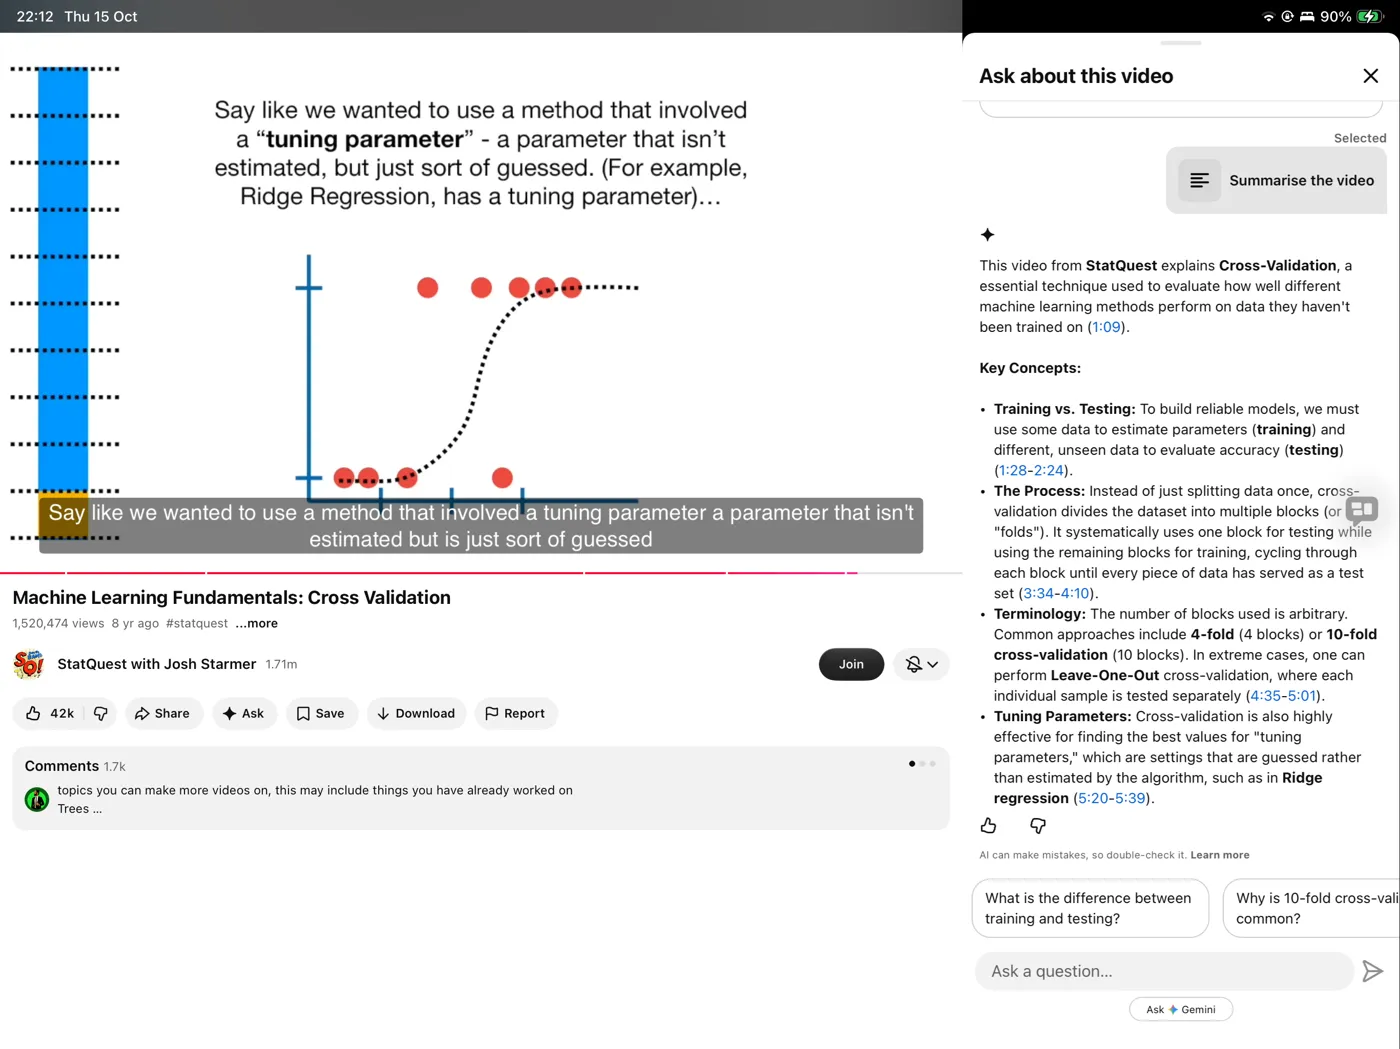
这一节我没懂cross
你正在看的这节是 StatQuest 的 Cross-Validation(交叉验证)。它是机器学习中非常重要的基础概念。
你截图里刚好讲到 Tuning Parameter(调优参数),这是交叉验证的一个重要用途。
我用一个具体例子解释,尽量不涉及数学。
1. 首先,为什么需要 Cross-Validation?
假设你正在开发一个 AI 模型,预测房价。
你收集了 100 套房屋的数据,包括面积、位置、房龄和实际售价。
你让模型学习这些数据,然后问:
“我的模型预测得准不准?”
问题来了:如果你拿模型已经学习过的房子来测试,它可能表现很好,但遇到新房子就预测不准。
这叫 Overfitting(过拟合)。
所以我们通常把数据分开:
但这里还有一个问题:
如果刚好抽到的那 20 套房子特别容易预测呢?
模型看起来准确,不代表它真的可靠。
交叉验证就是为了解决这个问题。
2. Cross-Validation 到底怎么工作?
Cross = 交叉,Validation = 验证。
核心思想是:
不要只验证一次,而是轮流使用不同的数据进行验证。
例如把 100 套房子分成 5 组,每组 20 套。
这样做的好处是:模型不会只依赖某一次幸运的数据划分来证明自己。
注意,每一轮通常都要重新训练模型,而不是让模型连续学习五次。
3. 那截图里的 Tuning Parameter 是什么?
这是视频接下来讨论的重点。
假设你有一个房价预测模型,但你可以调整它的复杂程度。
- 参数 A:模型非常简单,可能抓不住房价规律。
- 参数 B:模型复杂程度适中,可能表现最好。
- 参数 C:模型非常复杂,可能记住训练数据中的噪声。
那么应该选哪个?
交叉验证可以帮助你比较不同设置在未参与该轮训练的数据上的表现。
例如:
| 模型设置 | 5 轮平均预测误差 |
|---|---|
| A:简单 | 20 万元 |
| B:适中 | 13 万元 |
| C:复杂 | 18 万元 |
我们会倾向于选择 B,因为它在交叉验证中的平均误差最低。
这就是视频提到的 Ridge Regression 里的 Tuning Parameter(更准确地说是 Hyperparameter,超参数)的用途。
它不是完全凭感觉乱猜,而是先指定几个候选值,再利用交叉验证比较它们。
4. 你需要区分的三个概念
| 概念 | 作用 | 房价预测例子 |
|---|---|---|
| Training | 让模型学习规律 | 学习面积与房价的关系 |
| Validation | 帮助选择模型及超参数 | 比较哪种复杂程度更合适 |
| Testing | 最终检验模型在新数据上的表现 | 用此前完全未参与选择的数据评估 |
有一个重要细节:交叉验证通常用于训练阶段的模型选择,最终仍应保留独立的测试集。 否则反复选择最佳参数也可能让结果过于乐观。
5. 这和你做 AI 产品有什么关系?
你现在用 Claude Code、Codex 开发 AI 原型,交叉验证并不是你每天都需要直接操作的东西。
但它代表了一种非常重要的 AI 工程思维:
不要因为 AI 在一个例子里表现很好,就认为它具有可靠的泛化能力。
比如你设计一个 AI 助手,只用三条用户问题测试成功,并不能说明它在真实环境中可靠。
不过需要区分:LLM 产品通常还需要专门的评测方法(Evals),并不是直接把传统机器学习的 K-Fold Cross-Validation 套进去。
我想确认你是否真正理解了:
假设你有 100 条数据,使用 5-Fold Cross-Validation。
混淆矩阵
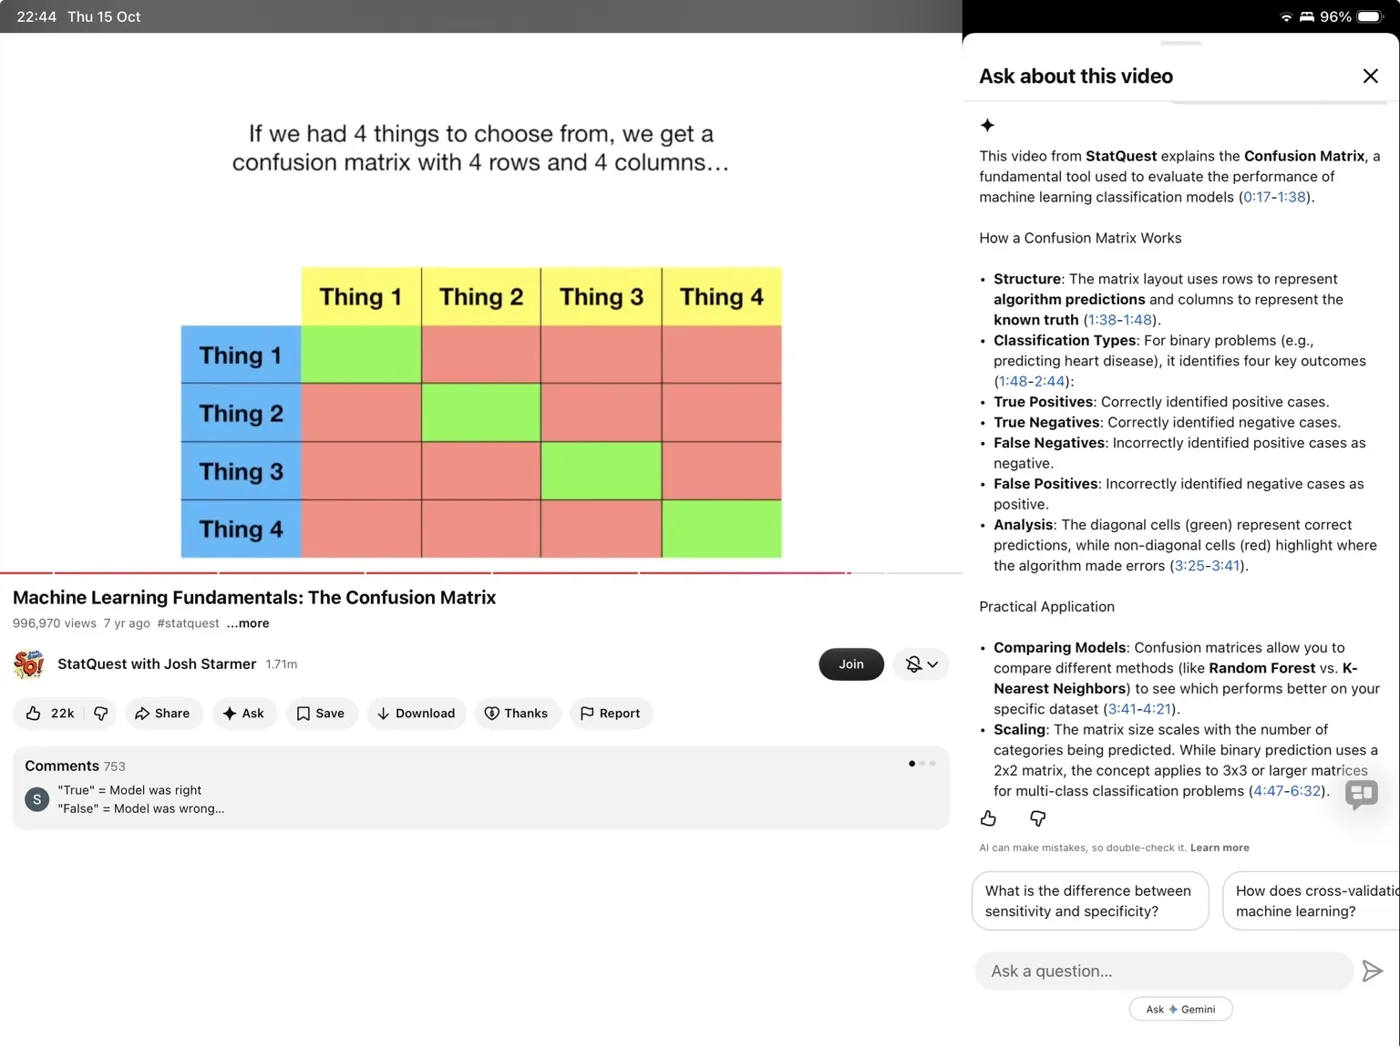
这一节是 Confusion Matrix(混淆矩阵),它和你刚刚学习的 Cross-Validation(交叉验证)有直接关系。
简单来说:
- Cross-Validation:如何更可靠地评估模型?
- Confusion Matrix:模型具体预测对了什么、错了什么?
混淆矩阵特别适合分类任务(Classification)。我用你比较熟悉的 AI 医疗影像筛查举例。
1. 什么是 Confusion Matrix?
假设 AI 正在判断乳腺筛查影像是否存在需要进一步检查的异常。
我们有 100 张已经知道真实结果的影像,让 AI 进行预测。
这个矩阵告诉你:
- TP(True Positive):真的异常,AI 也判断异常。
- TN(True Negative):真的正常,AI 也判断正常。
- FP(False Positive):其实正常,AI 却说异常,也叫误报。
- FN(False Negative):其实异常,AI 却说正常,也叫漏检。
这里的 Positive 代表我们关注的目标类别(例如异常),而不是“好”的意思。
2. 为什么不能只看 Accuracy(准确率)?
上面这个例子里,AI 预测正确了 85 张。
所以:
85% 看起来不错。
但在医疗筛查里,你可能更关心:
那 15 张错误中,有多少张是真正异常却被 AI 漏掉了?
因为误报和漏检的后果并不一样。
所以我们还需要:
| 指标 | 解释 | 示例结果 |
|---|---|---|
| Precision(精确率) | AI 说异常的,有多少真的异常? | 30/40 = 75% |
| Recall / Sensitivity(召回率/敏感度) | 真正异常的,有多少被 AI 找到了? | 30/35 ≈ 85.7% |
| Specificity(特异度) | 真正正常的,有多少被 AI 正确排除了? | 55/65 ≈ 84.6% |
这也是为什么在 AI 医疗产品里,仅仅报告 Accuracy 往往是不够的。
3. 回到你截图里的 4×4 矩阵
视频里使用的是四种 Thing 的例子。
这就是截图中为什么对角线是绿色的:
- 预测 Thing 1,真实也是 Thing 1,正确。
- 预测 Thing 2,真实也是 Thing 2,正确。
- 其他不在对角线上的组合,都是不同类型的分类错误。
真实的混淆矩阵通常会在每个格子中填入样本数量,而不只是颜色。
4. 和上一节 Cross-Validation 的关系
你可以把它们串联起来:
交叉验证负责评估流程;混淆矩阵负责展示分类结果。它们不是相互替代的技术。
5. 一个小问题,检验你是否理解
对你学习 AI Literacy 而言,理解 Confusion Matrix 为什么能揭示 Accuracy 隐藏的问题,比记住四个英文缩写更重要。
Sensitivity 与 Specificity
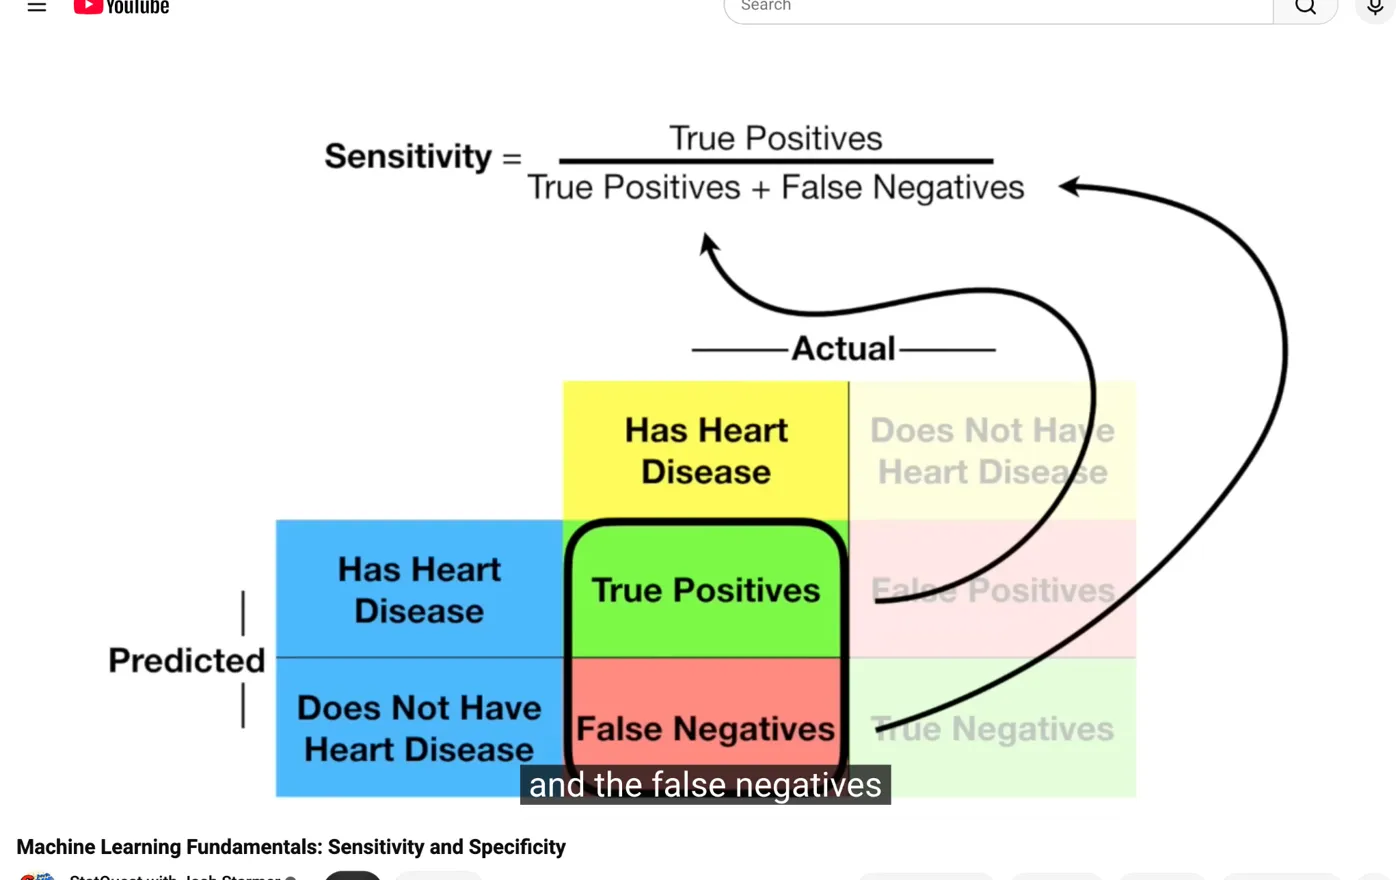
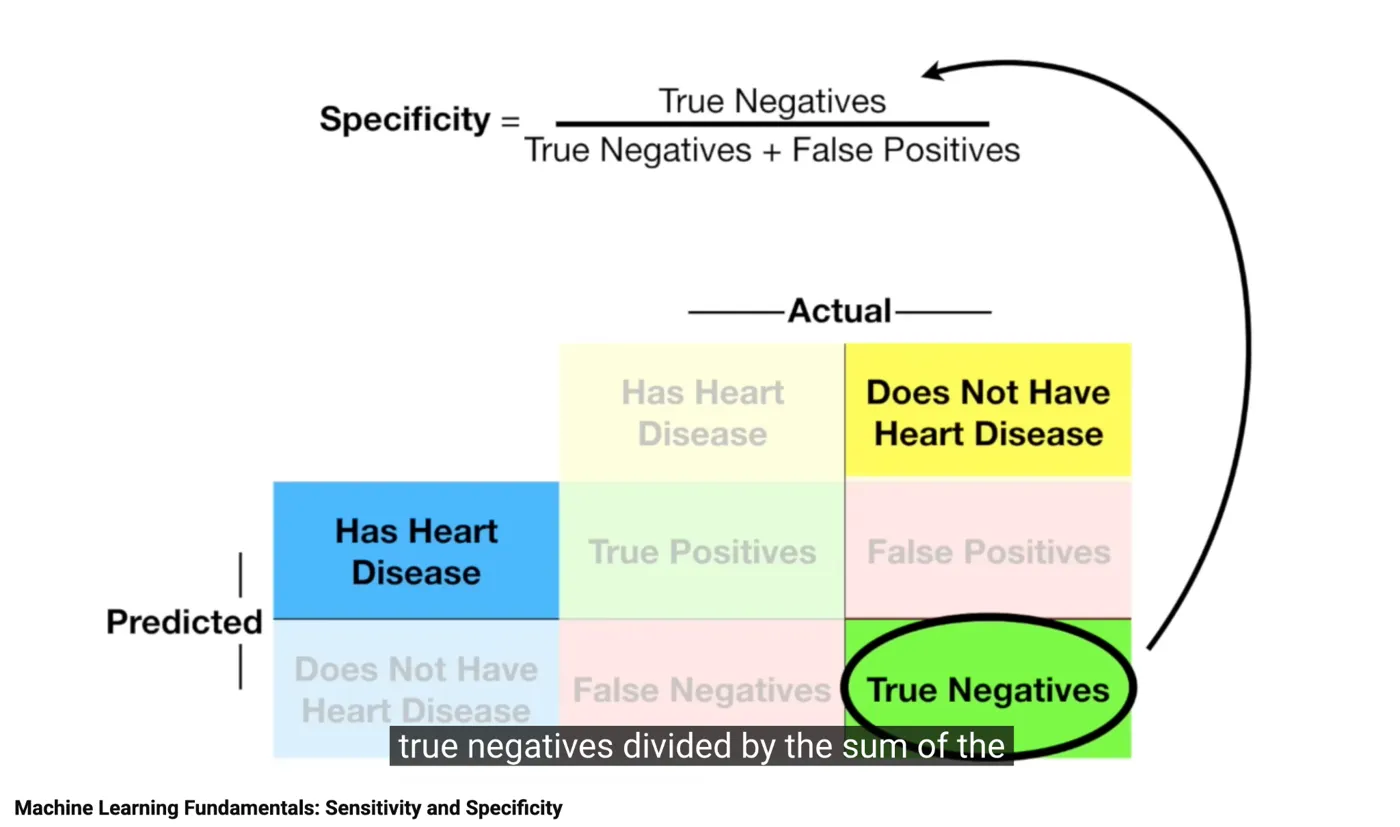
不懂
你这两张截图讲的是机器学习中两个非常重要的指标:
- Sensitivity(敏感度):真正有病的人,AI 能发现多少?
- Specificity(特异度):真正没病的人,AI 能正确排除多少?
它们看起来公式很复杂,但其实只有一个区别:一个只看有病的人,另一个只看没病的人。
我们沿用视频里的心脏病预测例子。
1. 先理解视频中的四个格子
假设医院有 100 个人,已经知道他们真实的健康状况,现在让 AI 预测是否有心脏病。
2. Sensitivity:专门看真正有病的人
视频中的公式:
翻译成人话:
所有真正有病的人里面,AI 成功发现了多少?
在我们的例子里,真正有病的有 35 人,其中 30 人被发现,5 人被漏检。
所以 Sensitivity 越高,意味着漏掉真正患者的比例越低。
3. Specificity:专门看真正没病的人
公式:
翻译成人话:
所有真正没病的人里面,AI 成功判断为健康的有多少?
真正没病的有 65 人,其中 55 人被正确排除,10 人被误报为有病。
所以 Specificity 越高,意味着健康的人被误报的比例越低。
4. 为什么要有两个指标,而不是一个?
因为一个 AI 模型可能特别擅长发现疾病,却经常把健康的人也判断为有病。
下面你可以亲自调整 AI 的判断倾向,看看两个指标如何变化。
你会发现:
- 降低门槛:通常 Sensitivity 提高,漏检减少,但误报增加。
- 提高门槛:通常 Specificity 提高,误报减少,但漏检增加。
这就是机器学习里经常提到的 Sensitivity–Specificity Trade-off(敏感度与特异度的权衡)。
当然,并不是所有模型都有同样的权衡曲线,真实表现需要用数据验证。
5. 最后,只记住这两句话就行
| Sensitivity | Specificity | |
|---|---|---|
| 关注谁? | 真正有病的人 | 真正没病的人 |
| 关心什么? | 有没有漏掉患者? | 有没有冤枉健康者? |
| 希望减少 | False Negative(漏检) | False Positive(误报) |
你之前做的乳腺筛查 Human–AI Disagreement 项目,其实就涉及这两个指标背后的权衡:减少漏检和避免不必要的召回。
现在检验一下:
多分类 Sensitivity
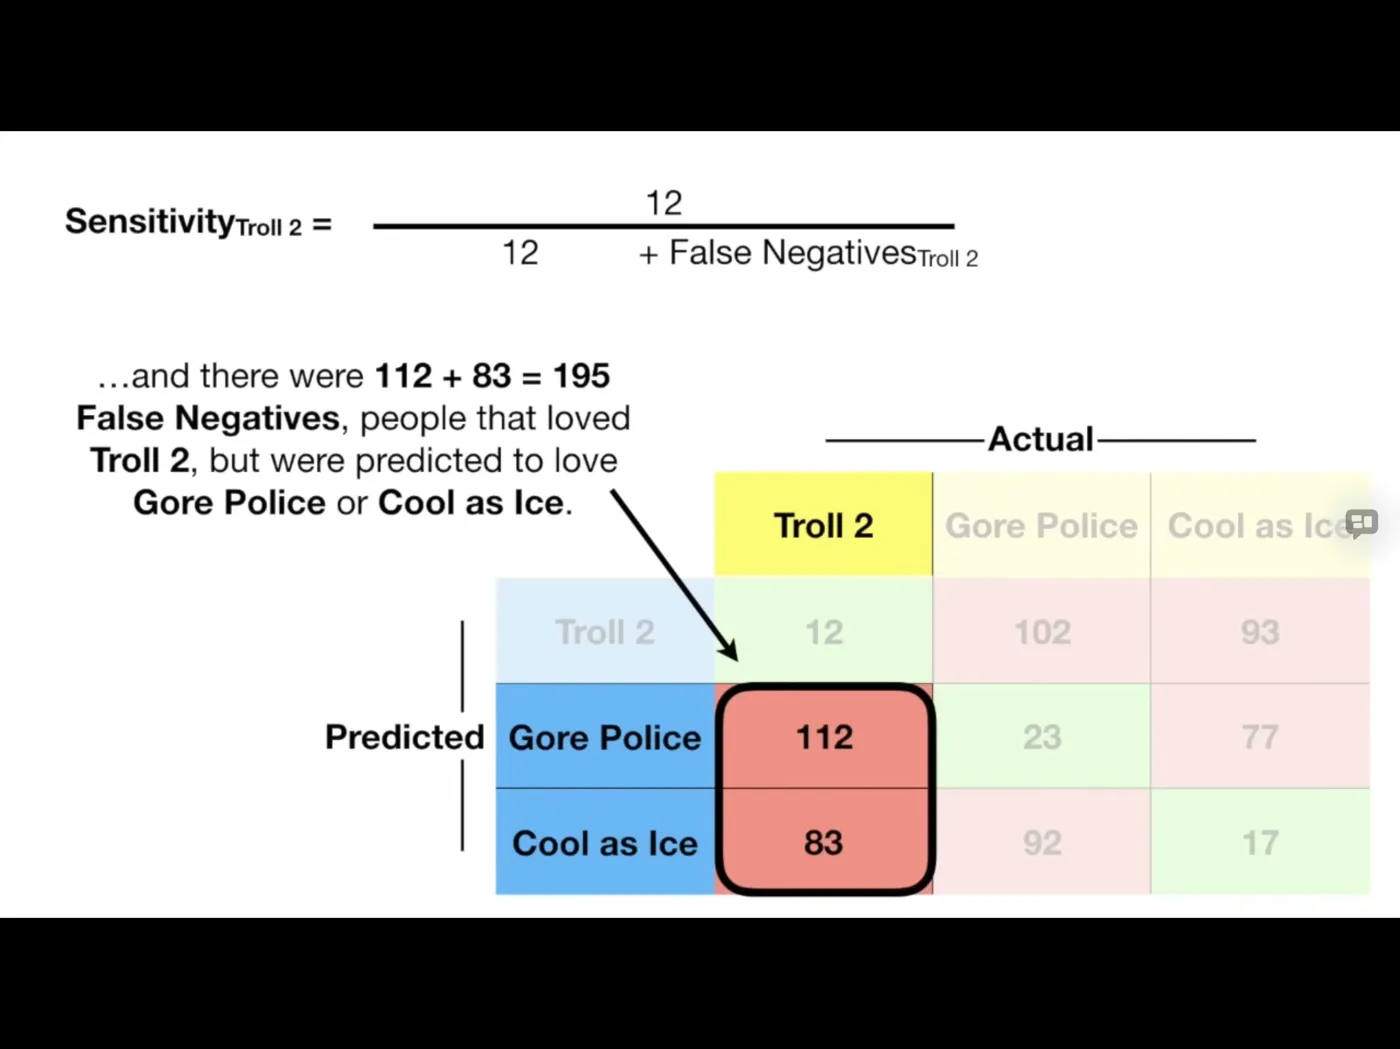
这张截图是 StatQuest 在讲 多分类(Multi-class Classification)情况下,如何计算 Sensitivity(敏感度)。
和上一节只有两种结果(有病 / 没病)不同,现在有三种电影:
- Troll 2
- Gore Police
- Cool as Ice
AI 的任务是预测一个人最喜欢哪部电影。
关键在于:即使有三个类别,我们依然可以单独计算其中某个类别的 Sensitivity。
1. 先看懂这张表
我把截图中的数据整理一下:
| AI 预测 ↓ / 真实 → | Troll 2 | Gore Police | Cool as Ice |
|---|---|---|---|
| Troll 2 | 12 | 102 | 93 |
| Gore Police | 112 | 23 | 77 |
| Cool as Ice | 83 | 92 | 17 |
现在我们只关心 Troll 2,暂时不管另外两部电影之间的区别。
真实喜欢 Troll 2 的人,一共有:
其中:
- 12 人(TP):真的喜欢 Troll 2,AI 也预测他们喜欢 Troll 2。
- 112 人(FN):真的喜欢 Troll 2,但 AI 错误预测他们喜欢 Gore Police。
- 83 人(FN):真的喜欢 Troll 2,但 AI 错误预测他们喜欢 Cool as Ice。
因此,False Negatives 一共有:
2. 为什么 112 和 83 都是 False Negative?
因为我们现在把 Troll 2 当作 Positive(目标类别)。
只要 AI 没有识别出真正喜欢 Troll 2 的人,无论错误预测成哪一部电影,都属于 False Negative。
这说明模型识别 Troll 2 爱好者的能力很差。
3. 多分类与二分类有什么不同?
实际上公式完全一样:
区别只在于:
| 二分类 | 多分类 |
|---|---|
| 只有一个其他类别 | 可能有多个其他类别 |
| FN 来自一个错误预测类别 | FN 需要把所有其他错误预测类别加起来 |
| 比如有病 / 没病 | 比如三种电影 |
这种把某个类别单独拿出来,其他类别都当作“非该类别”的计算方法,叫 One-vs-Rest(一对其余)。
4. 你来试试 Gore Police
- Troll 2:102 人
- Gore Police:23 人
- Cool as Ice:92 人
你现在只需要记住一个判断方法:
计算 Sensitivity 时,先找到 Actual(真实结果)中的目标类别,然后看这一整列有多少人被正确识别。
这也是为什么你截图里的箭头只指向 Troll 2 那一列,而不是整张混淆矩阵。
多分类 Specificity
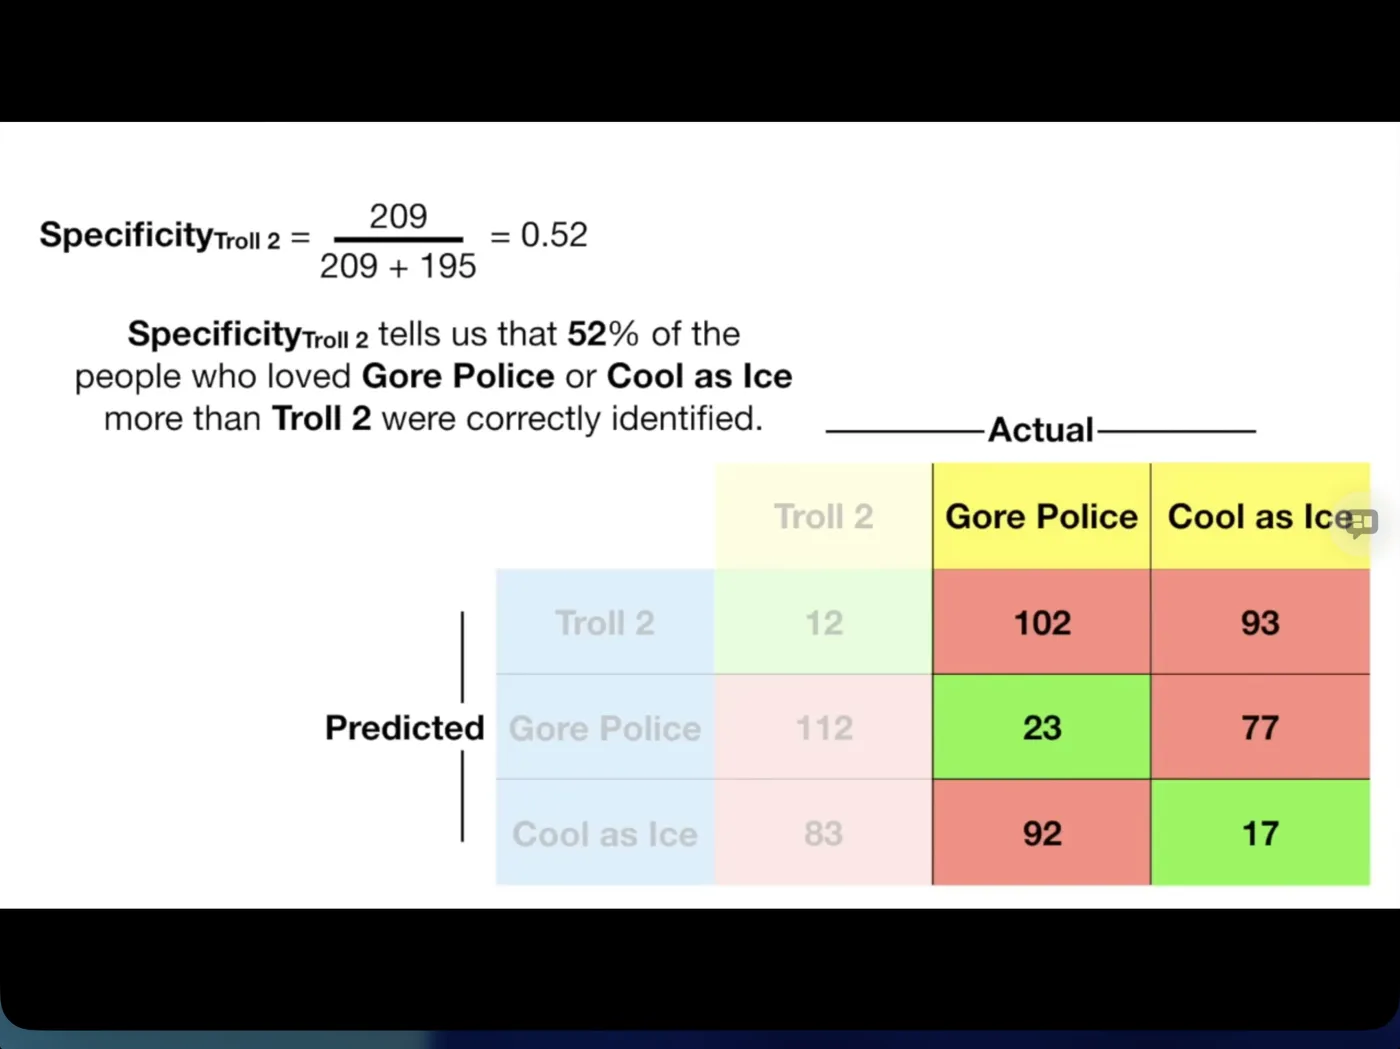
这张截图继续讲 Specificity(特异度),但现在从二分类变成了三分类,所以看起来复杂了一点。
你可能最困惑的是:为什么 209 算 True Negative,而 195 算 False Positive?明明表格里还有很多预测错误的数字。
关键是:我们现在只评价 AI 能否正确区分 Troll 2 和非 Troll 2,而不关心另外两部电影之间有没有分对。
1. 把三分类变成二分类
原来有三部电影:
- Troll 2
- Gore Police
- Cool as Ice
现在只问一个问题:
对于真正不喜欢 Troll 2、而更喜欢另外两部电影的人,AI 有多少次成功判断他们不是 Troll 2 的爱好者?
这就是 Troll 2 的 Specificity。
2. 为什么是 209 和 195?
绿色四格:209(True Negatives)
这些人实际上喜欢另外两部电影,AI 也没有把他们预测成 Troll 2。
即使 AI 把 Gore Police 错认成 Cool as Ice,在当前这个 Troll 2 的二分类问题中,依然算 True Negative。
红色两格:195(False Positives)
这些人实际上喜欢其他电影,但 AI 错误预测他们喜欢 Troll 2。
所以:
也就是截图中的 52%。
3. 和上一张 Sensitivity 截图对比
| Sensitivity | Specificity | |
|---|---|---|
| 关注的人 | 真正喜欢 Troll 2 | 真正不喜欢 Troll 2 |
| 要回答的问题 | AI 找到了多少? | AI 正确排除了多少? |
| 计算 | 12 / 207 | 209 / 404 |
| 结果 | 5.8% | 51.7% |
这里特别容易混淆:上一张图中的 195 是 False Negatives(112+83);而这一张图中的 195 是 False Positives(102+93)。
数字碰巧相同,但对应的是完全不同的两组人。
4. 一个问题,看看你是否理解
最重要的理解:在多分类问题中计算某一个类别的 Sensitivity 或 Specificity 时,要暂时把其他所有类别合并为一个“非目标类别”。 这样三分类就变成了熟悉的二分类问题。
另一类别的 Specificity
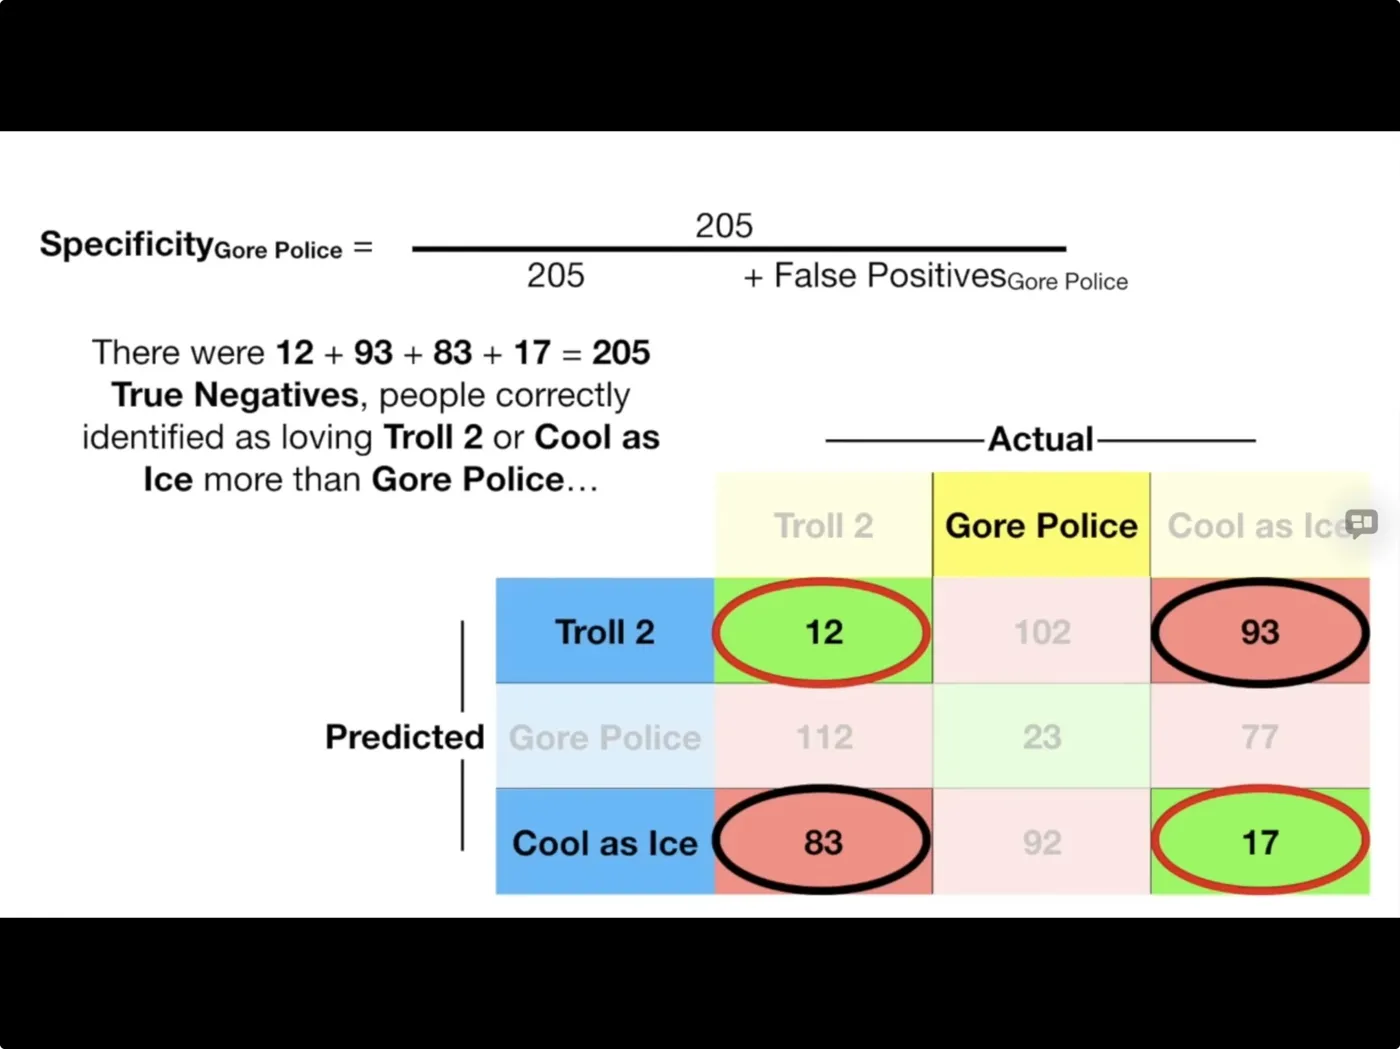
这张图是在计算 Gore Police 的 Specificity(特异度)。
它和上一张 Troll 2 的计算方法完全相同,只是这次我们把 Gore Police 当作 Positive(目标类别)。
这里最容易困惑的是:为什么 93 和 83 明明是预测错误,却也被算进 True Negatives(TN)?
1. 先只关注 Gore Police
我们暂时把三部电影合并成两类:
- Positive:Gore Police
- Negative:Troll 2 或 Cool as Ice
Specificity 要回答的是:
真正不喜欢 Gore Police 的人,有多少被 AI 正确判断为“不是 Gore Police”?
2. 为什么 205 是 True Negatives?
看看截图中被圈出的四个数字:
绿色的四个数字:
它们都满足两个条件:
- 真实类别不是 Gore Police。
- AI 预测的类别也不是 Gore Police。
所以都算 TN。
特别注意 93 和 83:
虽然 AI 混淆了 Troll 2 和 Cool as Ice,但它没有把这两类误判成 Gore Police。
因此,在 Gore Police 的 One-vs-Rest 评估中,它们仍然是 True Negatives。
3. 那 False Positives 是多少?
观察 Gore Police 这一行,排除真正属于 Gore Police 的 23 人。
剩下:
因为这 189 人实际上喜欢其他电影,却被 AI 错误预测为 Gore Police。
因此:
4. 一个简单的记忆方法
在这张表里:
Sensitivity:看目标类别那一列。
Specificity:排除目标类别那一列,再检查 AI 有没有错误预测成目标类别。
你现在看到的计算方式叫 One-vs-Rest,是多分类机器学习里常见的评估方法。
Bias 与 Variance
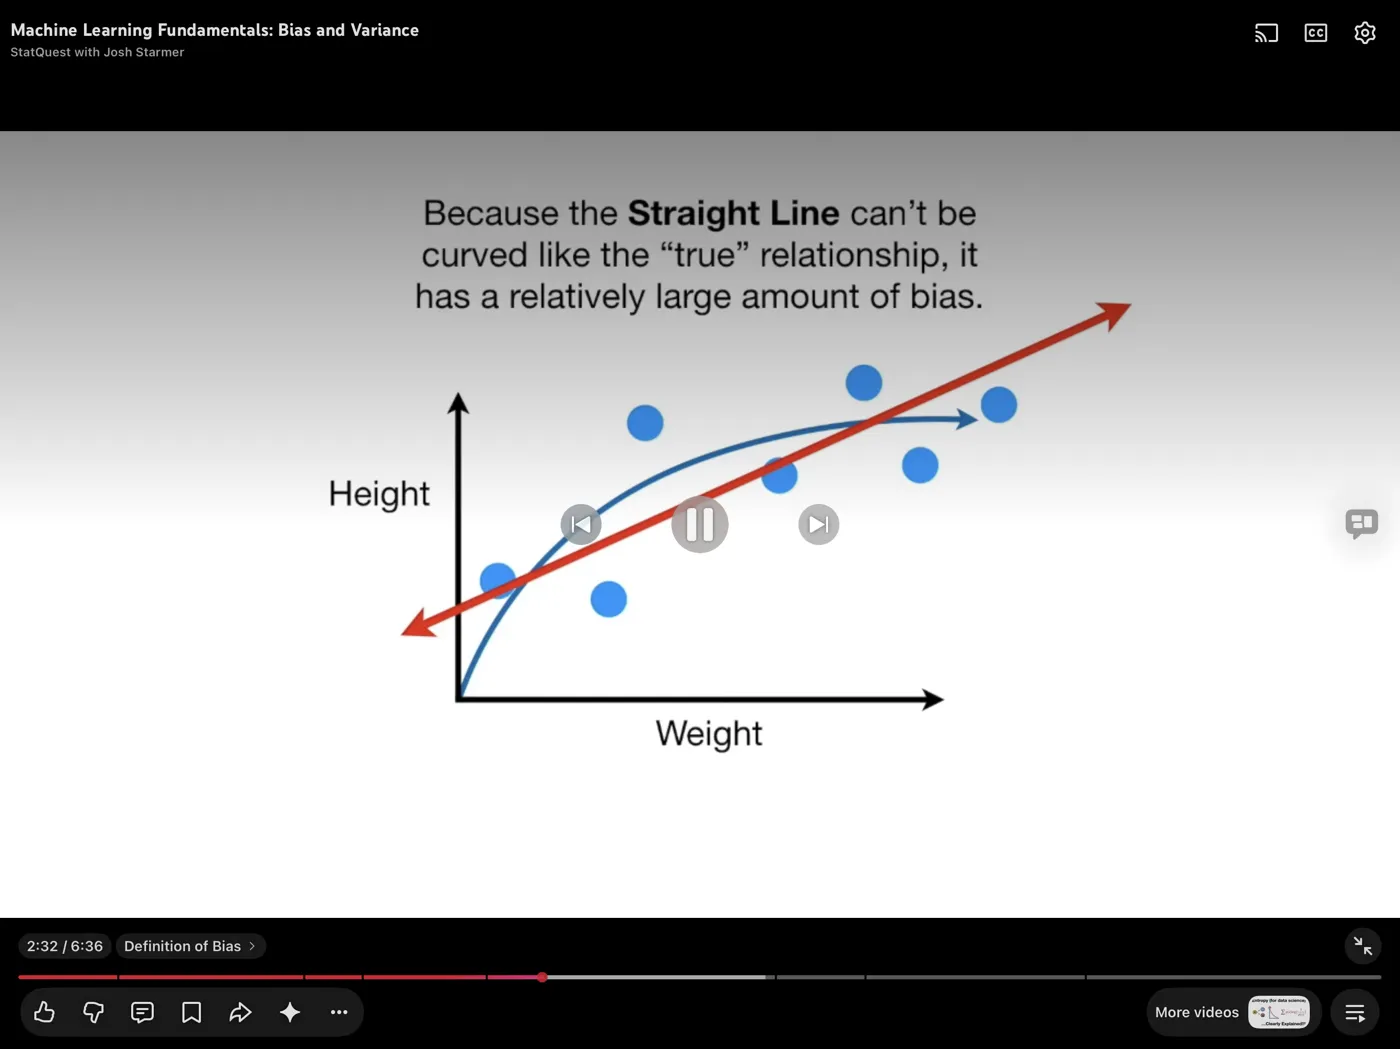
你现在学到的是 StatQuest 的 Bias and Variance(偏差与方差)。这是机器学习里非常核心的概念,也能帮助你理解之前的 Overfitting(过拟合)和 Cross-Validation(交叉验证)。
这张截图正在解释 Bias(偏差)。我们先理解它,再看 Variance。
1. 先看懂截图里的三种元素
视频里的横轴是 Weight(体重),纵轴是 Height(身高)。
假设真实关系是蓝色曲线:体重增加时,身高先快速增加,后来增长趋缓。
但你选择了一个只能画直线的模型。
无论怎么调整红线的斜率,它都无法完整表现蓝色曲线。
这就是 High Bias(高偏差)的直观表现:模型本身太简单,无法捕捉数据背后的真实规律。
这种情况也经常被称为 Underfitting(欠拟合)。
2. 那 Variance(方差)是什么?
Bias 关注的是模型预测是否存在系统性偏离。
Variance 关注的是:
如果换一批训练数据,模型的预测会不会发生很大的变化?
例如我们用不同的数据训练同一种模型。
- Low Variance(低方差):换数据后,模型预测变化不大。
- High Variance(高方差):换数据后,模型预测变化很大。
高方差模型可能过度学习训练数据中的偶然噪声,因此容易 Overfitting(过拟合)。
3. 你可以用这个实验理解两者
你可以先选择简单模型,不断点击“换一组数据”,再切换复杂模型重复操作。
4. Bias 和 Variance 的区别
| Bias(偏差) | Variance(方差) | |
|---|---|---|
| 核心问题 | 模型是否存在系统性偏离? | 模型对训练数据变化是否敏感? |
| 典型原因 | 模型过于简单、假设不合适 | 模型过于灵活、容易追随噪声 |
| 常见关联 | Underfitting(欠拟合) | Overfitting(过拟合) |
| 理想目标 | 较低 | 较低 |
这里还有一个重要概念:Bias–Variance Trade-off(偏差与方差的权衡)。
如果模型太简单,可能偏差高;如果模型过度复杂,可能方差高。我们的目标不是让模型无限复杂,而是找到能够较好泛化到新数据的复杂程度。
这也解释了你之前学的 Cross-Validation 为什么重要:它可以帮助比较不同模型的泛化表现,选择合适的复杂程度。
你现在这张截图最重要的就是理解一句话:红色直线不是没有努力拟合,而是它的表达能力受到限制,无法表示蓝色曲线,因此产生了较高的 Bias。
接下来视频如果讲到 Variance,可以继续截图给我,我们就沿着这个例子理解。
激活函数
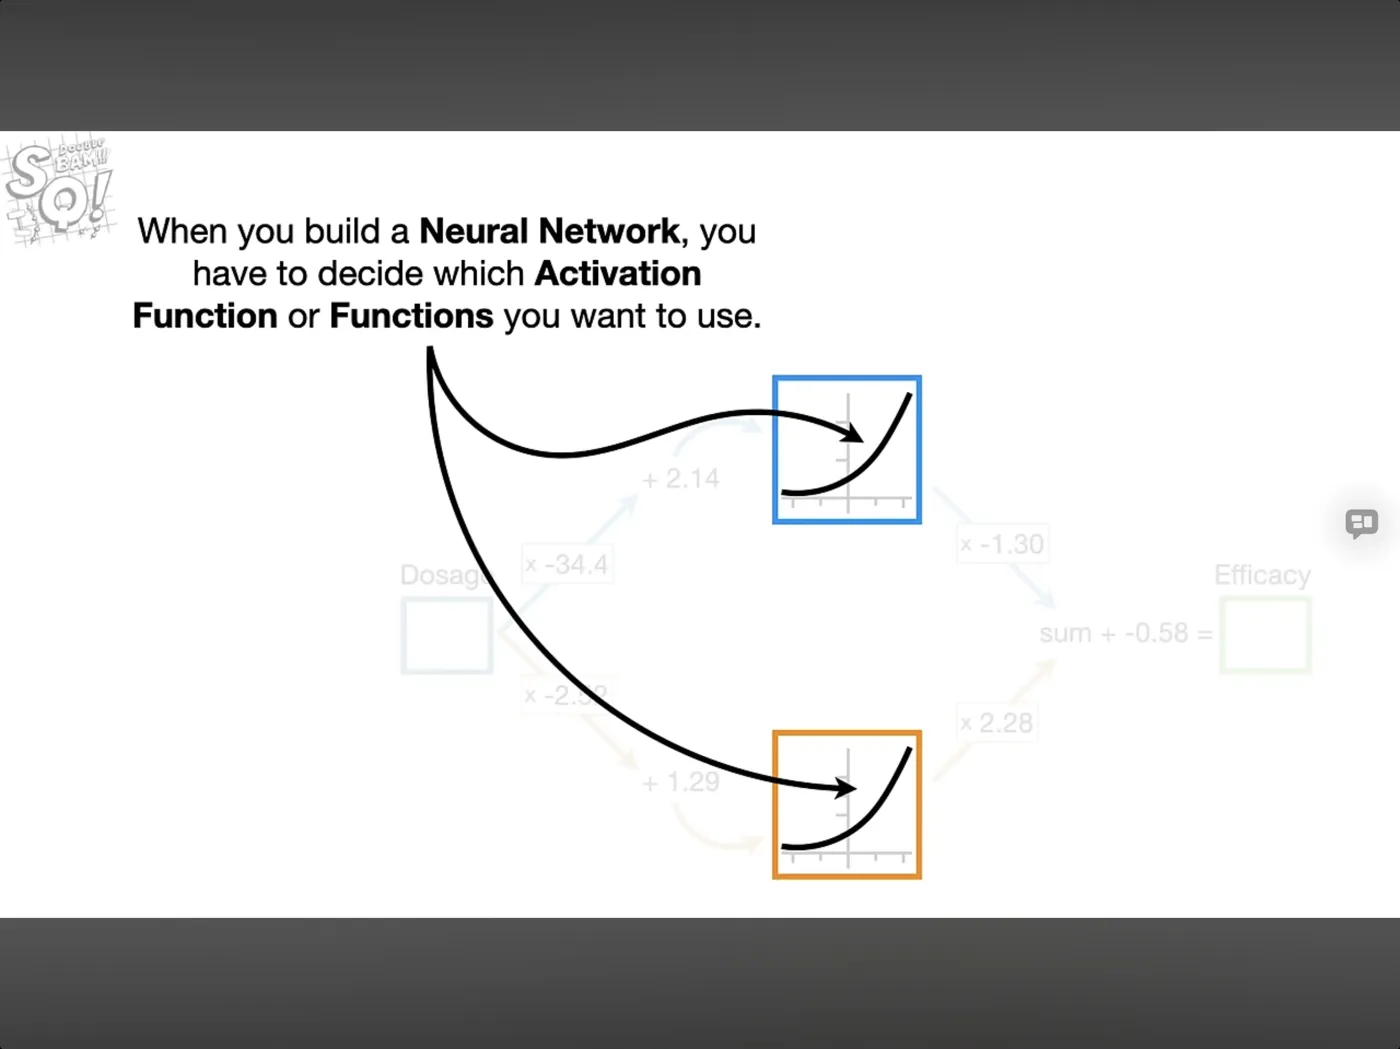
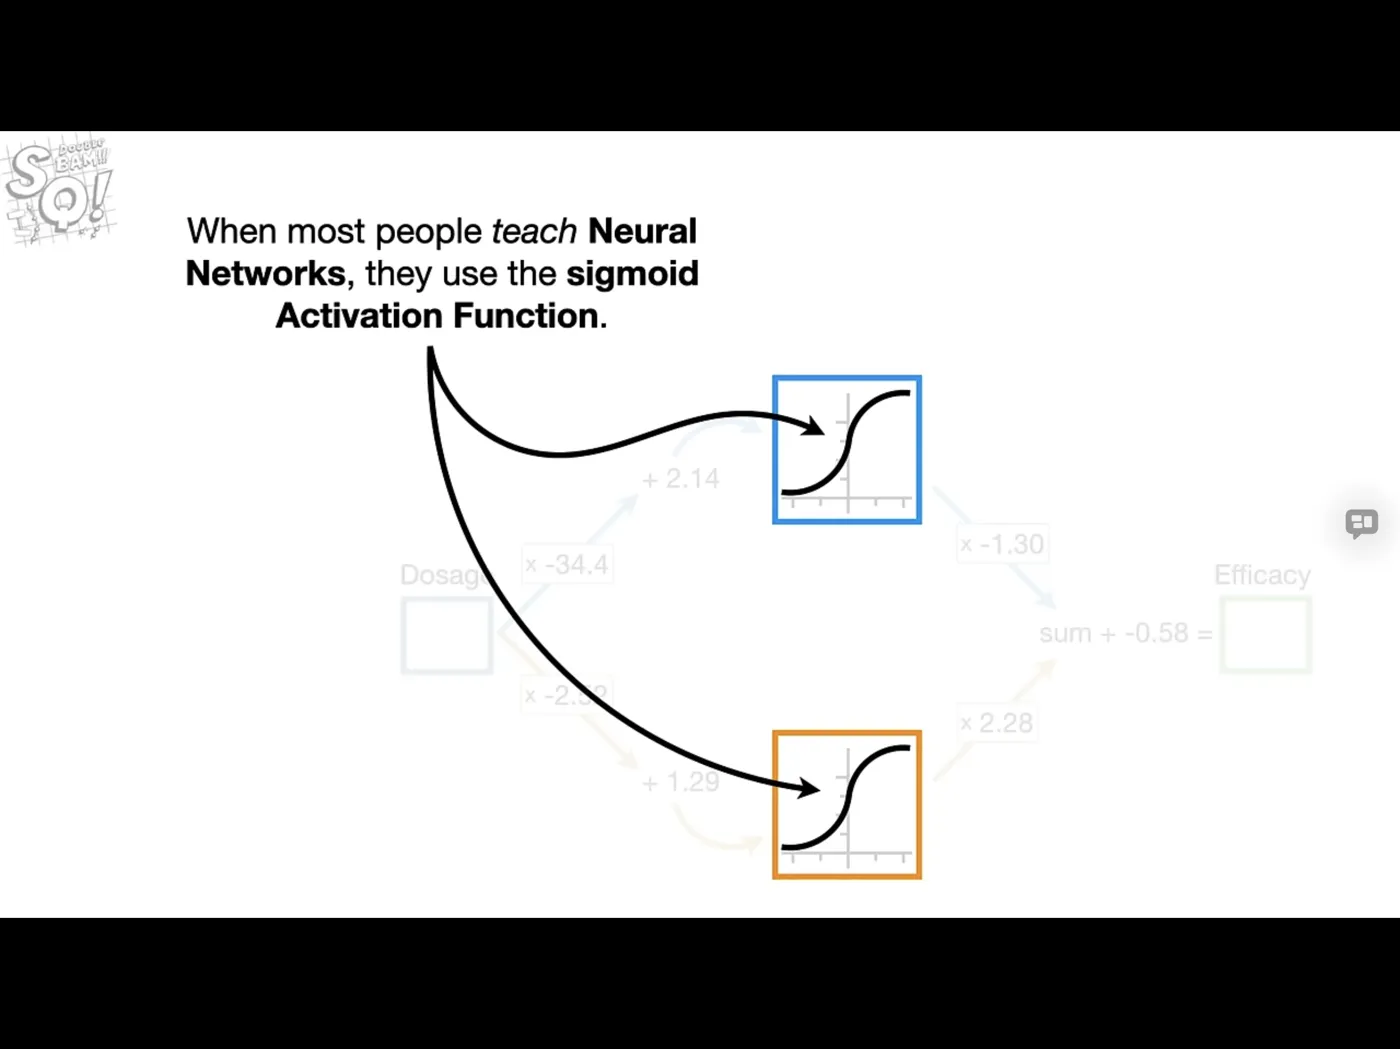
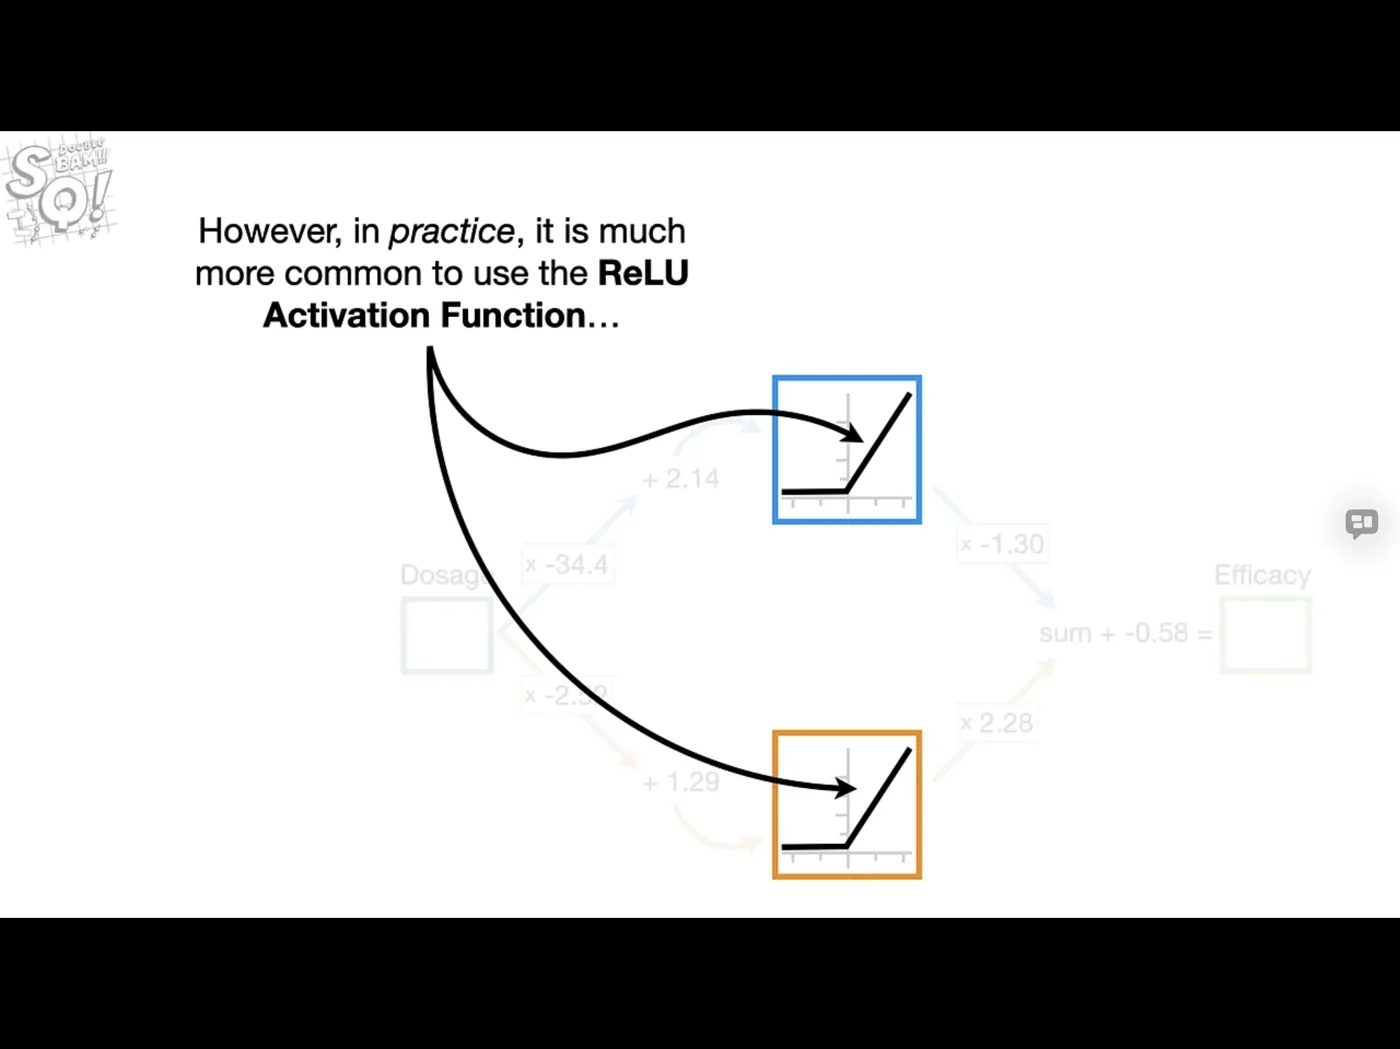
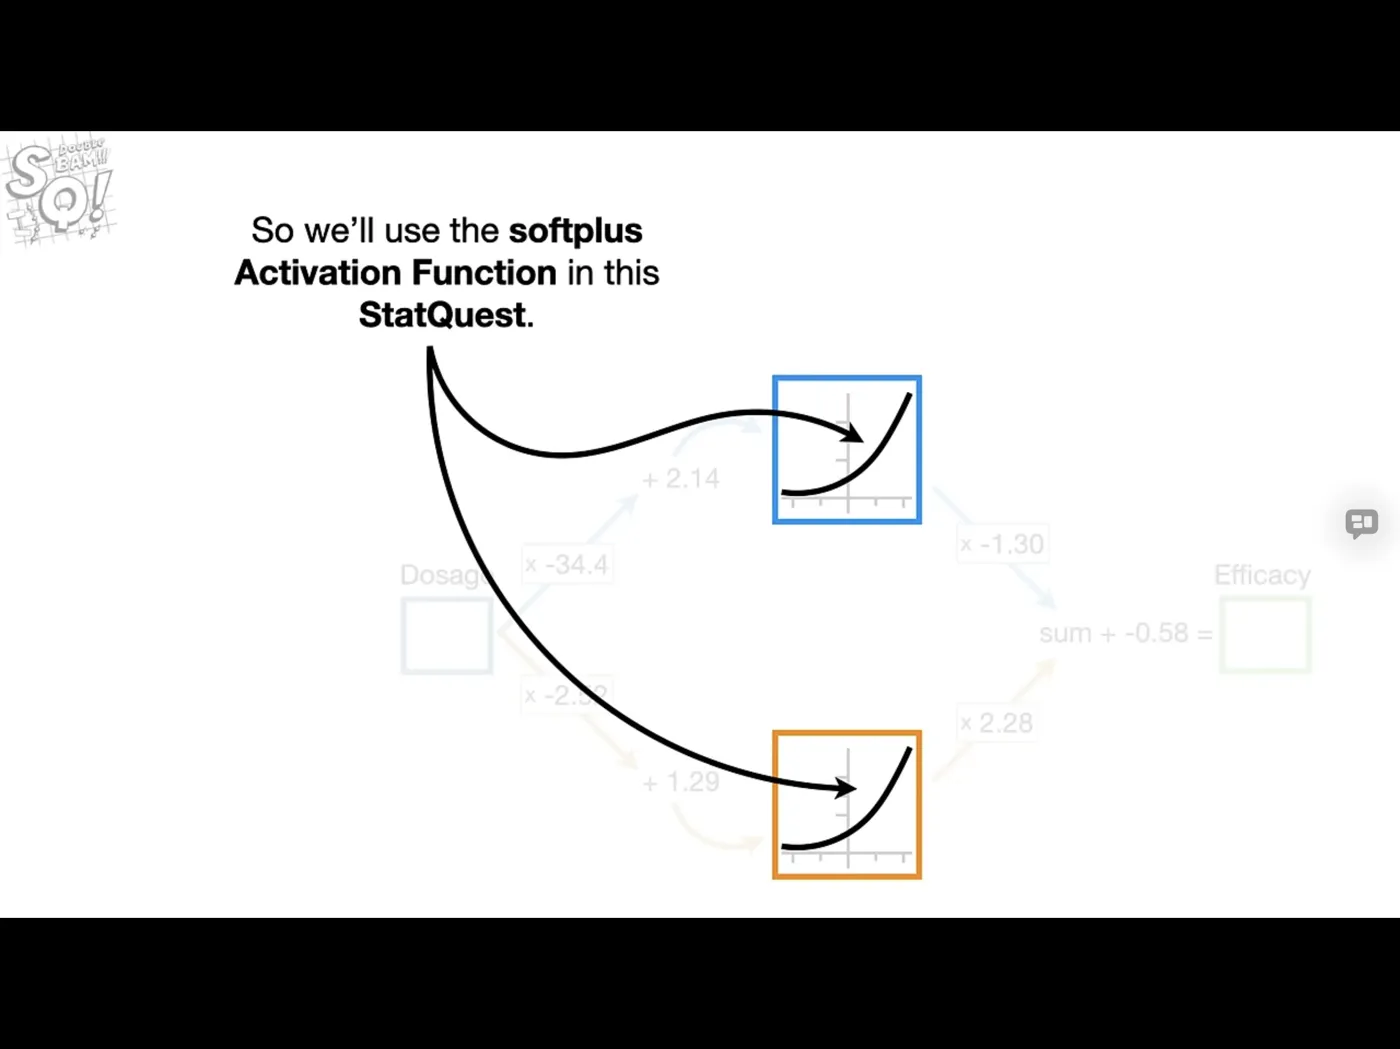
你这四张截图讲的是神经网络(Neural Network)里的一个重要概念:Activation Function(激活函数)。
视频依次介绍了三种激活函数:Sigmoid、ReLU 和 Softplus。
它们看起来是三种不同的曲线,但本质上都在解决同一个问题:
如何让神经网络学习复杂的、非线性的关系,而不只是简单的直线关系?
1. 为什么神经网络需要激活函数?
先看截图背后的神经网络:
假设我们希望 AI 学会预测药物剂量(Dosage)与药物效果(Efficacy)的关系。
现实中,这种关系未必是直线。例如药物剂量增加,效果可能先增强,后来趋于平缓。
如果神经网络只有线性运算,即使叠加很多层,最终仍然只能表示线性关系。
激活函数的作用,就是在神经网络中引入非线性,让模型能够表达更复杂的规律。
2. 三种激活函数有什么区别?
Sigmoid:把数字压缩到 0–1
不管输入多大或多小,Sigmoid 的输出都会落在 0 和 1 之间。
例如:
- 输入 -5 → 输出约 0.007
- 输入 0 → 输出 0.5
- 输入 5 → 输出约 0.993
因此它适合某些需要 0–1 输出的场景,例如二分类模型的输出层。
但它在两端容易出现梯度很小的问题,使某些深层网络难以训练。
ReLU:负数变 0,正数保持不变
ReLU 的规则特别简单:
例如:
- 输入 -5 → 输出 0
- 输入 0 → 输出 0
- 输入 5 → 输出 5
因为计算简单,而且正数区域的梯度不会像 Sigmoid 那样趋于零,ReLU 及其变体在很多深度神经网络中非常常见。
Softplus:平滑版本的 ReLU
Softplus 的曲线和 ReLU 很像,但在转折处没有尖角。
它的公式是:
它可以理解成一个平滑的 ReLU,不过两者并不完全相同。
截图中的 StatQuest 选择 Softplus 来继续讲解,是因为它的曲线平滑,方便展示神经网络中的计算和训练过程,不代表 Softplus 总比 ReLU 好。
3. 你可以亲自改变输入,看看它们怎么计算
4. 这和你前面学的 Bias、Variance 有什么关系?
你之前学习过:
- 模型太简单,可能产生 High Bias(高偏差)。
- 模型太复杂、对训练数据过于敏感,可能产生 High Variance(高方差)。
激活函数与这些概念有联系,但不是一回事。
激活函数帮助神经网络表示非线性关系,提升表达能力;而 Bias 和 Variance 关注模型的系统性偏差及其对训练数据变化的敏感程度。
选择激活函数只是神经网络设计中的一个决定。模型的层数、神经元数量、训练数据、正则化等也都会影响最终表现。
5. 对你目前的 AI 学习,掌握到什么程度就够了?
我建议你现阶段重点理解三件事:
- Neuron(神经元):接收数值,进行加权求和与偏置计算,再经过激活函数。
- Activation Function(激活函数):让神经网络能够表达非线性关系。
- Training(训练):通过调整权重和偏置,让网络输出逐渐接近目标结果。
暂时不需要背 Sigmoid、ReLU、Softplus 的数学公式,也不需要自己实现它们。
最后检验一个理解:
学习难度反馈
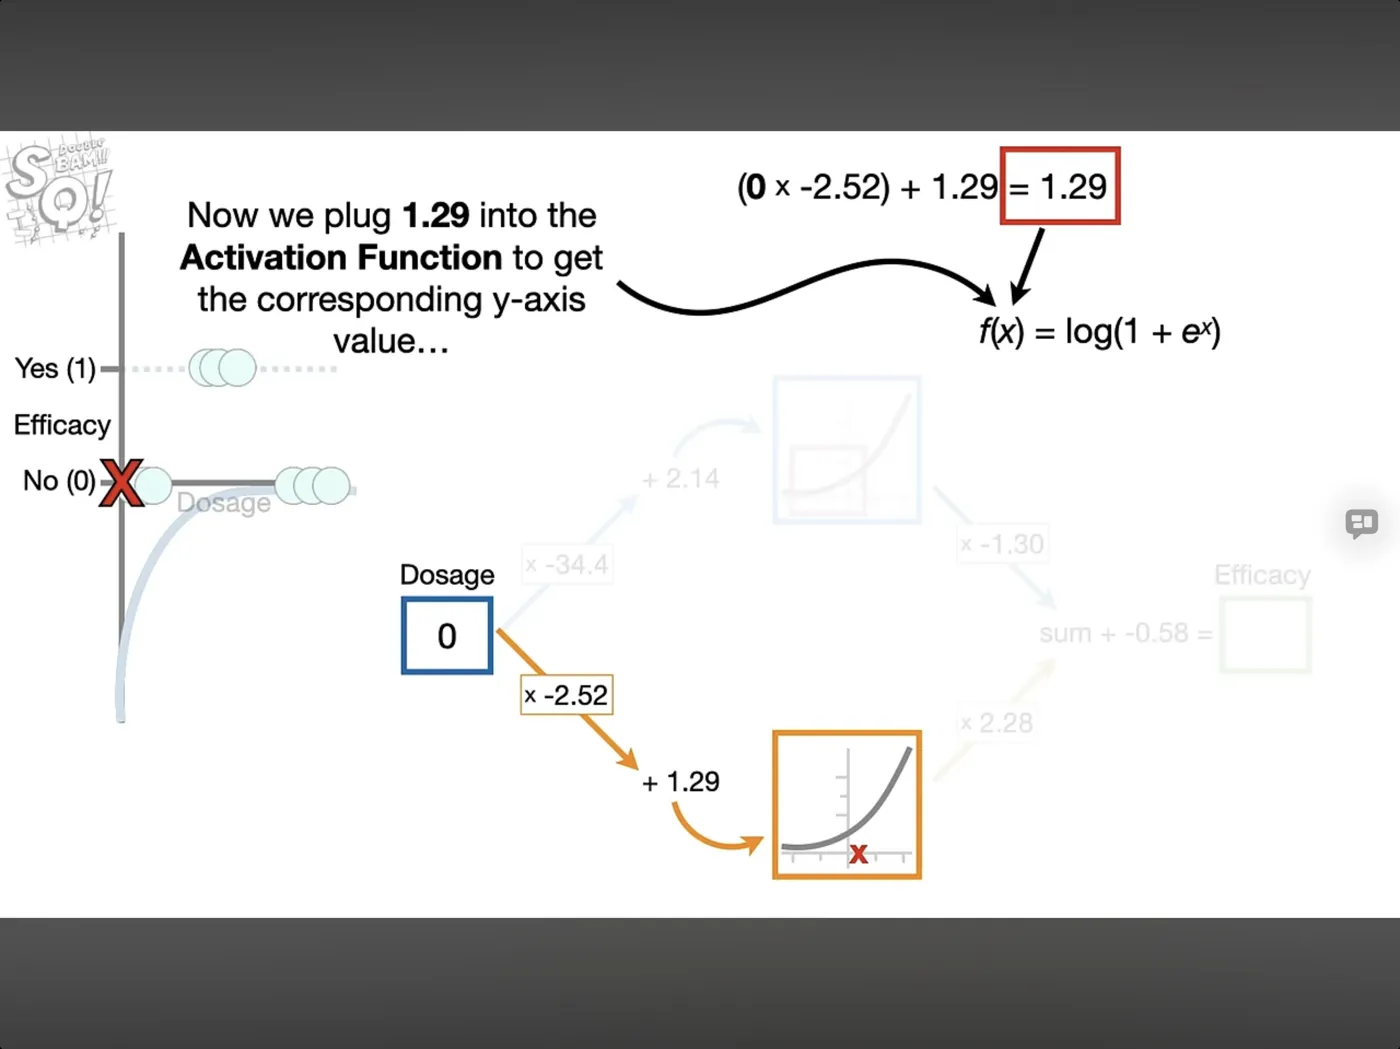
感覺后面越與複雜。
确实,你现在已经从机器学习的基础概念(Cross-Validation、Bias、Variance)进入了 Neural Networks(神经网络)的内部计算机制,难度明显提高了。
但我觉得你不必跟着视频把每一个数字和公式都算明白。尤其是你目前的目标是理解 AI 的工作原理,并逐步具备设计和构建 AI 产品的能力,而不是训练成为机器学习算法工程师。
我们先把这张截图简化。
1. 这张图其实只做了两件事
第一步:普通数学运算
视频中的公式:
0:输入的药物剂量-2.52:Weight(权重)1.29:Bias(偏置)
你可以暂时把 Weight 理解成输入的影响程度,把 Bias 理解成一个可学习的基础调整值。
第二步:经过激活函数
它只是把刚才得到的 1.29 输入 Softplus 函数,得到一个新的数字。
然后这个数字会传给下一层。
所以神经网络中的一个神经元,可以简单理解为:
接收数字 → 加权求和 → 加上偏置 → 激活函数 → 输出数字。
2. 为什么后面会越来越复杂?
因为视频正在把原本隐藏在神经网络内部的计算过程全部展开。
你会看到大量的:
- Weights(权重)
- Biases(偏置)
- Activation Functions(激活函数)
- 后续还可能出现 Backpropagation(反向传播)和 Gradient Descent(梯度下降)
这些概念不是彼此独立的,而是组成了神经网络训练和预测的整个过程。
3. 我建议你调整学习深度
| 概念 | 目前建议掌握程度 |
|---|---|
| Neural Network | 理解整体结构和数据流 |
| Weight / Bias | 知道它们是训练中调整的参数 |
| Activation Function | 理解为什么需要非线性 |
| Forward Propagation | 理解输入如何一步步变成输出 |
| Loss Function | 理解如何衡量预测误差 |
| Gradient Descent | 理解模型如何逐渐改善 |
| Backpropagation | 先理解用途,不必手算 |
| 复杂数学推导 | 目前可以跳过 |
还有一点值得注意:你之前接触的 Transformer 和大语言模型,也是建立在神经网络基础之上的。不过它们使用的结构和具体机制比视频中的简单网络复杂得多。
我的建议是:这套 StatQuest 视频可以继续看,但不需要以完全掌握每一个公式为目标。
你当前真正需要建立的认知是:
神经网络如何从输入产生预测?预测错了以后,模型又是如何通过训练调整参数的?
只要这两个问题能够用自己的语言解释清楚,你就已经建立了理解现代 AI 模型的重要基础。
蓝色和黄色神经元
之前的图里面为什么同样三类曲线却都有蓝色和黄色框起来,不懂
你观察到的这个细节很重要。之前的截图里,蓝色框和黄色(橙色)框并不是代表两种不同的激活函数,而是代表神经网络中的两个不同神经元(Neurons)。
1. 为什么同一种曲线出现两次?
回到之前视频中的结构:
这个神经网络有:
- 一个输入:Dosage(药物剂量)。
- 两个隐藏层神经元:蓝框 A、橙框 B。
- 一个输出:Efficacy(药物效果)。
视频演示 Sigmoid 时,两个神经元都使用 Sigmoid。
演示 ReLU 时,两个神经元都换成 ReLU。
最后选择 Softplus 时,两个神经元都使用 Softplus。
所以每张截图会出现两条形状相同的曲线。
2. 两个神经元都用 Softplus,为什么还需要两个?
因为它们虽然使用相同的激活函数,但拥有不同的 Weight(权重)和 Bias(偏置)。
根据你的视频截图:
| 蓝色神经元 | 橙色神经元 | |
|---|---|---|
| Weight | -34.4 | -2.52 |
| Bias | +2.14 | +1.29 |
| 激活函数 | Softplus | Softplus |
因此,虽然激活函数相同,但输入到激活函数里的数值不同,得到的结果也可能不同。
例如药物剂量为 0:
蓝色神经元计算:
橙色神经元计算:
这两个结果随后通过不同的连接权重参与最终预测。
3. 最关键的区别
激活函数不是神经元本身。
你可以把它理解为:
- Neuron(神经元):一个完整的小计算单元。
- Activation Function(激活函数):神经元内部使用的一种数学运算规则。
- Weight / Bias(权重与偏置):决定每个神经元具体如何处理输入的可学习参数。
就像两个设计师使用同一种计算公式,但各自输入不同的数字,最后得到不同的结果。
视频里蓝色和橙色框只是用来区分这两个神经元,并不是说蓝色框代表 Sigmoid、橙色框代表 ReLU。
一句话总结:同一个神经网络可以有多个神经元,它们可以使用相同的激活函数,但由于权重和偏置不同,会学习到不同的特征或响应模式。
Sigmoid 词义
sigmoid 什么意思,我知道humanoid
Sigmoid /ˈsɪɡ.mɔɪd/,读作 SIG-moyd,意思是 S 形的、乙状的。
你知道的 Humanoid 和它确实有一个共同的词尾:-oid。
| 单词 | 词源构成 | 含义 |
|---|---|---|
| Humanoid | human + -oid | 类人的、人形的 |
| Sigmoid | sigma + -oid | 形状像希腊字母 Sigma 的 |
| Android | andro- + -oid | 原意为男性形态的;现代常指仿人机器人 |
这里的 -oid 来自希腊语,表示 resembling / having the form of(类似……的形状)。
而 Sigma(Σ / σ) 是希腊字母。历史上 sigmoid 指类似希腊字母 sigma 某些书写形式的弯曲形状。
为什么机器学习里叫 Sigmoid?
因为它的图像呈 S 形,而且能够把任意实数转换成 0 到 1 之间的数值。
例如输入 -10,输出接近 0;输入 0,输出 0.5;输入 10,输出接近 1。
所以在神经网络中,它可以用作 Activation Function(激活函数)。
记忆方法:
- Humanoid → Human-like(像人的)
- Sigmoid → S-shaped(像 S 的)
顺便一提,医学里也有 Sigmoid colon(乙状结肠),因为那段肠道呈弯曲形状。
所以 Sigmoid 本来是描述形状的词,并不是 AI 领域专门创造的术语。
两条路径的输出
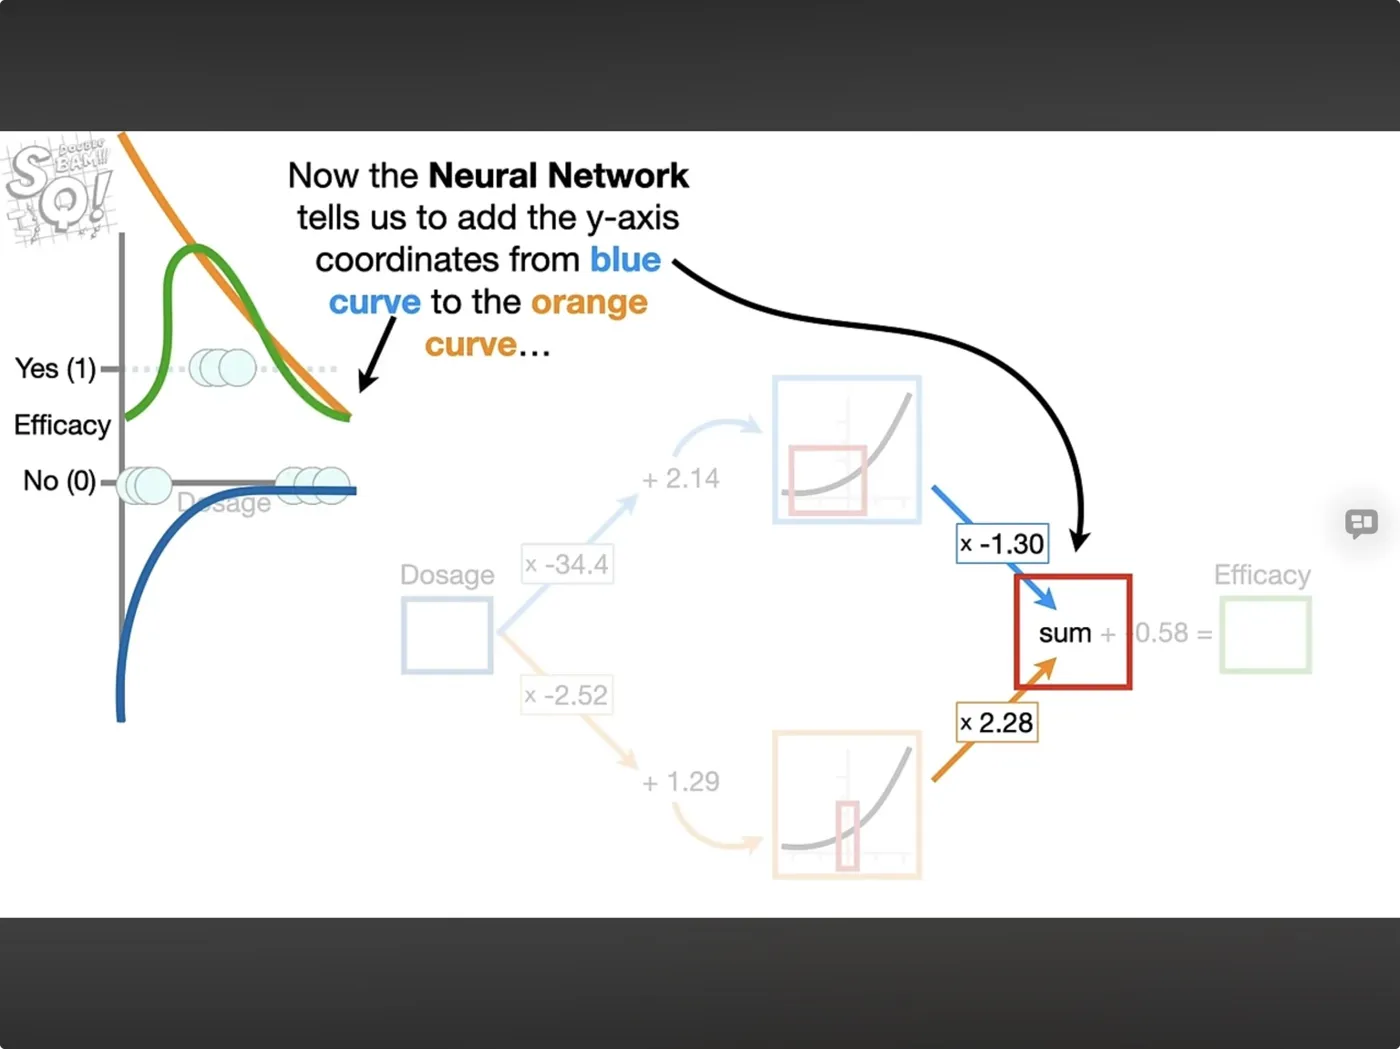
原回答中的输出偏置写作 +0.58;第 27 条原图显示为 −0.58。此处保留原文,核对说明见学习页。
这张图其实是你刚才学的两个神经元(蓝色和橙色)如何合作,产生最终预测结果。
而且你已经来到这个简单神经网络的最后一步了:把两个神经元的输出组合起来。
1. 先理解左边的三条曲线
截图中有三条不同颜色的曲线:
- 蓝色曲线:第一个神经元经过 Softplus 激活函数,再乘以输出权重 -1.30 的结果。
- 橙色曲线:第二个神经元经过 Softplus 激活函数,再乘以输出权重 2.28 的结果。
- 绿色曲线:把蓝色和橙色曲线在每个输入位置的纵坐标相加,形成的组合曲线。
注意,蓝色曲线和橙色曲线不是原始的 Softplus 曲线,而是经过权重调整后的曲线。
2. 为什么要把两条曲线相加?
因为单个神经元能够表达的关系有限。
但如果我们把多个神经元的结果组合起来,就能形成更加复杂的曲线。
例如,在某一个药物剂量下:
- 蓝色神经元贡献 -0.8
- 橙色神经元贡献 +1.5
那么相加就是:
换一个药物剂量,两个神经元的输出也会变化,因此相加后的结果会形成一条新的曲线。
3. 截图里的 -1.30、2.28 和 0.58 是什么?
这三个数字都属于网络中的可学习参数:
| 数字 | 含义 |
|---|---|
| -1.30 | 蓝色神经元连接到输出层的权重 |
| +2.28 | 橙色神经元连接到输出层的权重 |
| +0.58 | 输出层的 Bias(偏置) |
因此完整的输出计算是:
这里 和 分别是蓝色、橙色神经元经过 Softplus 后的输出。
截图这一帧正在演示两条加权曲线相加;后续还需要加上 0.58 才得到完整的网络输出。
4. 你真正需要理解的是什么?
整个神经网络可以概括成:
还有一个容易混淆的地方:左边的绿色曲线是模型计算出来的预测关系,并不意味着它已经准确拟合了真实数据。模型好不好,还要通过预测误差来判断。
你可以把目前学到的内容浓缩成一句话:
神经网络通过多个神经元分别学习不同的响应,再把它们组合起来,表达更复杂的输入与输出关系。
这就是视频想让你理解的核心。后面即使神经网络增加到几十层、上百万个参数,基本计算思路仍然与这个例子有联系。
两个神经元的曲线
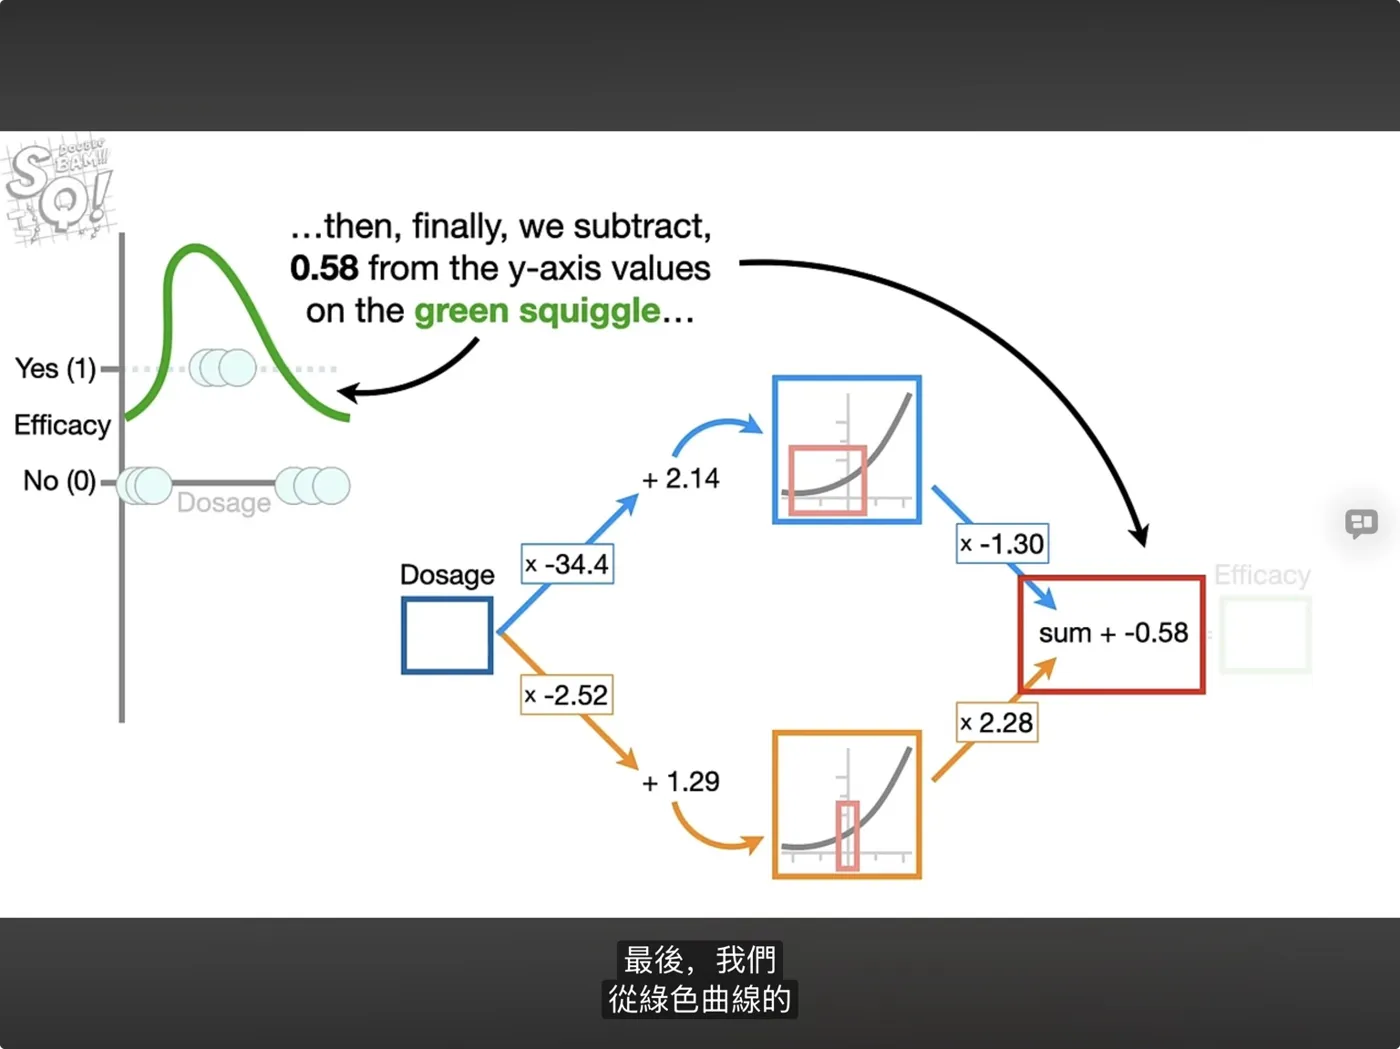
蓝色框和黄色框没懂,里面各自红色框范围不一样,曲线长得差不多
你观察得很仔细。这里其实有三个不同的东西,很容易混在一起:
- 蓝色框和橙色框:两个不同的神经元。
- 里面的灰色曲线:两个神经元使用的同一种 Softplus 激活函数。
- 里面的红色小框:用来突出显示曲线上某一段输入范围,帮助理解当前神经元主要使用曲线的哪个区域。
1. 为什么两条灰色曲线长得一样?
因为两个神经元都使用同一个数学函数:
但是它们在进入 Softplus 之前,计算方式不同。
| 蓝色神经元 | 橙色神经元 | |
|---|---|---|
| 输入权重 | -34.4 | -2.52 |
| 偏置 | +2.14 | +1.29 |
| 激活函数 | Softplus | Softplus |
| 输入变化速度 | 很快 | 相对缓慢 |
假设药物剂量为 ,那么:
蓝色神经元:
橙色神经元:
所以相同的药物剂量,进入两个 Softplus 函数时,实际数值可能完全不同。
2. 为什么红色框的范围不一样?
这是你真正困惑的地方。
原因是两个神经元的输入权重不同。
蓝色神经元的权重是 -34.4,橙色神经元是 -2.52。
当药物剂量变化相同的幅度时:
- 蓝色神经元进入 Softplus 的数值变化更大。
- 橙色神经元进入 Softplus 的数值变化较小。
所以视频用不同大小的红框,突出它们在同一条 Softplus 曲线上涉及的不同范围。
不过,仅凭这一帧,不能确定红框的精确坐标边界;它们是教学中的视觉标注,不是神经网络实际计算时存在的框。
3. 为什么最后能够形成绿色的山峰?
这里是最有趣的地方。
虽然两个神经元都使用向上弯曲的 Softplus 函数,但它们经过不同的输入权重、偏置和输出权重后,会产生不同的响应。
截图中的输出层:
两个神经元的贡献相加,再减去 0.58,就能形成左边那条绿色曲线。
这也是神经网络的核心能力之一:用多个简单函数的组合,表达更加复杂的关系。
你可以把它想象成:两个人都使用同一种绘图工具,但调整了不同的参数,最终把各自画出的形状组合起来,就能形成一个新的形状。
最需要记住的是:
灰色曲线相同,是因为使用同一个 Softplus 函数;红色框不同,是因为两个神经元的输入变换不同;最终绿色曲线,则来自两个神经元经过加权后的组合。
一句话解释神经网络
如果有人让我用一句话通俗说下什么是神经网络
神经网络是一种模仿大脑神经元连接方式的数学模型,它通过大量简单的计算单元相互配合,从数据中学习规律,并用这些规律做出预测或判断。
如果想更口语化,可以说:
神经网络就像一个由很多小计算器连接起来的系统,通过不断调整它们之间的连接参数,从大量数据中学会识别复杂的规律。
我更推荐第二种,容易理解,也比较准确。
英文表达:
"A neural network is a system of interconnected computational units that learns patterns from data to make predictions."
还有一个值得区分的地方:神经网络是受生物神经系统启发的,但并不意味着它真的像人脑一样思考。
反向传播
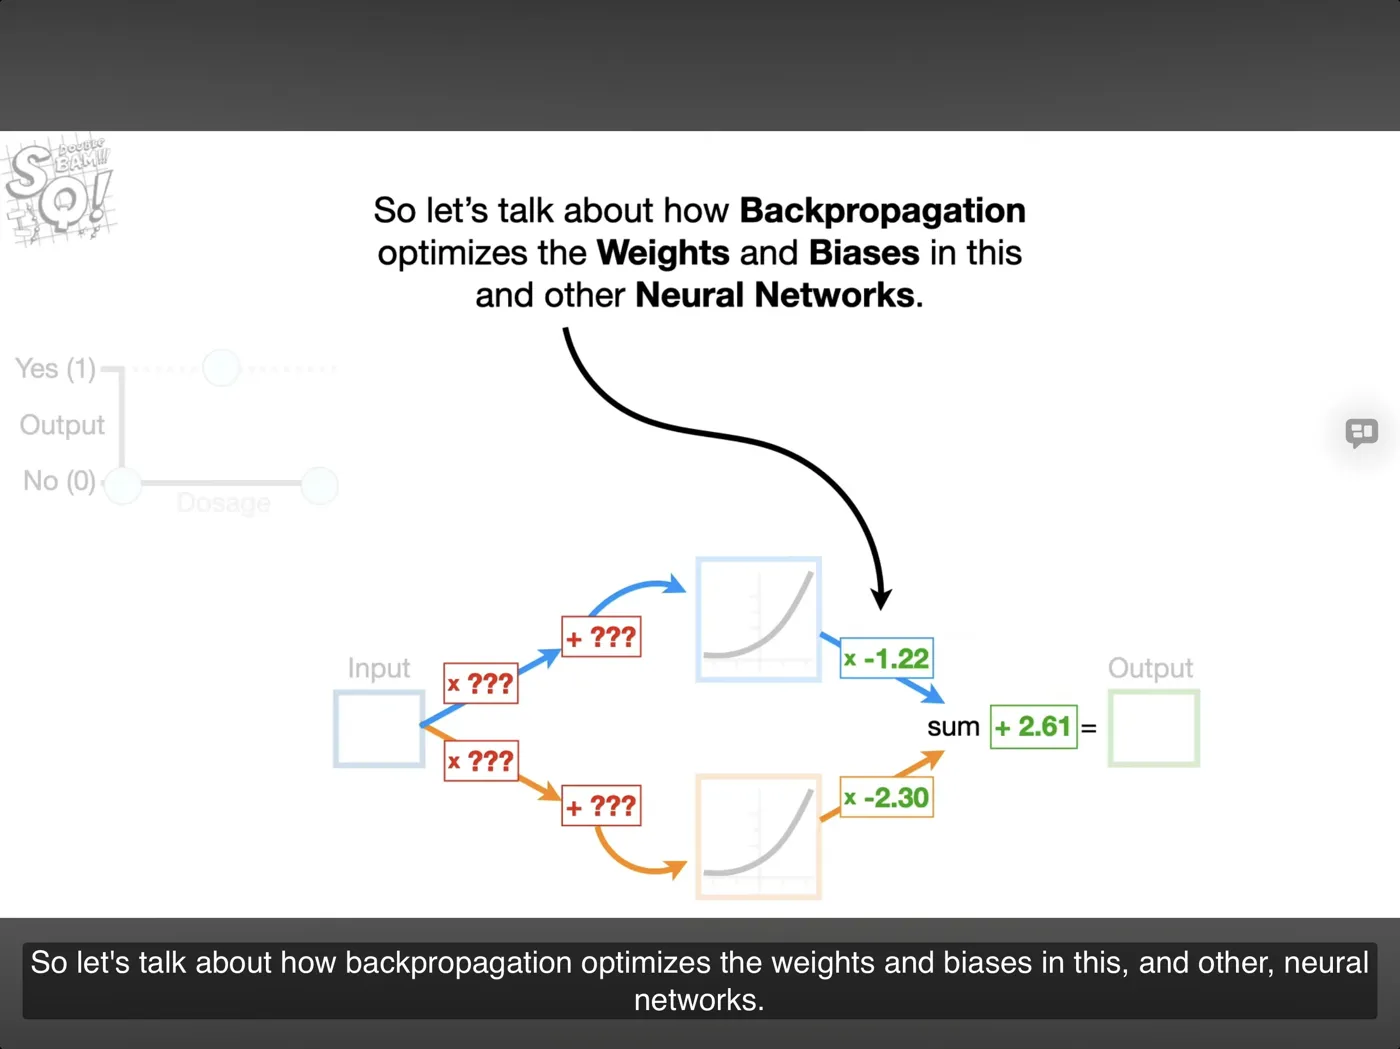
尤其是backpropagation解释
这张图开始讲神经网络最重要的机制之一:Backpropagation(反向传播)。
你之前已经看过 Activation Function(激活函数)、Weights(权重)和 Biases(偏置)。现在视频开始回答一个新问题:
神经网络最初并不知道正确的权重和偏置,那它是怎么把这些数字调整到合适的值的?
答案就是通过反向传播计算如何调整参数,再由优化算法更新它们。
1. 一句话理解 Backpropagation
反向传播就是:神经网络先做出预测,再根据预测的错误,从输出端往回计算每个参数应该如何调整。
你可以把它想象成一个不断纠错的过程。
2. 结合你的截图理解
你的截图中,神经网络有两条计算路径。
两条路径的结果经过各自的输出权重,再相加并加上最终偏置,得到预测值。
你截图里出现了:
× ???:需要学习的权重(Weights)。+ ???:需要学习的偏置(Biases)。× -1.22、× -2.30:另外两个权重。+ 2.61:输出端的偏置。
这些数值都属于神经网络可以通过训练调整的参数。红色问号代表视频准备重新寻找更合适的参数。
3. 为什么需要反向传播?
假设神经网络正在预测一种药物是否有效。
真实答案是:
但神经网络预测:
那么它就需要学习。
可是问题来了:这个预测值是经过许多权重、偏置和激活函数计算出来的。
究竟应该修改哪个数字?修改多少?
这就是反向传播的作用。
它通过数学中的 Chain Rule(链式法则),计算损失函数对各个参数的梯度,告诉优化算法:
- 哪些参数对当前误差有影响?
- 朝哪个方向调整,可能降低误差?
- 调整的幅度应该如何确定?
随后,Gradient Descent(梯度下降)等优化算法根据这些梯度更新参数。
4. 你可以自己体验一次神经网络如何学习
下面用一个极简模型展示。假设输入固定为 1,真实目标是 1,模型的预测就是权重 。我们暂时不使用激活函数和偏置,只观察训练过程。
严格来说,这个例子只有一个参数,所以不需要复杂的反向传播过程。但它展示了反向传播最终要帮助完成的事情:让参数朝着降低误差的方向更新。
5. 你目前需要理解到什么程度?
从 AI 产品设计和 Vibe Coding 的学习目标来看,我建议你先掌握三个层次:
| 概念 | 需要理解的核心 |
|---|---|
| Forward Propagation 前向传播 | 输入数据,经过计算得到预测 |
| Loss Function 损失函数 | 衡量预测与目标之间的差距 |
| Backpropagation 反向传播 | 反向计算各参数的梯度,帮助模型改进 |
暂时不需要手动推导链式法则或偏导数。
最后,记住一句英文:
"Backpropagation calculates how each parameter contributes to the loss, so the model can update its weights and biases."
意思是:反向传播计算各个参数对损失的影响,从而帮助模型更新权重和偏置。
这也是你正在看的视频从“神经网络如何做预测”进入“神经网络如何学习”的关键转折。
导数与链式法则
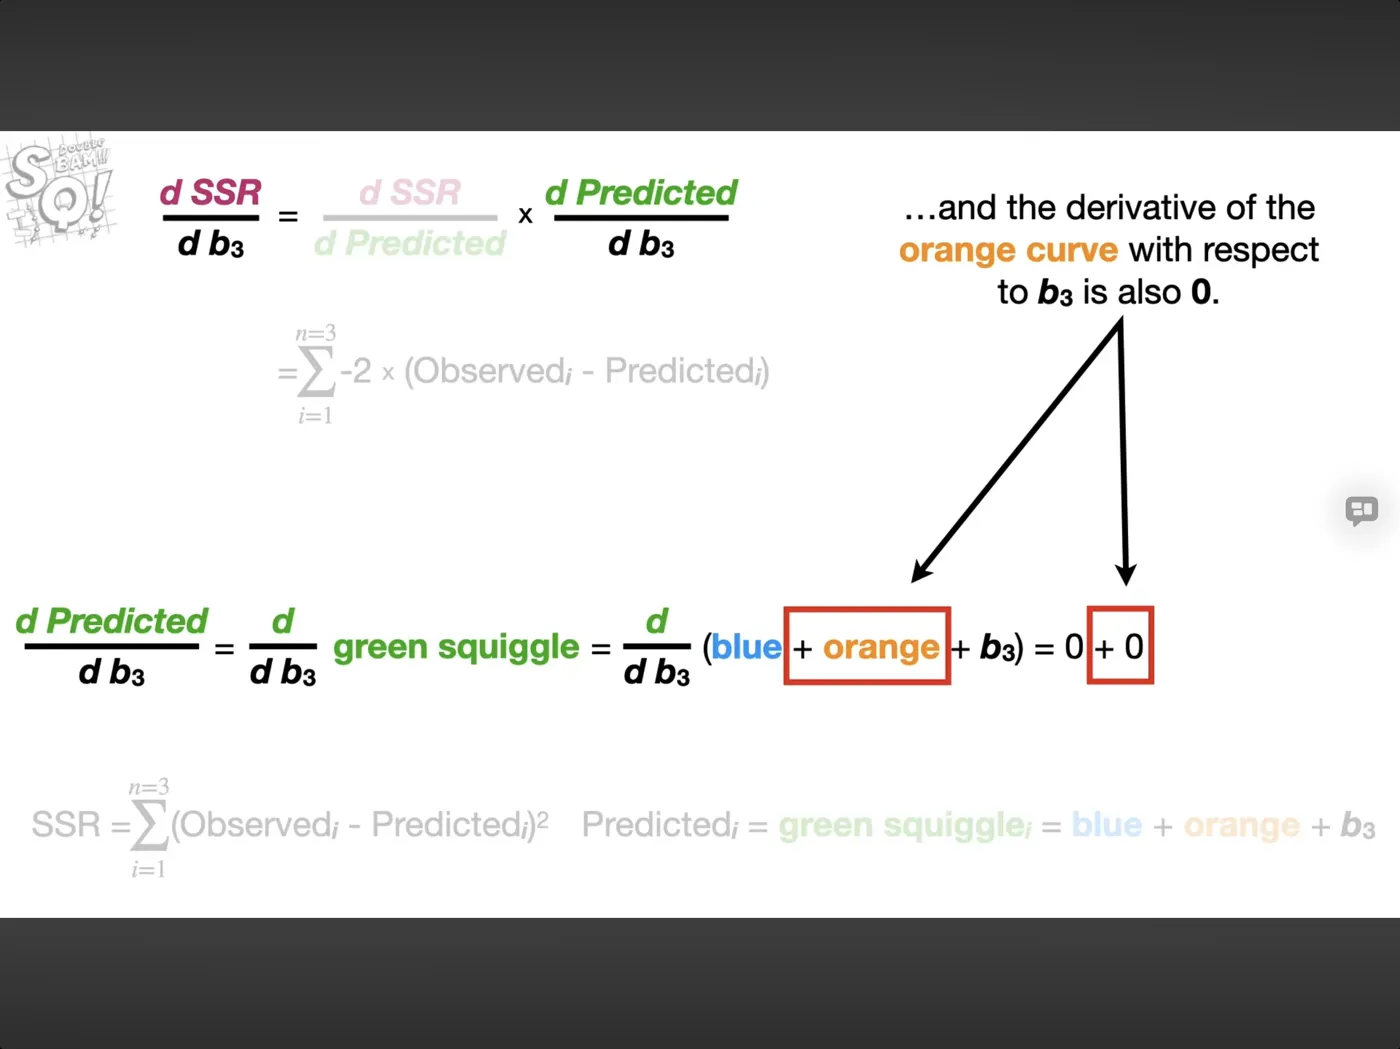
不懂
这张图确实比前面复杂,因为视频已经进入 Backpropagation(反向传播)背后的数学原理:Derivative(导数)和 Chain Rule(链式法则)。
但这里有一个特别重要的地方:你不需要先理解整条公式,只需要理解它想回答什么问题。
1. 这张图究竟想解决什么?
回忆之前的神经网络:
模型的预测公式是:
这里的 是最终的 Bias(偏置)。
现在视频想知道:
如果我们稍微改变 ,最终的预测误差 SSR 会改变多少?
这正是截图最上方公式的意思:
读作:The derivative of SSR with respect to b three.
意思是:SSR 对 的导数。
2. 为什么截图里 Blue 和 Orange 的导数都是 0?
这是你这张截图最值得理解的部分。
视频写的是:
为什么?
因为这里计算的是 只改变 ,其他参数保持不变 的情况。
| 部分 | 改变 时会怎样? | 导数 |
|---|---|---|
| Blue | 不变 | 0 |
| Orange | 不变 | 0 |
| 增加 1 就增加 1 | 1 |
所以:
注意:Blue 和 Orange 的导数为 0,不代表它们的输出是 0,也不代表它们对预测没有贡献。
只是说,当我们单独调整 时,这两部分不会跟着变化。
3. 那为什么上面还有一个乘法公式?
截图上方是:
这就是 Chain Rule(链式法则)。
可以把它拆成两个问题:
- 预测值变化,会让误差 SSR 变化多少?
- 变化,会让预测值变化多少?
把这两个变化率相乘,就能得到:
改变 ,会让 SSR 变化多少。
这就是神经网络训练时需要的信息。
4. 用一个数字例子试试
你会发现,Blue 和 Orange 一直不变,但改变 就能改变最终预测,也会影响误差。
这就是视频正在用导数分析的关系。
5. 你现在需要记住什么?
你之前已经理解了神经网络的前向计算,现在可以把这节内容连接起来:
- Forward Propagation: 通过权重、偏置和激活函数计算预测值。
- Loss(SSR): 衡量预测值与真实值的差距。
- Derivative: 衡量一个参数发生微小变化时,误差如何变化。
- Backpropagation: 使用链式法则计算各参数的梯度,帮助优化算法调整权重和偏置。
还有一点:截图里出现的 只是中间计算,完整结果应该是 ,因为 对自身的导数是 1。
我建议你暂时不用背这些数学公式。 对你目前建立 AI Literacy 的目标,更重要的是理解:神经网络不是随机地修改参数,而是利用梯度,有方向地降低预测误差。
你可以继续看视频,遇到下一步计算权重(Weights)的导数时,我们再把它和这里的偏置(Bias)比较,你会发现其实是同一套逻辑。
山谷与梯度下降
你说的这个让我想起了吴恩达在deep learning平台讲的课,用那种xyz轴山峰和谷底演示计算一步步优化接近准确值
对!你想起来的正是吴恩达课程里经典的 Gradient Descent(梯度下降) 演示。
而且它和你现在学习的 Backpropagation(反向传播) 是直接关联的。你其实已经接触过同一套训练机制,只是两门课从不同角度解释。
两个概念是怎样连接的?
可以把神经网络训练想象成:在一座山上寻找最低的谷底。
- 山的高度:Loss(损失),代表模型预测有多不准确。
- 山上的位置:Weights 和 Biases(权重与偏置)的当前取值。
- 山的坡度:Gradient(梯度),告诉我们往哪个方向调整参数,损失下降得最快。
- 谷底:损失较小的位置,是优化希望到达的地方。
但这里有两个不同的工作:
| 概念 | 负责什么 | 山谷比喻 |
|---|---|---|
| Backpropagation 反向传播 | 计算每个参数对应的梯度 | 测量当前位置的坡度 |
| Gradient Descent 梯度下降 | 根据梯度更新参数 | 沿着下坡方向走一步 |
试着走向谷底
下面用一个简化的一维损失函数演示。你可以调整学习率(Learning Rate),观察每次更新的步长。
再联系你刚刚看到的公式
截图中:
就是在计算:如果改变偏置 ,山的高度(SSR)会怎样变化?
反向传播算出这个梯度之后,梯度下降就可以利用它更新 。
所以你可以把整个过程记成:
这四步反复执行,就是神经网络训练的基本循环。
还有一个你可能会感兴趣的联系:你之前学习的 Cross-validation(交叉验证) 不负责让模型下山,而是帮助评估模型在未见数据上的表现,以及选择合适的超参数。
这样,你最近学到的神经网络、Bias、Derivative、Backpropagation、Gradient Descent 和 Cross-validation,其实已经开始形成一个完整的机器学习知识框架了。
权重的偏导数
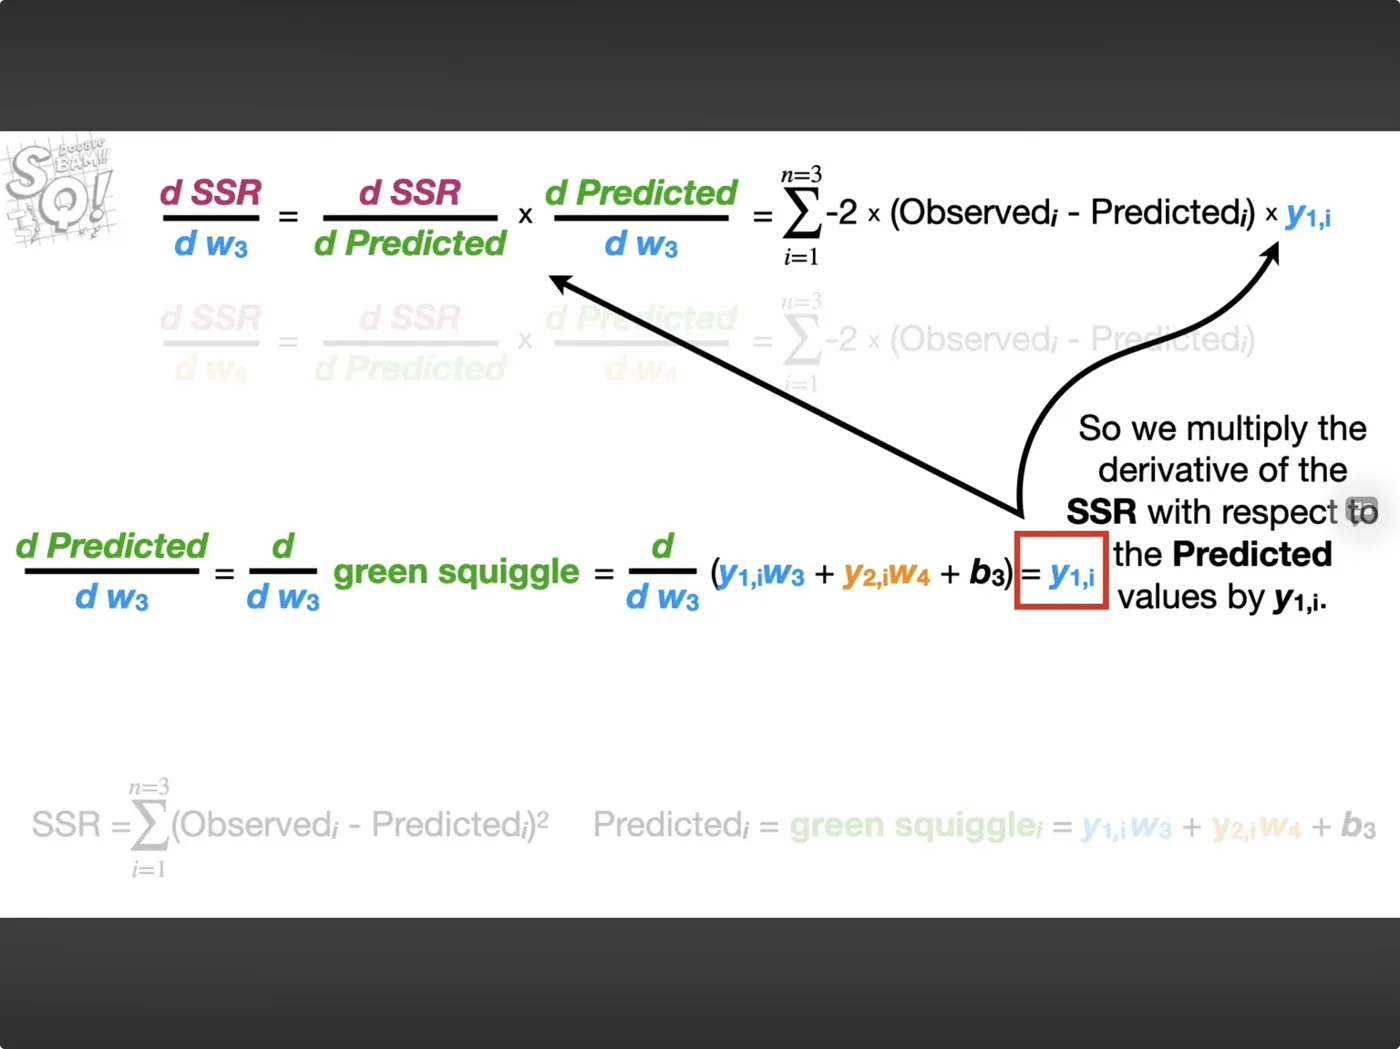
一点都看不懂
这张图确实突然变得很数学化了。但你先不用试图读懂所有符号。
整张图其实只在回答一个问题:神经网络应该怎样调整一个叫 的权重,才能让预测更准确?
这就是你刚刚提到的吴恩达课程里“沿着山坡寻找谷底”的一部分。
1. 先不看公式,理解它在干什么
假设我们有一个预测药物疗效的神经网络。
- 实际结果(Observed):1,代表药物有效。
- 模型预测(Predicted):0.6。
- 预测误差:0.4。
现在我们想让预测从 0.6 更接近 1。
但神经网络里有很多可以调整的参数,例如 、、。
问题是:调整 会让预测变好还是变坏?影响有多大?
这张图就是在计算这个。
2. 把截图中的公式拆成三部分
然后,把第二部分和第三部分相乘,就得到第一部分。
这叫 Chain Rule(链式法则)。
3. 为什么要相乘?
用一个更简单的例子:
假设:
- 增加 1 个单位,会让预测值增加 0.5。
- 预测值增加 1 个单位,在当前位置会让误差减少 0.8。
那么:
结果为负,表示在当前位置,稍微增加 ,误差会下降。
这就是导数告诉我们的信息。
注意,这些数字只是为了帮助理解,不是截图中的实际计算结果。
4. 为什么截图最后出现了一个求和符号?
你看到的:
意思就是:把三个训练样本分别算出来的结果加在一起。
因为视频里使用三个样本训练,所以需要考虑 对全部三个样本总误差的影响,而不只是一个样本。
因此截图最终得到:
你目前不需要记住这个公式,只要知道它计算的是一个权重对总误差的影响。
5. 和你之前看到的山谷有什么关系?
我对你当前学习阶段的建议
你现在看的 StatQuest 视频已经进入神经网络的数学推导部分,涉及偏导数、链式法则和求和符号。
如果你的目标是建立 AI Literacy,理解神经网络怎样学习、怎样训练,以及这些技术如何影响 AI 产品设计,目前不必掌握手工计算这些导数的能力。
但我想确认一个关键理解:
假设我们发现,增加 会让预测误差变大。
那么,为了降低误差,梯度下降通常应该怎么调整 ?
如果你能理解这道题,其实你就已经掌握了这段视频最重要的概念,而不需要先把所有数学符号都弄懂。
开始 3Blue1Brown
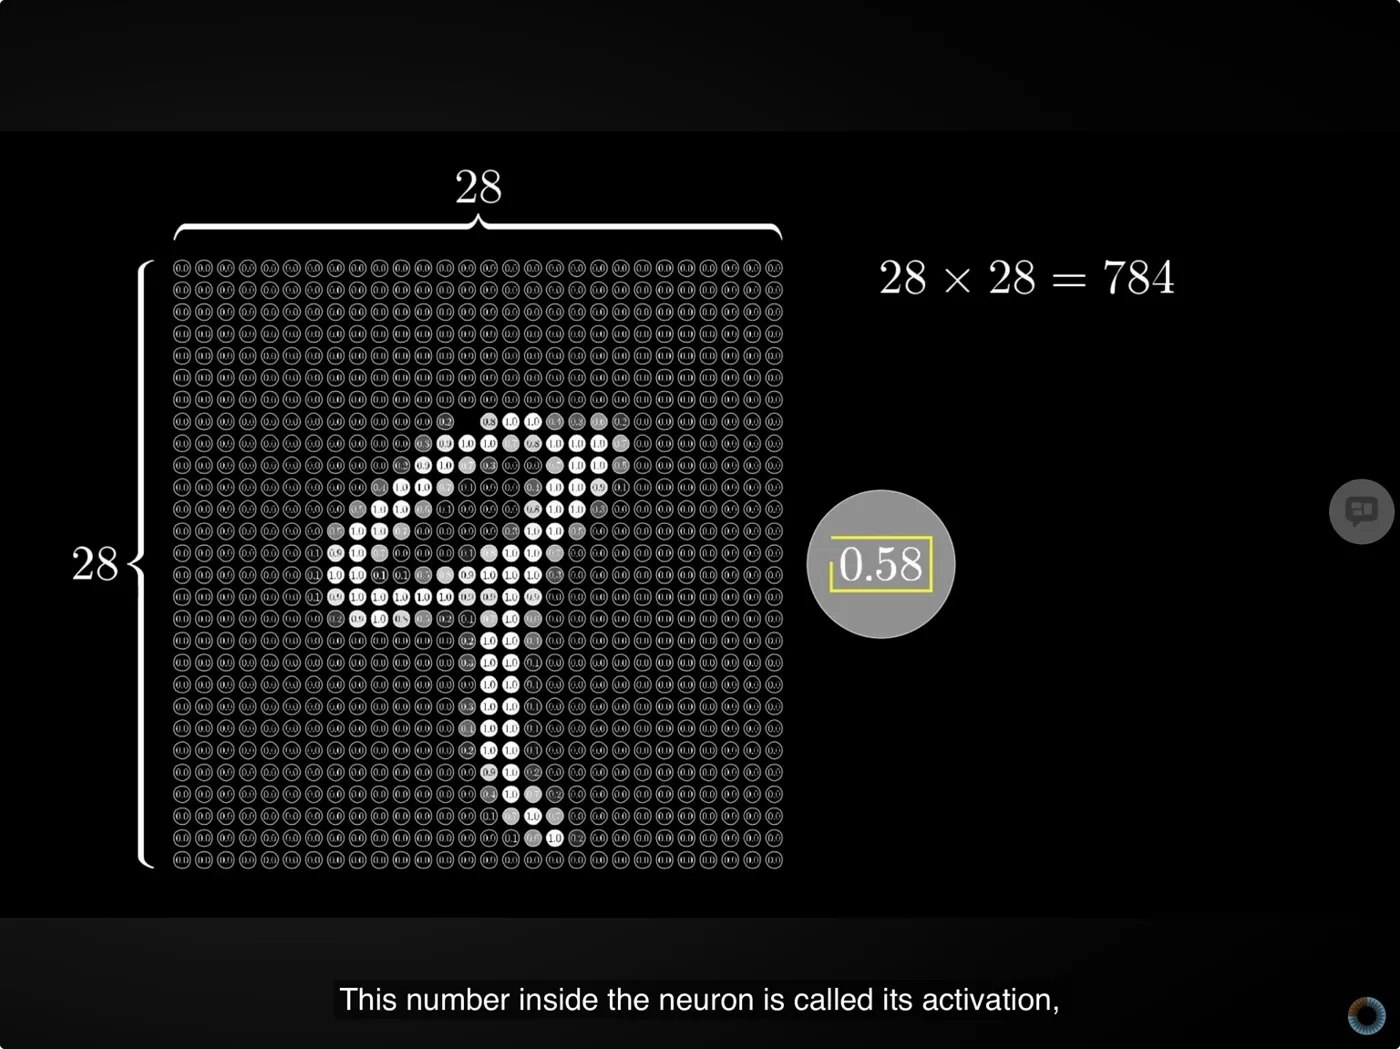
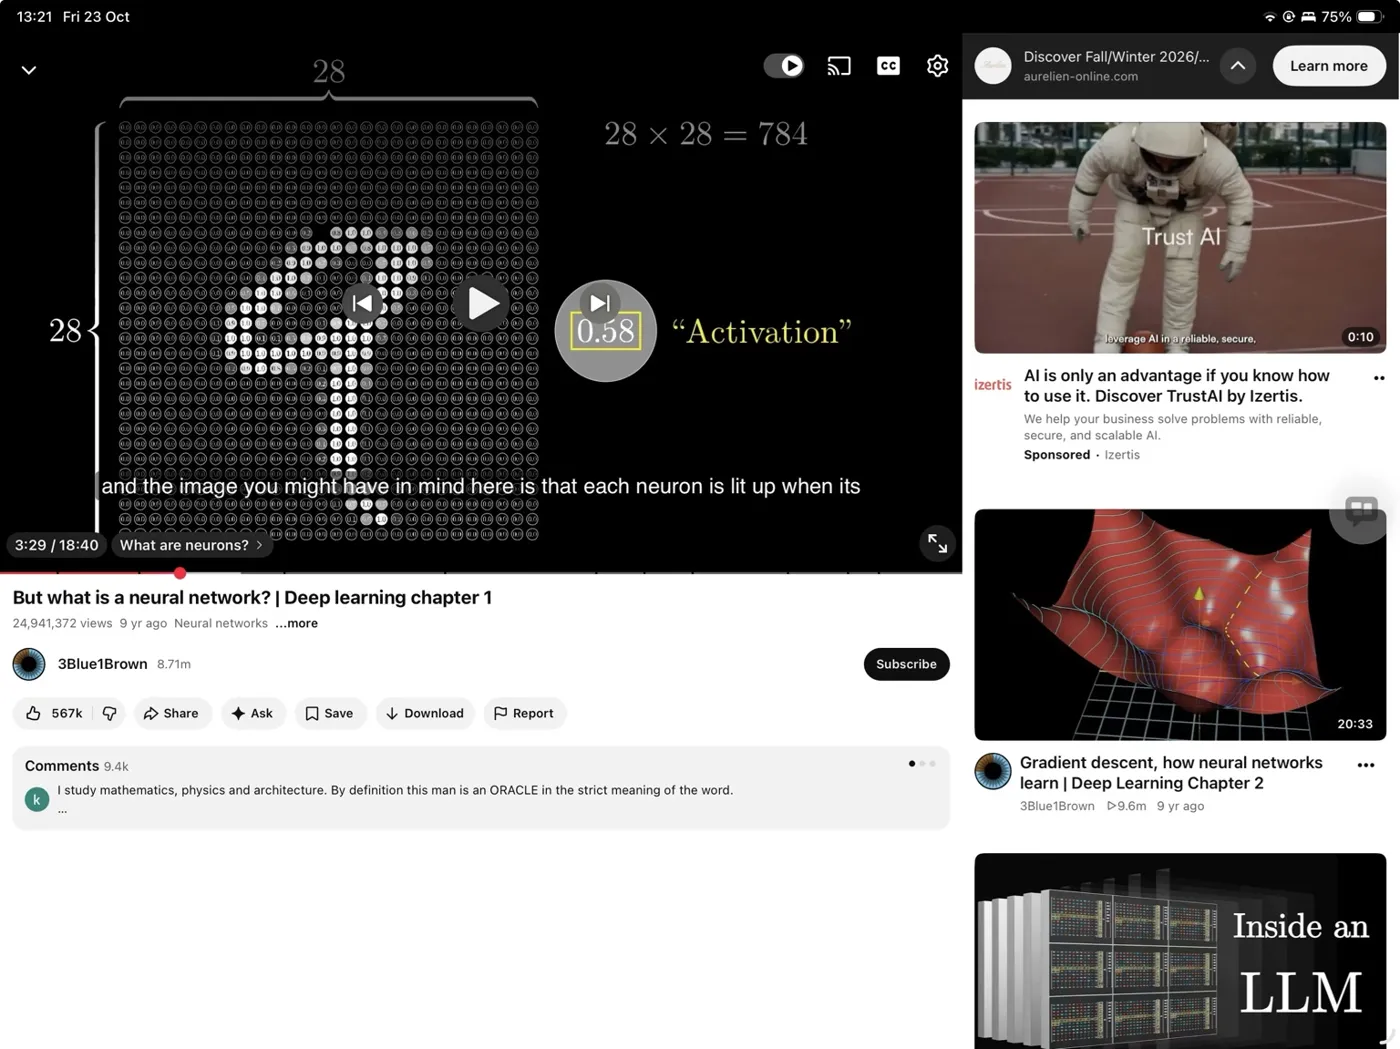
我开始看另一个系列
你现在开始看的是 But what is a neural network? | Deep learning chapter 1,来自 3Blue1Brown。
我觉得这个切换很合适,尤其是结合你前面学习 StatQuest 时遇到的困难。
两个系列的侧重点不同:
| StatQuest | 3Blue1Brown | |
|---|---|---|
| 核心问题 | 神经网络具体怎么算? | 神经网络为什么这样运作? |
| 教学方式 | 逐步计算、公式推导 | 动画、几何与数学直觉 |
| 学习重点 | 算法细节 | 概念和整体结构 |
| 对你目前的价值 | 作为进阶补充 | 更适合先建立认知 |
你现在看到的 Activation 是什么?
截图展示的是一张 28 × 28 像素的手写数字图片。
这里需要区分两个概念:
- Neuron(神经元):神经网络中的一个计算单元。
- Activation(激活值):这个计算单元输出的数值。
在这个例子中,每个像素对应输入层的一个神经元,共有 784 个。视频用 0 到 1 的数值表示像素亮度。
因此,0.58 不是说神经网络有 58% 的把握识别出某个数字,而是当前这个神经元的激活值为 0.58。
这也能帮助你理解之前 StatQuest 的 Activation Function:它是用来计算激活值的函数,而 Activation 是计算得到的结果。
接下来建议你重点看什么?
这个系列的第一章,我建议先抓住四件事:
- 为什么一张图片可以变成 784 个数字?
- 输入层、隐藏层、输出层分别承担什么作用?
- Weight 和 Bias 怎样影响神经元的激活值?
- 为什么经过多层计算,神经网络可以识别手写数字?
暂时不要追求看懂每一个公式。 你前面已经接触过梯度下降、反向传播和激活函数,现在更重要的是把这些分散的知识连接成一套完整的神经网络工作原理。
你可以继续像之前一样,在不理解的地方截图给我。我会优先解释画面在表达什么、为什么这样设计计算过程,以及它和之前学过的概念有什么联系。
Activation 的 What / Why / How
所以activation是一个输出的数值,那它起了什么作用呢?它是,它最终运算结果又有什么关系?我需要了解How、Why、What。
你已经理解了 Activation(激活值)是一个数值。现在最关键的是理解:为什么神经网络需要这个数值?它怎样参与下一步计算?最终又怎样变成预测结果?
我们沿用你正在看的 3Blue1Brown 视频中的手写数字识别案例,从 What → Why → How 三个角度解释。
1. What — Activation 究竟是什么?
Activation(激活值)是神经元经过计算后产生的数值,用来表示该神经元对当前输入的响应程度。
例如,神经网络正在识别一张手写数字 3 的图片。
在视频的输入层中,Activation 直接对应像素亮度:
- 0:黑色像素
- 0.5:中等亮度
- 1:白色像素
但是到了隐藏层,Activation 不再直接代表某个像素,而是神经元对多个输入进行加权计算后的响应。
例如,一个神经元可能学会对某种弯曲笔画产生较高响应。
注意:这种含义是训练过程中形成的,并不是我们预先给每个神经元指定了“识别弯曲笔画”的任务。
2. Why — 为什么需要 Activation?
因为神经网络需要一种方式,把上一层处理得到的信息传递给下一层。
你可以把它理解为:
每个神经元不仅要接收信息,还要产生一个新的数值,供其他神经元继续计算。
如果没有这种数值传递机制,后面的神经元就无法利用前面计算的结果。
不过,Activation 的作用不只是传递数字。隐藏层的激活函数通常还会引入非线性,让神经网络能够学习复杂的关系。
这正是之前你学习 Sigmoid、ReLU 和 Softplus 的原因。
3. How — Activation 是怎么计算和传递的?
这里我们用一个交互例子。
假设某个神经元接收到两个输入,它会:
- 将每个输入乘以对应的 Weight(权重)。
- 把结果相加,再加上 Bias(偏置)。
- 通过 Activation Function(激活函数),得到 Activation。
- 将 Activation 传给下一层。
在这个演示里,Weight 和 Bias 是固定的;真正训练时,它们会不断被更新。
4. Activation 和最终预测结果有什么关系?
回到手写数字识别的例子。
在视频这种使用 10 个输出神经元的网络中,每个输出神经元对应一个数字(0–9)。
最终通常选择激活值最高的那个数字作为预测结果。
但要注意:输出激活值不一定是经过校准的概率。 例如 0.92 不必然意味着模型有 92% 的正确概率。
5. 你需要建立的完整认知
| 概念 | 它回答什么问题? |
|---|---|
| Weight | 哪些输入影响更大? |
| Bias | 神经元的响应如何整体偏移? |
| Activation Function | 如何把加权结果转换成输出? |
| Activation | 当前神经元产生了什么数值? |
| Loss Function | 最终预测错了多少? |
| Backpropagation | 每个参数对误差的影响有多大? |
| Gradient Descent | 怎样调整参数来降低误差? |
所以,Activation 本身不是神经网络学习的最终目标,而是神经网络逐层处理信息的中间结果,也是输出层产生预测的基础。
而你之前学习的反向传播和梯度下降,是在训练阶段帮助网络调整 Weight 和 Bias,让这些激活值最终形成更准确的预测。
最后,我想特别区分一句话:
Activation 是神经元当前输出什么;Backpropagation 是训练时计算怎样调整参数。
这两个概念一旦区分清楚,后面的神经网络结构就会容易理解很多。
ReLU
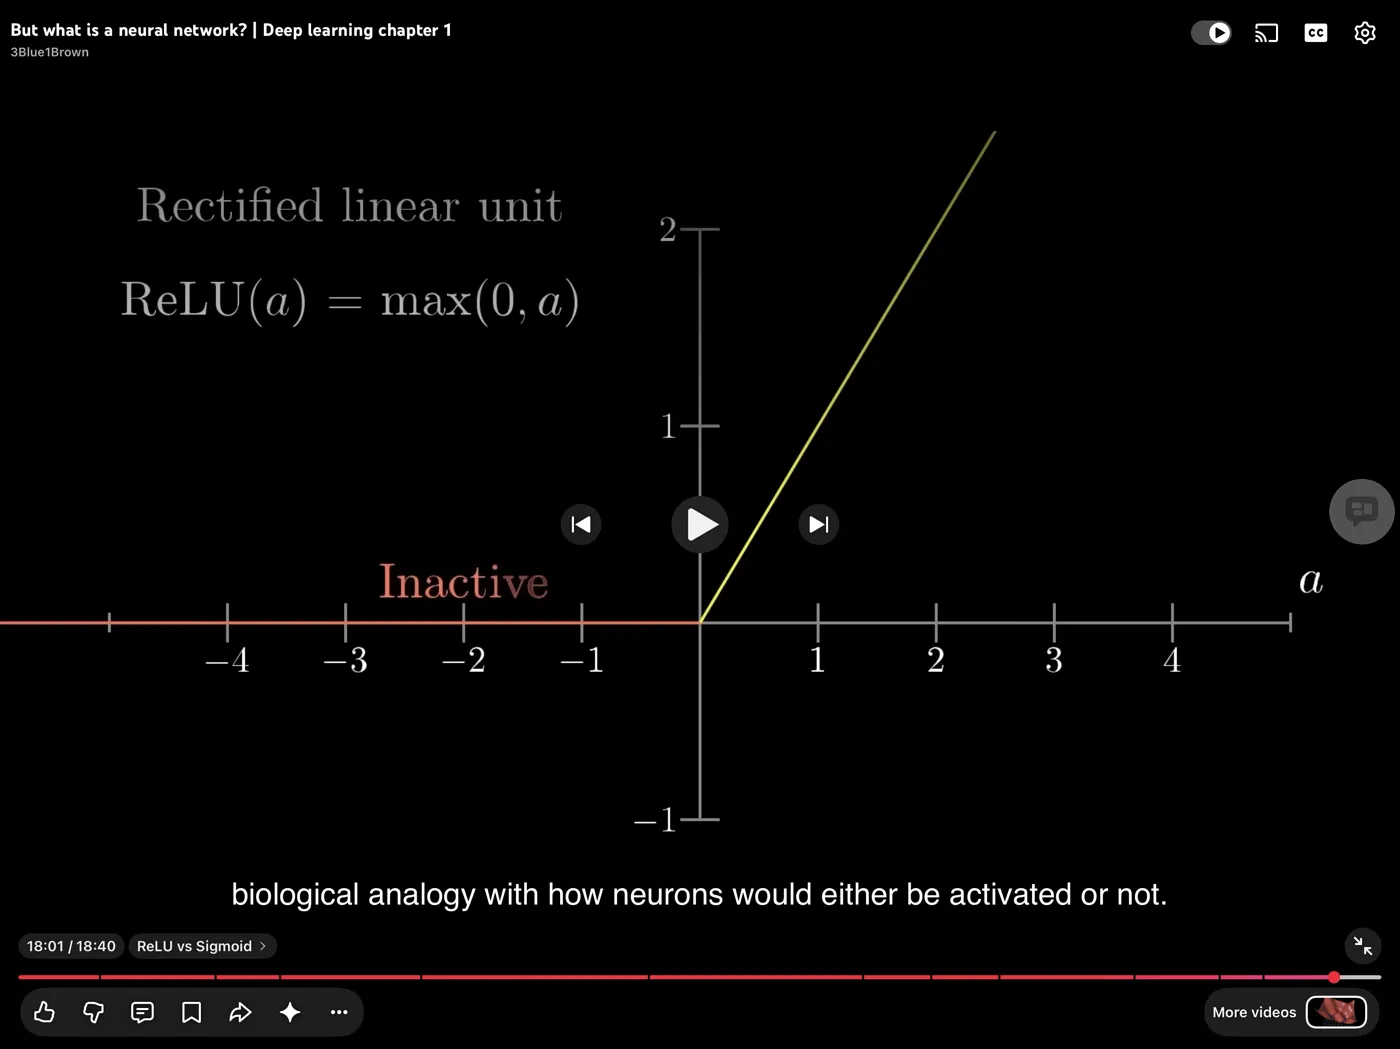
relu在statquest视频也有,但是我没懂whathowwhy
你现在看到的 ReLU,和之前 StatQuest 讲的 Sigmoid、Softplus,其实都是同一类东西:Activation Function(激活函数)。
你已经知道 Activation 是神经元输出的数值。那么 ReLU 就是在决定:神经元收到一个计算结果后,应该输出多少?
我们继续按照 What → How → Why 理解,不需要复杂数学。
1. What — ReLU 是什么?
ReLU 全称是 Rectified Linear Unit(修正线性单元)。
它的规则非常简单:
- 输入是负数 → 输出 0
- 输入是 0 → 输出 0
- 输入是正数 → 原样输出
你截图中的公式:
意思就是:在 0 和 a 之间,选择较大的那个数。
2. How — ReLU 在神经网络中怎样工作?
回到你看的手写数字识别案例。
假设一个隐藏层神经元正在处理图片信息。
这就是 ReLU 在一次前向传播(Forward Propagation)中的作用。
注意,ReLU 不会自己识别数字,也不会自己决定哪个特征重要。它只负责对当前神经元计算出的数值进行转换。
3. Why — 为什么神经网络需要 ReLU?
这里才是最值得理解的部分。
最重要的原因是:ReLU 为神经网络引入非线性(Nonlinearity)。
假设一个神经网络有很多层,但每层只进行乘法和加法,没有任何非线性激活函数。
那么,无论堆叠多少层,最终都可以简化成一个线性变换。
这样就很难学习复杂的模式。
例如:
- 一条直线可以表达简单的线性关系。
- 多个带有 ReLU 的神经元组合起来,可以形成分段线性的复杂关系。
- 多层网络进一步组合这些关系,就能学习复杂的图像模式。
ReLU 还有一些实际优点:正数区域梯度不会像 Sigmoid 饱和区域那样趋近于零,且计算简单,因此长期以来广泛用于深度神经网络的隐藏层。
4. ReLU、Sigmoid、Softplus 到底有什么区别?
这三种函数你在两个视频里都见过了。
函数 | 输入 -2 时 | 输入 2 时 |
ReLU | 0 | 2 |
Sigmoid | 0.119 | 0.881 |
Softplus | 0.127 | 2.127 |
你可以把它们理解为三种不同的数值转换规则。它们都能引入非线性,但输出范围、梯度特性和适用场景不同。
尤其要纠正一个容易产生的误解:截图中写的 Inactive 并不意味着神经元被物理关闭或者永久失效,而是它对当前这次输入输出了 0。
5. 检查一下你是否理解了
最后,把 ReLU 放回你正在学习的整个神经网络框架:
Weight 和 Bias 决定计算出什么数值 → ReLU 决定如何转换这个数值 → Activation 将转换结果传递到下一层。
这就是它的 What、How 和 Why。
损失曲面
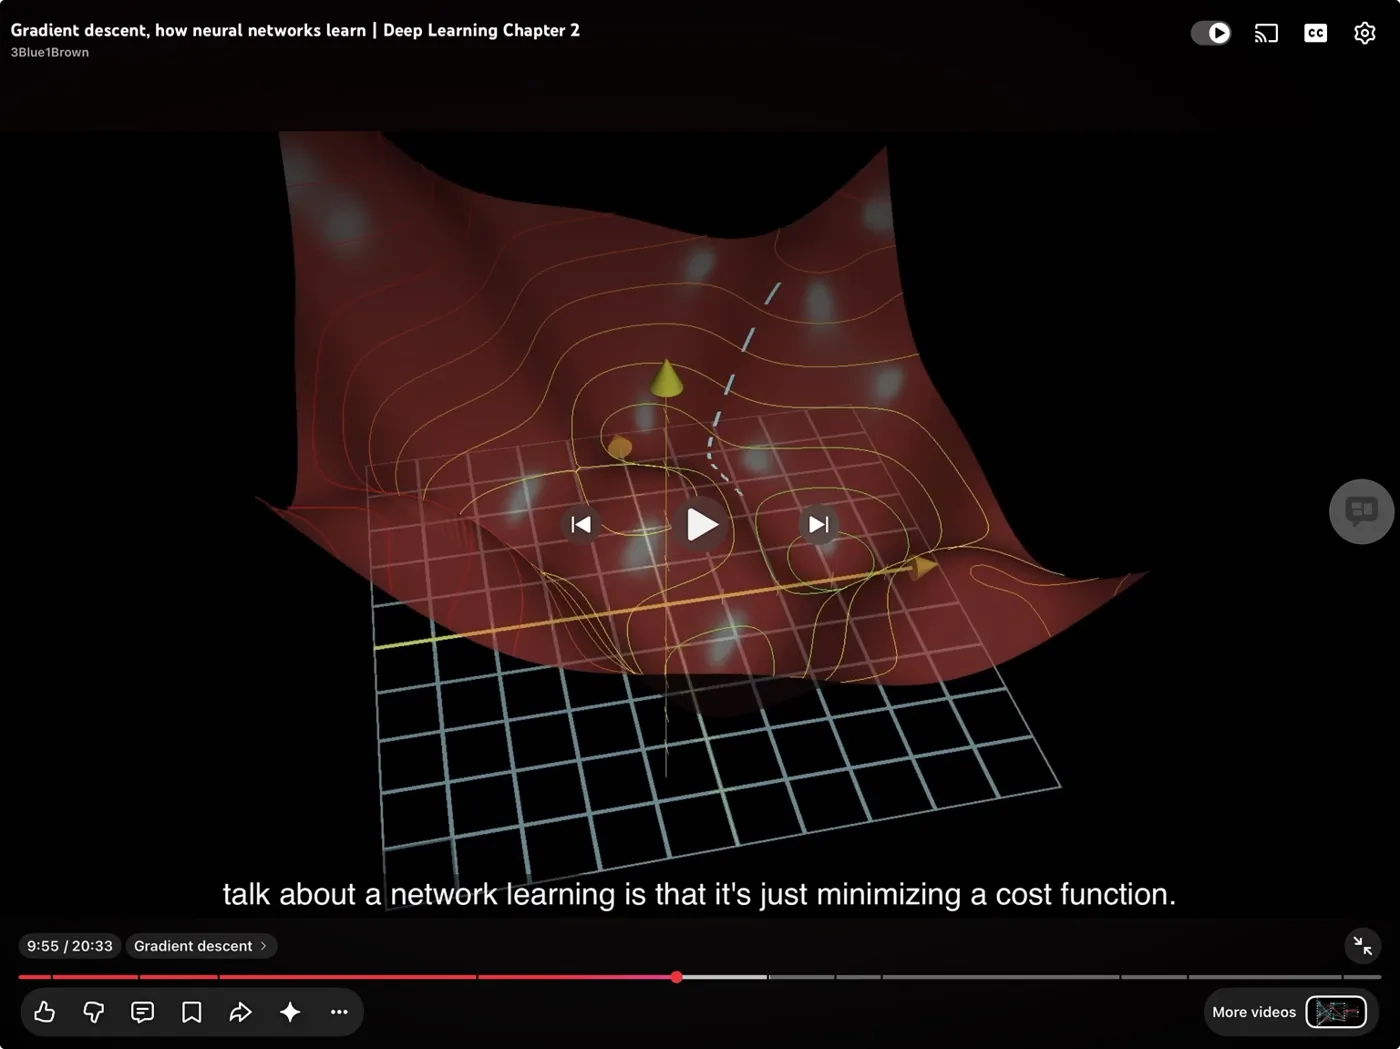
这张图其实把你之前在 StatQuest 学到的 Weight、Bias、Backpropagation 和 Gradient Descent(梯度下降) 联系起来了。
你现在看到的是 3Blue1Brown 第二章里一个很重要的概念:
神经网络的学习过程,可以理解为不断调整参数,让预测错误越来越小。
1. What — 这张三维曲面是什么?
它叫做 Cost Surface(损失曲面),也可以理解为一张“错误程度的地形图”。
想象你站在山坡上:
- 山顶:Cost 很高,模型预测不准确。
- 山谷:Cost 较低,模型预测更准确。
- 你的任务:找到尽可能低的位置。
2. How — 神经网络怎样走到谷底?
它使用 Gradient Descent(梯度下降)。
每一步其实只需要理解三个动作:
- 计算坡度:当前位置往哪个方向走,Cost 会下降?这需要 Gradient(梯度)。
- 调整参数:改变 Weight 和 Bias。
- 重新计算 Cost:看看预测是否改善,然后重复。
3. Why — 为什么要这样做?
因为神经网络刚开始通常不知道什么样的 Weight 和 Bias 能够正确识别图像。
例如识别手写数字 3:
最初模型可能错误地预测为 8。训练时,它会比较预测结果和正确答案,计算 Cost,然后根据梯度调整参数。
重复许多次后,模型通常就能更准确地识别数字。
这里还有一个你之前不太理解的区别:
| 概念 | 负责什么 |
|---|---|
| Forward Propagation | 根据当前参数计算预测结果 |
| Cost Function | 衡量预测有多错误 |
| Backpropagation | 高效计算 Cost 对各个参数的梯度 |
| Gradient Descent | 利用梯度更新参数,尝试降低 Cost |
Backpropagation 负责告诉模型参数应该如何调整,Gradient Descent 负责实际执行调整。
这也是为什么你之前看到的复杂偏导数公式,与这张直观的山谷图其实是在讲同一套训练过程。
你现在不必掌握那些偏导数的计算。对于建立 AI Literacy,现阶段最重要的是理解:
神经网络不是直接被告知每个 Weight 应该是多少,而是通过预测、计算误差、求梯度和更新参数,逐步学习合适的参数。
另外,这张图中的谷底不一定只有一个;实际神经网络的高维损失曲面非常复杂,梯度下降也不保证找到全局最低点。
0.97 与准确率
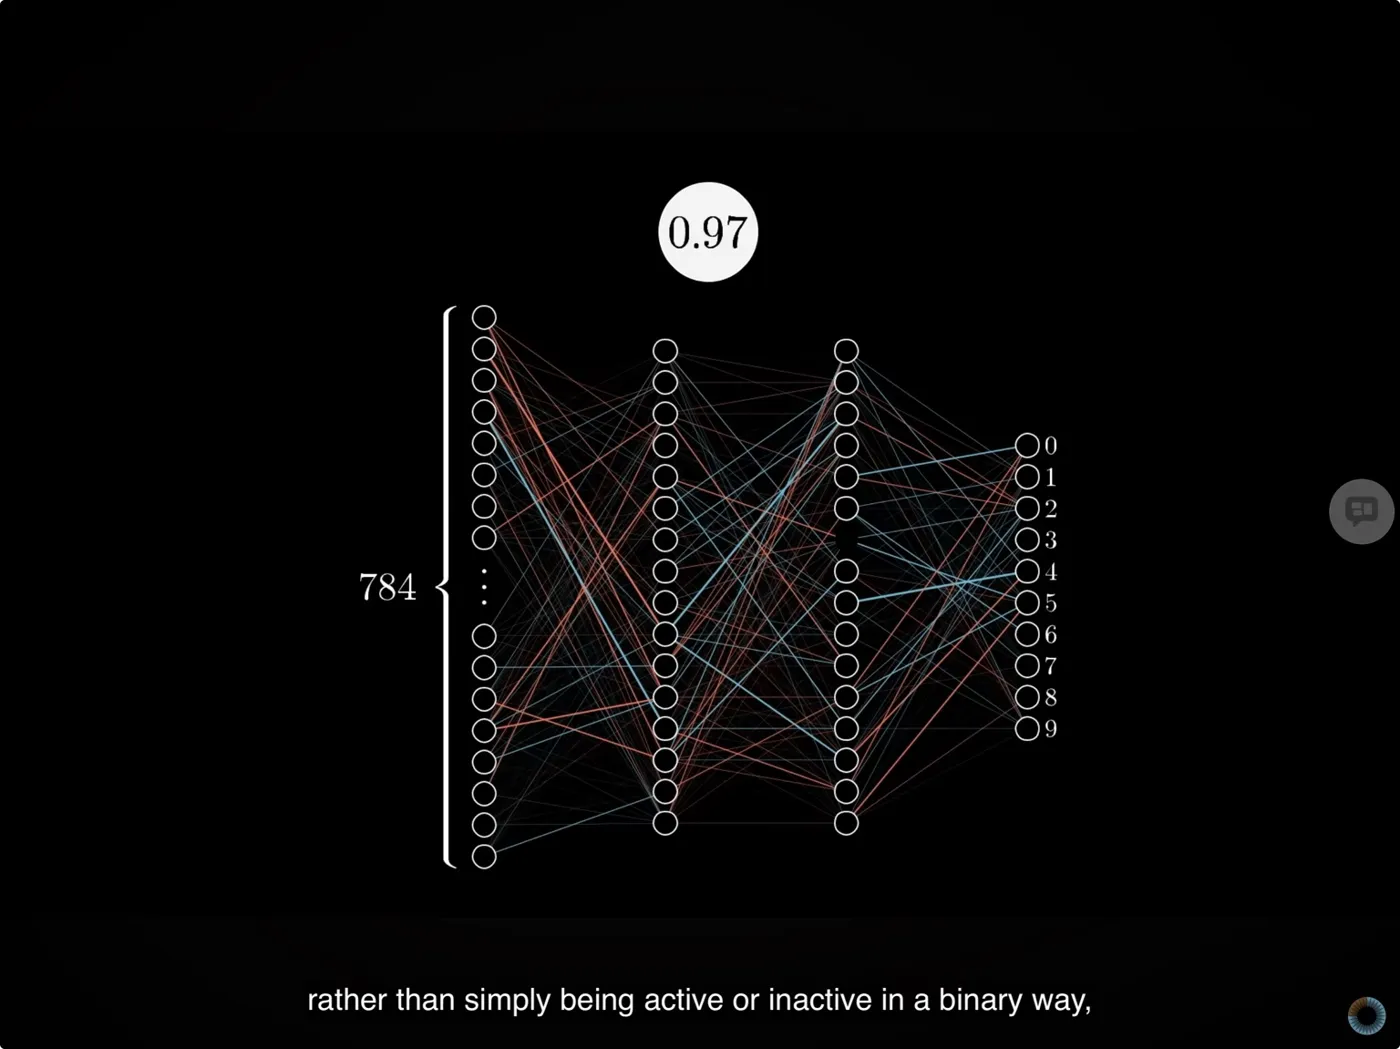
我再问一下,这个圆圈里的数字和之前很多圆圈里的数字是一个东西,对吧?我也忘了这到底是用来干嘛的。之前说的,你跟我说不是准确度,我印象中。
对,你记得基本正确!这张图里的 0.97 和之前神经元圆圈里的 0.58,都是 Activation(激活值)这一类数值。
而且你记得我之前强调过:Activation 不等于 Accuracy(准确率)。
不过这里有一个重要区别:它们所处的位置不同,因此代表的含义也可能不同。
1. What — 这些数字究竟是什么?
回到你之前看的 3Blue1Brown 视频:
同样是 0 到 1 的数字,却可以有不同含义:
| 所在位置 | 数字表示什么 |
|---|---|
| 输入层 | 像素有多亮 |
| 隐藏层 | 某个神经元的响应程度 |
| 输出层 | 模型对某个数字类别的输出响应 |
这里的 0.97 在截图中是一个示意激活值。不能仅凭 0.97 就判断模型有 97% 的准确率,也不能直接认定它是 97% 的概率。 是否能解释为概率,取决于输出层的设计和处理方式。
2. How — 这些 Activation 是怎么产生的?
例如识别手写数字 3:
假设数字 3 对应的神经元输出 0.97,而且它是十个神经元中最高的。
模型就可以根据这个结果判断:这张图片最可能是数字 3。
3. Why — 为什么需要 Activation?
因为神经网络需要一种方式,把输入的信息转换成下一层可以使用的数值。
这些数值有两个主要作用:
- 传递信息:前一层的 Activation 成为后一层计算的输入。
- 帮助做出预测:最终输出层的 Activation 可以用于判断图片属于哪个数字。
而你之前学习的 ReLU、Sigmoid、Softplus,就是用来计算神经元 Activation 的函数(输入层的原始像素值除外)。
4. 最容易混淆的三个概念
| 概念 | 通俗解释 |
|---|---|
| Activation | 一个神经元当前输出多少 |
| Confidence / Probability | 模型对某个预测有多大把握(需要合适的概率解释) |
| Accuracy | 模型在一批有正确答案的数据上预测对了多少 |
例如:
模型对一张数字 3 的图片输出 0.97,不代表它的准确率是 97%。
如果模型测试了 100 张图片,正确识别其中 92 张,才可以说它在这批测试数据上的 Accuracy 是 92%。
一句话记忆:Activation 是神经元传递和处理信息的数值,不是模型整体的准确率。
我想用一个小问题确认你是否理解:
假设某个神经网络识别一张手写数字图片,数字 3 的输出神经元 Activation 是 0.97,但实际图片是数字 8。
你觉得这个 0.97 说明什么?
答题追问
我的答案是 B,请解释为什么。
你的理解是对的。Activation = 0.97 表示数字 3 对应的输出神经元有很高的激活值,但不代表模型预测正确。
我们用刚才的例子解释。
1. 模型实际发生了什么?
假设我们输入一张手写数字 8 的图片,神经网络产生了以下输出:
2. 为什么 0.97 不等于 97% Accuracy?
因为它们回答的是不同的问题。
Activation: 这个神经元对当前输入产生了多大的输出?
Accuracy: 模型在一批测试数据中,预测正确的比例是多少?
模型完全可能产生很高的输出激活值,却做出错误预测。
3. 这和你之前学的 Backpropagation 有什么关系?
恰好形成了完整的学习循环:
注意:这不保证下一次一定预测正确,而是通过大量样本和反复训练,逐步改善模型表现。
你现在可以把之前学的几个概念连接起来了:Activation 参与产生预测,Loss 衡量错误,Backpropagation 计算梯度,Gradient Descent 更新参数。
这四个概念之间的关系,比单独记住任何一个公式都重要。
Sigmoid 与 Activation
activation得出的数值是signoid计算的吗?我记得它输出0-1
对!你记得很准确。Sigmoid 是一种 Activation Function(激活函数),它确实会把输入转换成 0~1 之间的数值。
但有一个重要区别:
Activation(激活值)不一定由 Sigmoid 计算,也可以由 ReLU、Softplus 等其他激活函数计算。
1. Sigmoid 是怎样计算 Activation 的?
例如:
- 输入 -5 → Activation ≈ 0.007
- 输入 0 → Activation = 0.5
- 输入 5 → Activation ≈ 0.993
2. 那 ReLU 和 Softplus 呢?
这是你在 StatQuest 视频中见过的三种函数:
| Activation Function | 输出范围 | 特点 |
|---|---|---|
| Sigmoid | 0~1 | S 形曲线 |
| ReLU | 0~∞ | 负数变 0,正数保持不变 |
| Softplus | 大于 0 | 平滑版本的 ReLU |
所以 Activation 是计算出来的结果,Activation Function 是计算这个结果所使用的规则。
3. 回到 3Blue1Brown 的 0.97
在你观看的手写数字识别示例中,3Blue1Brown 使用 Sigmoid 来解释神经元的激活过程。
因此,隐藏层或输出层的某个神经元可以这样计算:
例如 Sigmoid 的输入约为 3.48,就会得到 Activation ≈ 0.97。
但这仍然不代表模型有 97% 的 Accuracy。
你可以这样记忆:
Weight 和 Bias 决定送进激活函数的数值,Sigmoid 等激活函数决定如何转换它,Activation 则是转换后的输出,并传递给下一层。
这也正好解释了为什么视频里每个神经元都可以显示一个数字。
负梯度向量
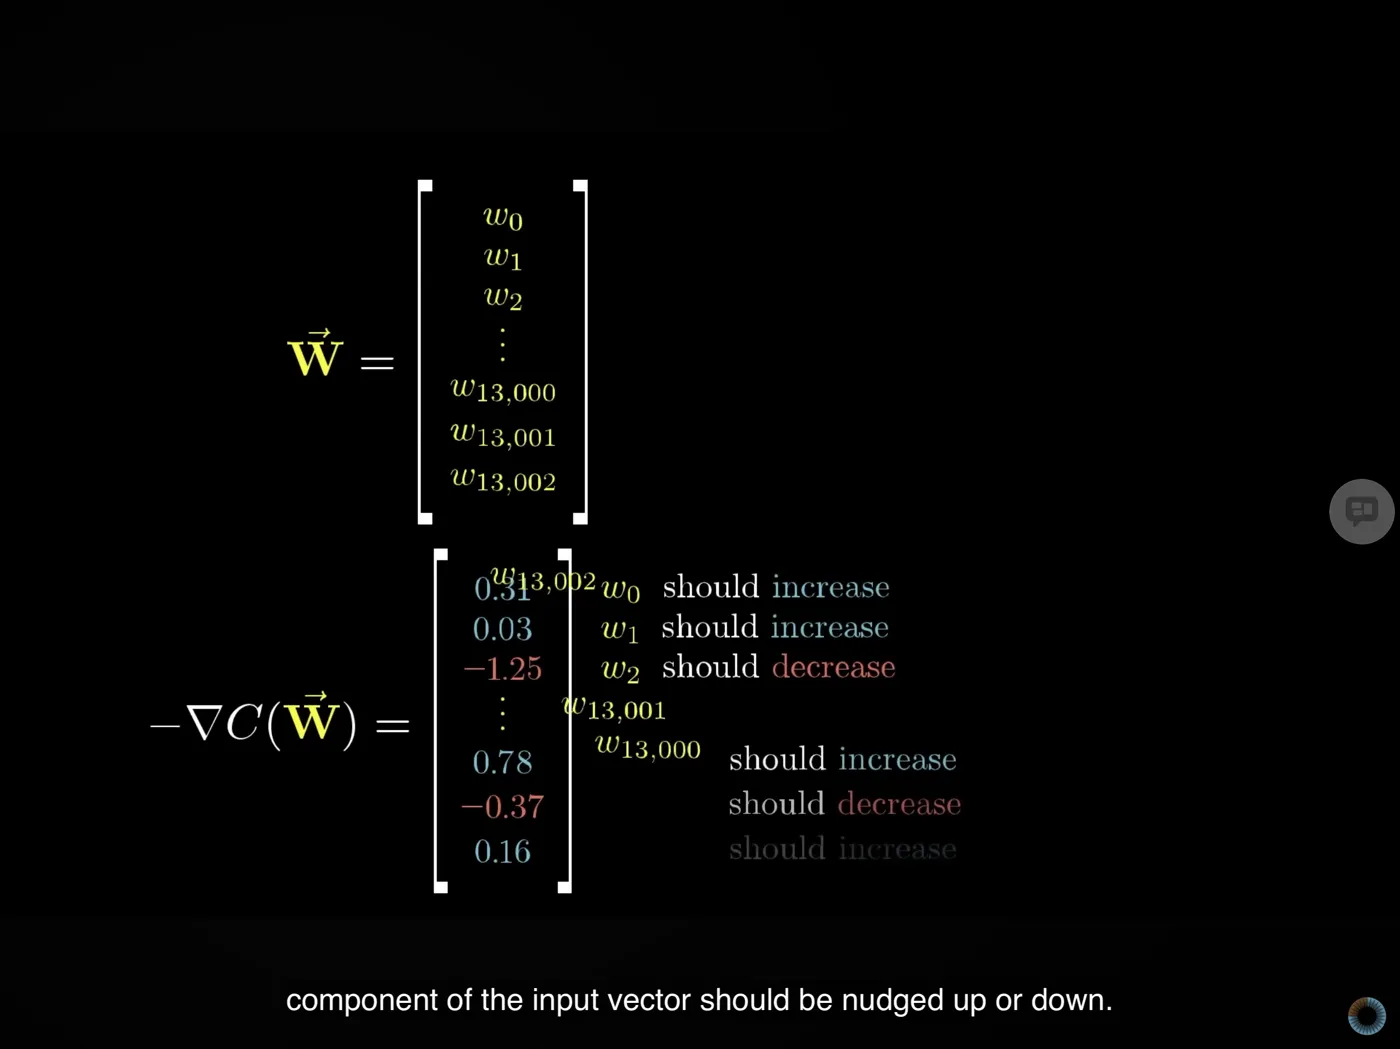
啥意思
这张图其实是在解释你之前看到的 Gradient Descent(梯度下降)到底如何调整神经网络中的 Weight(权重)。
之前你看到的是一座三维山谷,现在视频把山谷上的“下坡方向”变成了一长串数字。
我们按照 What → How → Why 来理解。
1. What — 图中的两组数字是什么?
- 上面那组 :神经网络中当前的权重参数。
- 下面那组 :负梯度(Negative Gradient),告诉我们怎样调整各个权重,才能在局部降低 Cost。
你看到的 13,002,表示这个示例中有大量需要调整的权重,而不是只有两三个。
2. How — 这些数字怎样改变 Weight?
我们用图中三个数值演示。
权重 | 负梯度 | 更新后 |
w₀ | +0.31 | 1.031 |
w₁ | +0.03 | 1.003 |
w₂ | -1.25 | 0.875 |
例如:
- +0.31:第一个权重应该增加。
- +0.03:第二个权重也应该增加,但方向上的调整幅度较小。
- −1.25:第三个权重应该减小。
注意,截图中的 +0.31 并不是说 Weight 必须直接增加 0.31,还要乘上 Learning Rate。
3. Why — 为什么需要一长串数字?
还记得之前的山谷图吗?
如果只有两个 Weight,我们可以画出一张三维曲面,直观地看到往哪里走。
但是如果有 13,002 个 Weight,就相当于在 13,002 维的参数空间中寻找降低 Cost 的方向。
人类无法直接画出这样的空间,但数学可以计算。
所以这组负梯度向量,本质上就是:
一份包含 13,002 个调整方向和相对幅度的清单。
4. 它和 Backpropagation 的关系
这里是最重要的连接:
这也解释了你前面一直不理解的偏导数公式:它们是在计算这些梯度分量,而不是直接计算神经元的 Activation。
一句话总结:之前的山谷图告诉你神经网络为什么要往下走;这张图告诉你,当神经网络有成千上万个参数时,怎样用一组数字确定往哪个方向走。
你现在不需要记住 ∇ 的数学运算,只要知道它叫 Gradient(梯度),表示 Cost 对各个参数变化的敏感程度,就足够继续看这一章了。
平台同步讨论
我在 Codex 对话里面让它开发了一个学习平台,记录我们之间的问答,把你给我深深的答案放到这个平台网站平台上面,方便我后面复习。但是目前需要我在这个对话截图,然后发给另一个对话,它才能开发。有什么方法让你们之间协作,不需要我一点点截图。
可以,而且我认为你现在应该改变工作流程了。你不应该继续充当两个 AI 对话之间的“信息搬运工”。
你目前实际上有两个工作空间:
- ChatGPT(当前对话):负责 AI 知识学习、解释、互动演示、测验,以及根据你的理解程度不断调整教学内容。
- Codex(另一个对话):负责开发你的 AI Learning Atlas 学习平台,把这些内容变成可以长期保存、检索和复习的网页。
你想实现的是:
关键是让两个 AI 使用同一个内容来源,而不是依赖截图传递信息。
不过要区分两个问题:一个是如何迁移你过去已经积累的大量问答,另一个是以后如何自动同步新的问答。这两个问题的解决方案并不完全一样。
我建议你分两个阶段实施
| 方案 | 能解决什么 | 自动化程度 | 推荐 |
|---|---|---|---|
| A. 导出 ChatGPT 历史记录 | 批量迁移过去的问答 | 一次性批量 | 现在就做 |
| B. GitHub 共享内容库 | Codex 读取、管理学习模块 | 半自动 | 最适合当前项目 |
| C. OpenAI API + 数据库 | 以后直接在平台学习并自动保存 | 高 | 第二阶段 |
第一阶段:先把过去的内容迁移进去
你可以从 ChatGPT 的 Settings → Data Controls → Export Data 导出历史记录。
导出文件通常包含 conversations.json,Codex 可以编写脚本解析它,提取你在神经网络、Activation、ReLU、Backpropagation、Gradient Descent 等主题下的学习问答。
需要注意:这种导出不等于网页完整复刻。尤其是交互组件、复杂图表和部分媒体,需要单独转换或重新实现。
我建议 Codex 保存两个版本:一个是完整的原始问答,另一个是适合学习平台展示的结构化模块。这样既保留你的学习过程,又能避免页面变成冗长的聊天记录。
第二阶段:以后不再需要截图
长期来看,最适合你的方式是把学习体验逐步迁移到 AI Learning Atlas 本身。
在平台中:
- 你向 AI Tutor 提问。
- OpenAI API 生成解释、示例和测验。
- 平台自动保存问答与学习进度。
- Codex 负责开发和维护展示组件,而不需要每次手动接收内容。
你目前使用的 GitHub + Vercel 架构可以支持这种方式,不一定需要购买传统服务器。但如果要保存用户数据,仍然需要数据库或其他持久化存储,并且 API Key 应保存在服务端环境变量中。OpenAI API 也与 ChatGPT 订阅分开计费。
**有一个关键限制:**目前这个 ChatGPT 对话不会因为你在 Codex 中开发了网站,就自动把每条新回答推送到 GitHub。ChatGPT 的历史对话也不能直接当作一个可供 Codex 持续读取的实时 API。因此,短期通过导出迁移,长期在自己的平台内记录,是更可靠的方案。
现在可以先给 Codex 这个任务
I want to eliminate the manual screenshot workflow between my ChatGPT learning conversations and AI Learning Atlas.

First, inspect the existing project architecture without modifying the current UI.

Design a content ingestion pipeline that can import my ChatGPT data export (`conversations.json`) and transform selected learning conversations into structured, reusable learning modules.

Requirements:
- Preserve original questions and answers.
- Extract concepts, explanations, examples, formulas, quizzes, and source references.
- Preserve the original conversation order and links between follow-up questions.
- Keep raw source content separate from edited learning modules.
- Handle images and interactive content gracefully when they cannot be directly reconstructed.
- Prevent duplicate imports.
- Store content in a format compatible with the existing GitHub/Vercel architecture.
- Propose a future API-based workflow where new AI Tutor conversations are automatically saved inside the platform.

Do not implement yet. First provide an architecture proposal, data schema, migration plan, limitations, and the smallest viable implementation.
最后我想确认一个会影响架构选择的问题:
你希望以后主要在哪里学习?
这个选择很重要,因为它决定我们需要的是一个对话同步工具,还是一个真正具备 AI Tutor 和学习记录能力的 AI-native Learning Platform。
Module 1 要带着哪些问题
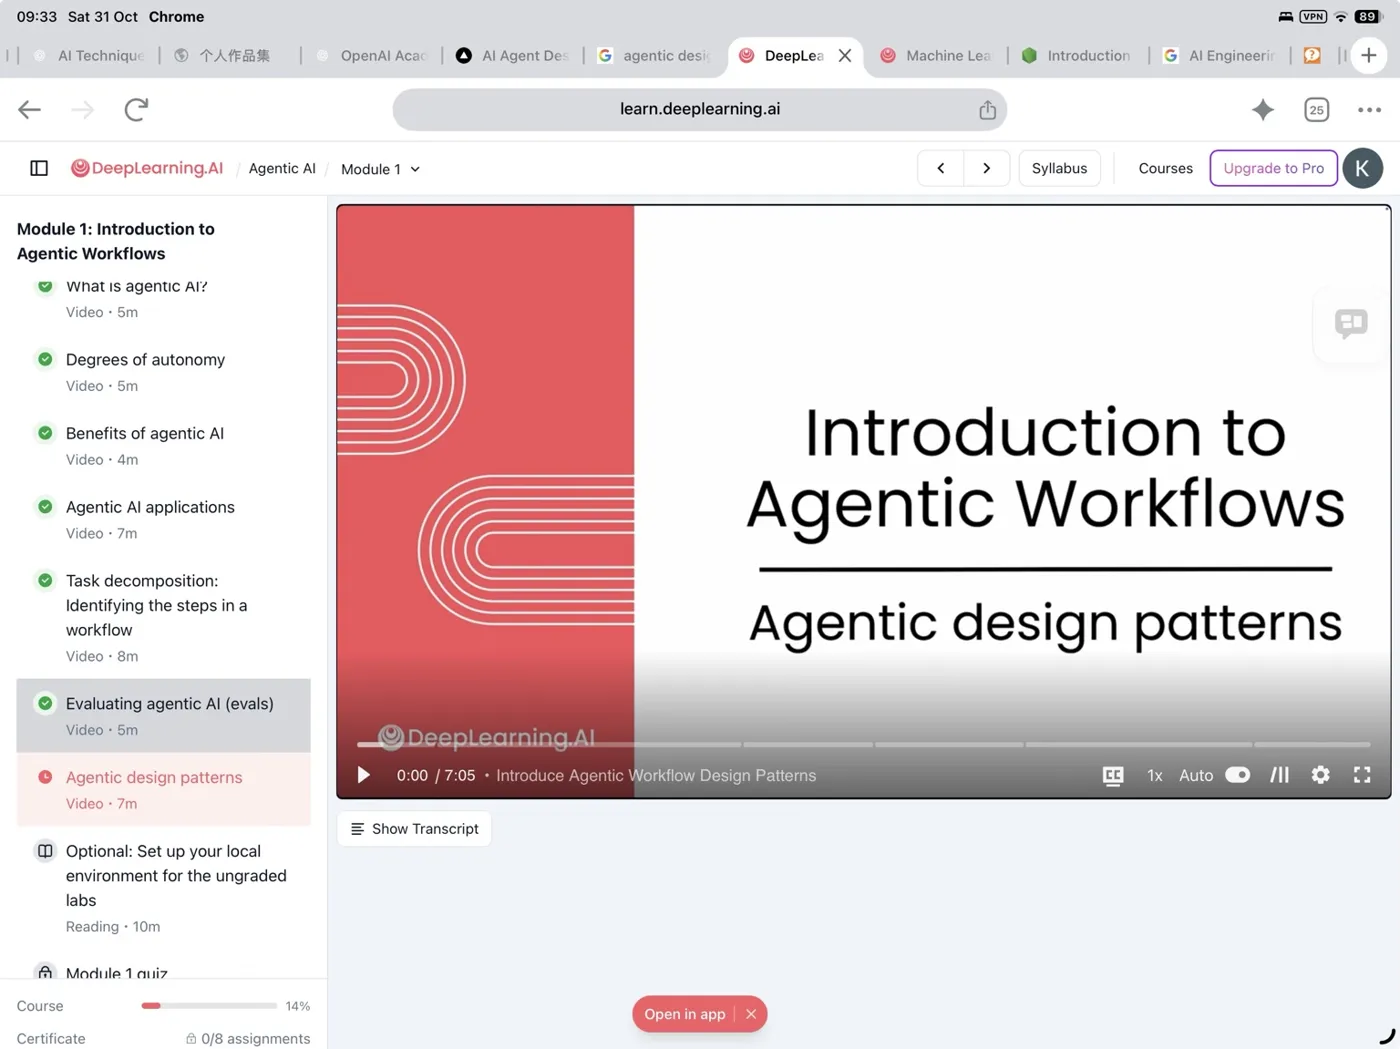
看完这一模块的视频,我需要带着哪些问题,看完之后能够解答。 也就是说我需要掌握哪些知识点。
你现在看到的是 DeepLearning.AI 的 Agentic AI — Module 1: Introduction to Agentic Workflows,具体正在学习最后一个视频 Agentic Design Patterns(智能体设计模式),时长约 7 分钟。
我建议你不要以“记住视频讲了哪些概念”为目标,而是以看完后能解释 What、Why、How,并且能判断实际产品应该如何使用这些模式为目标。
截图没有提供视频的完整讲稿,所以下面是根据该主题及常见的 Agentic AI 设计模式整理的学习目标,而不是对视频内容的逐字总结。
一、看视频前,先带着这 5 个问题
二、重点理解四种常见设计模式
三、用你自己的项目检验是否真正理解
假设你要让 AI Learning Atlas 自动生成一个关于 ReLU 的学习模块。
用户只需要输入:
帮我制作一个 ReLU 学习模块,包含概念解释、互动图表和三道测试题。
你能不能解释,AI 如何使用 Planning、Tool Use 和 Reflection 来完成这个任务?
这是一个很好的检验方式,因为你不仅需要知道术语,还要理解它们如何变成真实的产品行为。
四、看完后做一个小测试
- 一个 AI 写完代码后,自动检查运行错误并尝试修复。最直接体现哪种模式?
- AI 要查询数据库里的学习进度,应该使用什么能力?
- 一个简单的文本分类任务,是否一定需要多个 Agent?
**我的建议:**看完这节视频,你不需要记住所有设计模式的技术实现。以你目前从 Product Design 向 AI Builder / Design Engineer 学习的阶段,最重要的是能够回答:
“面对一个 AI 产品需求,我为什么要采用某种 Agentic Pattern?它如何运作?比简单调用一次 LLM 多解决了什么问题?”
如果你能结合 AI Learning Atlas 给出一个完整例子,就说明这节课的核心知识已经开始转化成你的实际能力了。
Module 1 的完整知识框架
我指的是这一系列Module 1。
明白,你指的是整个 Module 1: Introduction to Agentic Workflows,而不是最后一节 Agentic Design Patterns。
从截图来看,这个 Module 1 包含 7 节视频、1 节可选的环境配置阅读和最后的 Quiz。
我建议你把整个模块的学习目标设为:
理解 Agentic AI 是什么、为什么需要它、它能自主到什么程度、如何设计工作流程,以及如何判断它是否真正有效。
一、Module 1 完整知识框架
根据截图中的课程目录,下面是每节课应该带着的问题,以及学完后需要具备的理解能力。
| 课程 | 看完后应该能够回答的问题 |
|---|---|
| 1. What is agentic AI? | 什么是 Agentic AI?它和普通 LLM Chatbot、传统自动化有什么区别? |
| 2. Degrees of autonomy | AI 的自主性有哪些程度?哪些步骤由 AI 决定,哪些由人决定? |
| 3. Benefits of agentic AI | 为什么需要 Agentic AI?它相较单次 LLM 调用有什么优势和代价? |
| 4. Agentic AI applications | 哪些实际任务适合 Agentic AI?如何判断某个产品是否真的需要 Agent? |
| 5. Task decomposition | 如何把一个复杂目标拆解成可以执行、检查的多个步骤? |
| 6. Evaluating agentic AI (evals) | 如何评估 Agent 是否完成任务?除了最终答案,还应该检查什么? |
| 7. Agentic design patterns | 什么是 Agentic Design Pattern?如何选择合适的工作流程结构? |
以上问题是根据课程标题整理的学习目标,并非视频原文中的完整知识清单。
二、我认为你必须掌握的 5 个核心能力
三、Module 1 学完后的综合测试
我建议你用一个实际场景检验自己,而不是单纯记忆术语。
**场景:**你想为 AI Learning Atlas 开发一个 AI Tutor。用户问一个机器学习问题,系统可以理解问题、查找课程材料、生成解释、检查答案质量,并根据用户反馈调整讲解。
四、学到什么程度就可以进入 Module 2?
对于你目前的学习目标,我建议分三个层次:
- **Level 1 — Understand:**能解释概念及其作用,这是 Module 1 必须达到的程度。
- **Level 2 — Apply:**能针对一个真实产品画出简单的 Agentic Workflow,这是我建议你额外达到的程度。
- **Level 3 — Build:**能通过代码、工具调用和评估机制实现完整 Agent,这是后续模块和实践项目可以继续学习的内容。
**最终标准:**你不需要在 Module 1 就掌握 Agent 的底层代码,但应该能够独立回答:
“我有一个产品需求,是否应该使用 Agentic AI?为什么?如果要用,我该如何组织它的任务、自主性和评估方式?”
如果你能清楚回答这个问题,Module 1 就达到了一个很扎实的学习目标。
主观任务怎样评估
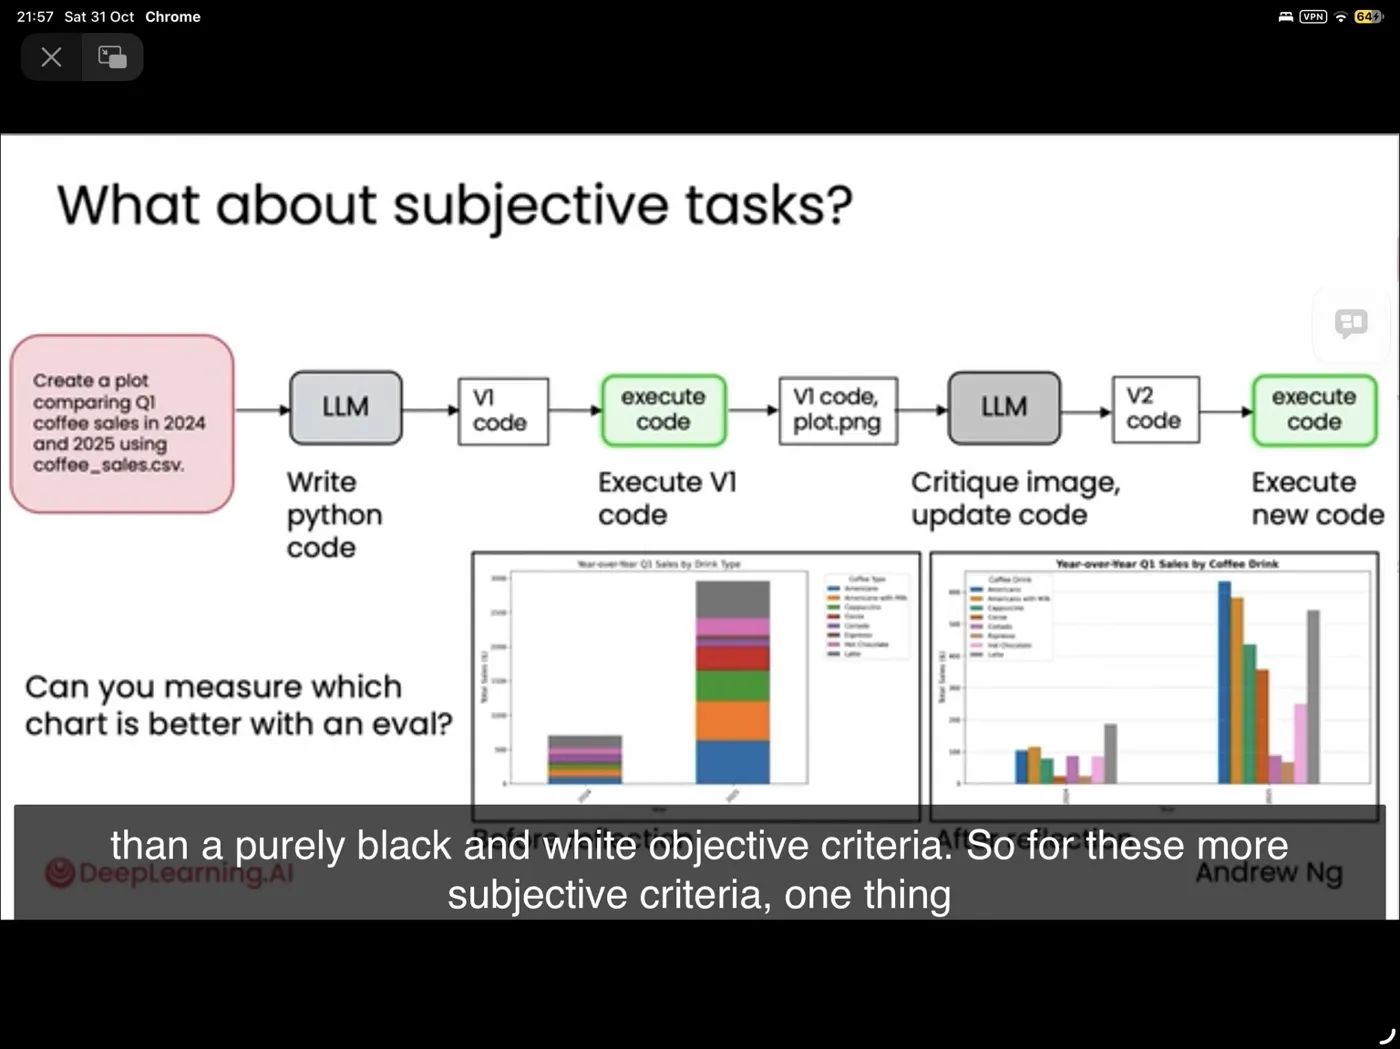
分析这张图
这张图来自吴恩达的 Agentic AI — Evaluating Agentic AI(Evals) 课程。
它讨论了一个很重要的问题:
当 AI 完成的任务没有唯一正确答案时,我们应该如何评估它的表现?
这与你熟悉的产品设计评审很接近,因为很多设计问题并不是简单的对或错。
一、What:这张图在讲什么?
图中展示了一个 AI Agent 自动生成数据可视化,并对自己的结果进行改进的过程。
这个流程体现了你在前面学习过的 Reflection(反思与迭代) 模式。
AI 不只是生成一次结果,而是可以检查结果,再进行改进。
二、Why:为什么这里要讨论 Subjective Tasks?
截图里展示了两个图表:
两张图可能都能正确展示数据,但哪张更好?
这取决于评估目标。
- 如果要比较两个年份的总销量,V1 可能更直观。
- 如果要比较不同咖啡品类的年度变化,V2 可能更合适。
所以,图表的正确性可以相对客观地验证,但图表的可读性、适用性和视觉质量具有一定主观性。
这就是截图中的核心问题:
Can you measure which chart is better with an eval?
能不能用一个评估机制,判断哪张图更好?
三、How:如何评估这种主观任务?
这里需要区分两类 Evals。
| 评估类型 | 判断什么 | 例子 |
|---|---|---|
| Objective Evals(客观评估) | 是否满足明确、可验证的条件 | 代码能否运行?数据是否正确?文件是否生成? |
| Subjective Evals(主观评估) | 结果在多大程度上满足质量标准 | 图表是否清晰?是否易于比较?视觉层级是否合理? |
主观任务不意味着无法评估。
我们可以把相对模糊的“好不好”,拆成更具体的评价维度。
例如,下面是我根据这个图表任务设计的一个示例评估表,并非视频给出的评分标准。
四、这与 AI Agent 有什么关系?
这是本节课最值得你理解的部分。
在普通软件中,我们经常能用确定的条件测试功能是否成功。
例如:点击按钮 → 下载文件 → 检查文件是否存在。
但 Agentic AI 可能要执行更加开放的任务,例如:
“研究市场并生成一份高质量报告。”
报告生成了,不代表报告质量就好。
因此,Agentic Workflow 不仅需要:
Generate → Execute
还可能需要:
Generate → Execute → Evaluate → Improve
不过,Eval 不一定必须由另一个 LLM 完成。它可以是自动化测试、规则检查、LLM 评审、人类专家评价,或者这些方法的组合。
尤其要注意:AI 自己认为第二版更好,不等于第二版客观上一定更好。 评估标准本身也需要验证。
五、联系你的产品设计经验
你以前在做产品界面时,可能也经历过类似过程:
设计 V1 → 检查信息层级 → 发现可读性问题 → 修改为 V2。
现在 AI Agent 也可以执行一部分这样的迭代流程。
但你作为设计师,需要决定什么才算“更好”,例如:
- 是否减少认知负担?
- 是否提升任务完成效率?
- 是否符合产品的设计系统?
- 是否保持信息准确性?
这些标准可以成为 Agent 的评价依据,而不只是让它凭模糊的“美观程度”进行修改。
最后,用一道题检查理解
你在 Module 1 的 Evals 部分,最应该记住的一句话:
Evals are not just about whether an AI agent completes a task, but how well it completes it.
评估 Agent,不仅要看它有没有完成任务,还要看它完成得怎么样。
用 Rubric 评分
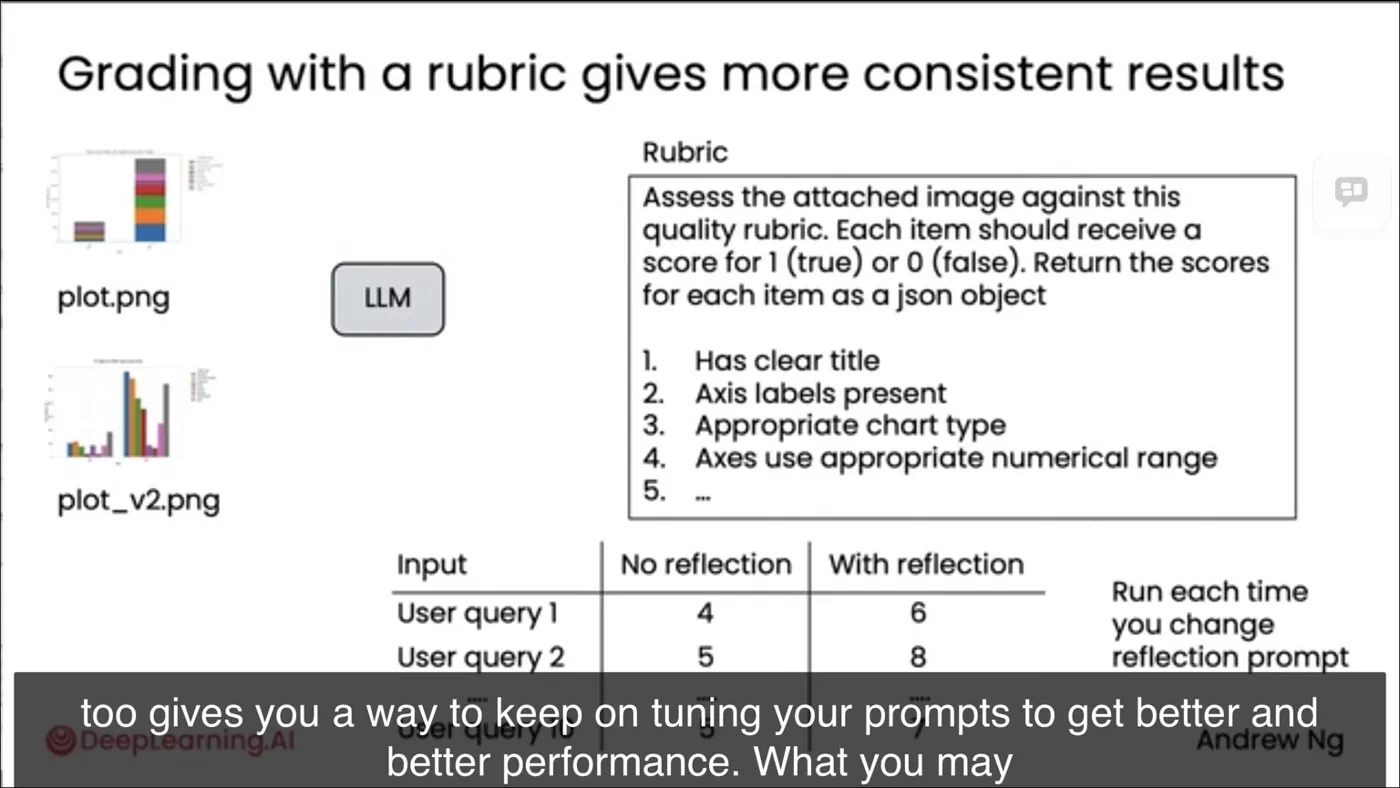
这张图其实是在回答你上一张截图留下的问题:
如果 AI 要评价一张图表好不好,怎样才能让它每次评价都有相对一致的标准?
吴恩达这里引入了一个重要概念:Rubric(评分量规 / 评价标准表)。
一、What:什么是 Rubric?
Rubric 是一套事先定义好的、可重复使用的评价标准。
比如,直接让 LLM 评价:
Is this chart good?(这张图表好吗?)
这个问题太模糊。LLM 可能第一次关注美观,第二次关注数据准确性,第三次又关注图表类型。
而截图中,吴恩达给 LLM 提供了明确的评价标准:
| Rubric 评价标准 | 含义 | 得分 |
|---|---|---|
| Has clear title | 图表有清晰的标题吗? | 0 或 1 |
| Axis labels present | X、Y 轴有标签吗? | 0 或 1 |
| Appropriate chart type | 图表类型适合任务吗? | 0 或 1 |
| Axes use appropriate numerical range | 坐标轴的数值范围合理吗? | 0 或 1 |
| ... | 其他评价标准 | 0 或 1 |
其中,1 代表满足标准,0 代表不满足。
这样,LLM 不再只是笼统地说“图表不错”,而是逐项检查。
二、How:Rubric 如何参与 AI Agent 的评估?
{
  "clear_title": 1,
  "axis_labels": 1,
  "appropriate_chart_type": 0,
  "appropriate_axis_range": 1
}这里还有一个值得理解的术语:LLM-as-a-Judge。
意思是让大语言模型充当评价者,而不只是内容生成者。
Rubric 是评价标准,LLM-as-a-Judge 是执行评价的一种方式。两者并不是同一个概念。
三、Why:为什么吴恩达强调 Consistency(一致性)?
因为 Agent 的评估应该尽量具有可重复性。
截图底部有一个比较表:
| 输入 | No Reflection | With Reflection |
|---|---|---|
| User Query 1 | 4 | 6 |
| User Query 2 | 5 | 8 |
这说明在展示的测试案例中,加入 Reflection 后,评分有所提高。
但这里有两个重要区别:
- Reflection 是 Agent 改进结果的机制。
- Rubric-based Eval 是衡量改进是否有效的机制。
因此,你可以修改 Reflection Prompt,再用同一套 Rubric 重新评估不同任务的结果。
这就是截图右下角所说的:
Run each time you change reflection prompt.
每次修改 Reflection Prompt,都重新运行评估。
不过,Rubric 只能帮助提高评价一致性,并不能保证 LLM 每次评分完全相同,也不能自动保证评分正确。
四、与你的设计工作有什么联系?
你可以把 Rubric 理解成一种可执行的设计评审标准。
例如,你用 Claude Code 开发 AI Learning Atlas 的学习页面,可以制定这样的 Rubric:
这样,你可以要求 Claude Code 每次修改页面后,不只是告诉你“已经完成”,还要依据这些标准进行检查。
当然,设计评价中还有一些难以完全量化的部分,比如整体视觉感受、产品语境与用户体验。它们仍然需要人工判断或更细致的评估方式。
五、你在这节课真正需要掌握什么?
我认为只需要记住三个关系:
Reflection = 改进机制
让 AI 检查、反思并修改自己的输出。
Rubric = 评价标准
定义什么样的输出才算好。
Eval = 评估过程
使用 Rubric 等标准和方法,衡量 Agent 的表现。
三者结合,就形成一个可以持续优化的 Agentic Workflow。
最后留给你一个理解题:
如果一个 Agent 的 Rubric 得分从 6 提高到了 9,是否就能证明这个 Agent 真的变得更好了?
答案是:不一定。 还需要判断 Rubric 是否合理、评分是否可靠,以及这些指标是否真正反映用户的目标。
这也是从“会使用 AI”走向“会设计和评估 AI 系统”非常关键的一步。
用工具帮助反思
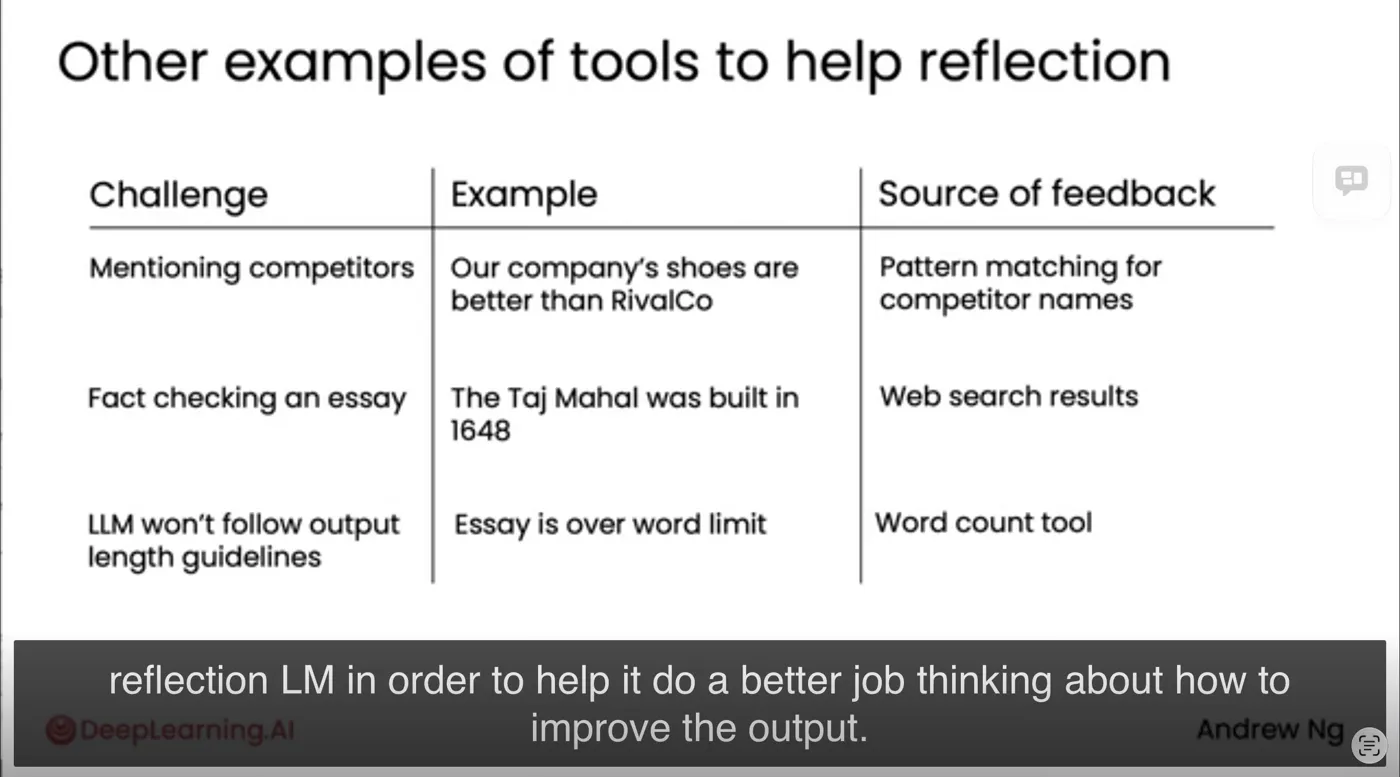
这张图是吴恩达在 Reflection(反思机制) 这一节的进一步延伸。
前面他讲的是:让 LLM 根据 Rubric(评分标准)评价自己的输出。
而这张图想表达的是:
Reflection 不一定只依赖 LLM 自己的判断,还可以借助外部工具提供更可靠的反馈(Feedback)。
一、What:这张图讲了什么?
截图展示了三种问题,以及可以帮助 AI 发现问题的工具。
| Challenge(问题) | Example(例子) | Source of Feedback(反馈来源) |
|---|---|---|
| 提到了竞争对手 | 我们公司的鞋子比 RivalCo 好 | 名称模式匹配 |
| 文章中的事实可能不准确 | 泰姬陵建于 1648 年 | 网页搜索结果 |
| LLM 不遵守字数限制 | 文章超过字数上限 | 字数统计工具 |
注意:第二行的 1648 年是一个需要核查的陈述,截图并没有证明这个年份正确。
二、How:工具如何帮助 Reflection?
以第三个例子为例,假设用户要求 AI 写一篇不超过 200 词的文章。
- LLM 生成文章
- Feedback
- Reflection & Revision
这里的 245 词是我为了说明流程举的例子。
最重要的区别是:
- 没有工具: LLM 自己判断文章是否超字数,可能不准确。
- 有工具: 字数统计工具提供明确的数字,LLM 再根据结果修改文章。
三、Why:为什么不能只让 LLM 自己 Reflection?
因为 LLM 并不擅长所有类型的检查。
例如,LLM 可以评价文章是否通顺,但如果要判断某个历史年份是否准确,就可能需要查询外部资料。
同样,LLM 可以判断图表是否容易理解,但如果要检查代码能不能运行,实际执行代码并读取错误信息通常更可靠。
因此:
LLM 负责理解反馈、决定如何修改;工具负责提供可验证的反馈信号。
不过工具本身也有局限。例如,网页搜索结果仍然需要核查来源的可信度,名称匹配也可能漏掉没有直接出现的竞争对手名称。
四、与上一张 Rubric 的关系
你可以这样建立知识框架:
| 概念 | 核心作用 |
|---|---|
| Reflection | 让 Agent 检查并改进自己的输出 |
| Rubric | 定义评价标准 |
| Eval | 衡量输出是否符合要求 |
| Tool Feedback | 通过外部工具提供检查依据 |
它们不是四个互相独立的步骤,而是可以组合起来使用。
例如,在你用 Claude Code 开发网站时,代码执行错误、TypeScript 检查、自动化测试结果都可以成为 Reflection 的反馈来源。AI 可以依据这些反馈修复代码,而不只是反复猜测问题。
五、检查一下你是否真正理解
这张图的核心知识点可以总结成一句话:
Reflection improves the output, while external tools provide evidence for what needs to be improved.
反思负责改进输出,外部工具则提供判断哪里需要改进的依据。